วิธีเพิ่มความเร็ว Local LLM ด้วย DGX Spark: เปรียบเทียบประสิทธิภาพ Ollama, SGLang และ Speculative Decoding

หากต้องการเพิ่มความเร็วให้กับ Local LLM บน DGX Spark การตั้งค่า Speculative Decoding (การอ่านล่วงหน้า) เพื่อเร่งการสร้างข้อความถือเป็นวิธีที่มีประสิทธิภาพที่สุด โดยผลการวัดจาก Coding Agent ของเราพบว่า เพียงแค่เพิ่มความยาวในการอ่านล่วงหน้า ก็สามารถลดเวลาที่ใช้ลงได้ประมาณ 20% เราได้ทดสอบรัน LLM ของ Coding Agent ที่เราสร้างขึ้นเองบนเครื่องที่เทียบเท่ากับ DGX Spark จำนวน 1 เครื่อง โดยเปรียบเทียบเวลาและผลลัพธ์จากการรันงานจริงผ่านการตั้งค่าทั้งหมด 8 รูปแบบ ซึ่งเป็นการผสมผสานระหว่าง Ollama, llama-server, SGLang และการอ่านล่วงหน้า นอกจากนี้ เรายังได้เปรียบเทียบ Quantization 3 รูปแบบ รวมถึงวิธีแก้ไขปัญหาที่ Prompt Cache ถูกลบไปโดยไม่รู้ตัวเมื่อมีการสนทนาที่ยาวนาน
เราได้รวบรวมข้อมูลนี้ไว้เพื่อให้เหล่านักพัฒนาที่ใช้ Local LLM บน DGX Spark หรือ Ollama สำหรับงาน Agent สามารถตัดสินใจเลือก Engine และการตั้งค่าที่เหมาะสมที่สุดได้ด้วยตัวเลขเชิงประจักษ์
สภาพแวดล้อมการทดสอบจริงของเรา: วัดผลอย่างไรด้วย DGX Spark 1 เครื่อง?

การวัดผลดำเนินการโดยติดตั้ง Inference Engine หนึ่งตัวต่อเครื่อง DGX Spark หนึ่งเครื่อง และรันงานการอ่านข้อมูลชุดเดียวกันชุดละ 3 ครั้งขึ้นไป เพื่อตรวจสอบระยะเวลาที่ใช้และความถูกต้องของคำตอบ
อุปกรณ์ เครื่องมือ และโมเดล
| รายการ | ค่า |
|---|---|
| อุปกรณ์ | MSI EdgeXpert MS-C931 (NVIDIA GB10, เทียบเท่า DGX Spark) |
| หน่วยความจำ | หน่วยความจำรวม 128GB (ระบบปฏิบัติการมองเห็น 121GB) |
| แบนด์วิดท์ (ตามสเปก) | 273GB/s |
| ระบบปฏิบัติการและอื่นๆ | Ubuntu 24.04.5 (aarch64), ไดรเวอร์ 580.178.04, CUDA 13.0 |
| เอนจิน | Ollama 0.40.4, llama.cpp b11617 (llama-server), SGLang v0.5.21 |
โมเดลที่ใช้มี 2 สายหลัก คือแบบ Dense ขนาด 27B ในตระกูล Qwen และแบบ MoE ของ Flash-Next
| ชื่อย่อ | รายละเอียด | ขนาด |
|---|---|---|
| 27B Q8_0 | GGUF ของ 27B แบบ Dense | 29.0GB |
| 27B Q6_K・Q4_K_M | GGUF จากแหล่งแจกจ่ายเดียวกัน (สำหรับเปรียบเทียบการทำ Quantization) | 22.4GB・16.8GB |
| 27B NVFP4 | 27B ที่ทำ Quantization โดยเน้น NVFP4 (เลเยอร์ MTP เป็น BF16) | ประมาณ 22GB |
| Flash-Next | GGUF ของ MoE (UD-IQ4_XS) | ฝั่ง GPU ประมาณ 67GB |
น้ำหนักของโมเดลทั้งหมดเป็นโมเดลที่ผ่านการทำ Quantization ซึ่งเผยแพร่โดยชุมชน สำหรับ 27B นั้น Ollama และ llama-server ใช้ Q8_0 ส่วน SGLang ใช้ NVFP4 ดังนั้นการเปรียบเทียบเอนจินจึงมีความแตกต่างของระดับ Quantization รวมอยู่ด้วย
งานจริงและวิธีการวัดผล
งานนี้คือการให้ AI สร้างรายการ API จากไฟล์ฝั่งเซิร์ฟเวอร์ไฟล์เดียวในเว็บแอปพลิเคชันที่กำลังทำอยู่ โดยเป้าหมายคือเราเตอร์ 47 ตัวที่เขียนด้วยคำสั่ง if ซึ่งเอเยนต์จะเรียกใช้เครื่องมือค้นหาและอ่านไฟล์เพื่อตรวจสอบเนื้อหา แล้วเขียนตาราง "เมธอด·พาธ·หมายเลขบรรทัด" ออกมา เป็นงานแบบอ่านอย่างเดียวที่ใช้เวลาประมาณ 10 ขั้นตอนต่อครั้ง
คำตอบจะถูกนำไปตรวจสอบกับตารางเฉลย (หมายเลขบรรทัดและเมธอด) โดยทำการทดสอบชุดละ 3 ครั้ง และส่งคำขอเดิมในบทสนทนาใหม่ทุกครั้ง ความยาวบริบทอยู่ที่ 262,144 ไม่มีการใช้โหมดการคิด (Thinking mode) และค่าการสุ่มตัวอย่าง (Sampling) ถูกตั้งไว้เท่ากันในทุกเอนจิน
เนื่องจากเอเยนต์นี้สื่อสารกับ LLM ได้ผ่าน API ของ Ollama เท่านั้น จึงต้องมีตัวกลาง (Proxy) ประมาณ 300 บรรทัดเพื่อแปลงรูปแบบคำขอและคำตอบก่อนส่งไปยัง llama-server ที่รองรับ OpenAI และ SGLang เนื่องจากรูปแบบการสนทนาของ 27B รองรับข้อความ system ได้เพียงข้อความเดียวที่ส่วนต้นเท่านั้น (หากมี 2 ข้อความขึ้นไปจะเกิด HTTP 500) ตัวกลางจึงทำหน้าที่รวมข้อความเหล่านั้นเข้าด้วยกันเป็นข้อความเดียว
ในการเปรียบเทียบความยาวของการอ่านล่วงหน้า (Lookahead) เพื่อไม่ให้ความแตกต่างของจำนวนขั้นตอน (8-16 ขั้นตอน) มากลบผลลัพธ์ เราจึงได้บันทึกคำขอ 11 รายการที่ประมวลผลเสร็จสิ้นตามปกติไว้ แล้วนำมาทดสอบซ้ำกับการตั้งค่าแต่ละแบบแบบละ 3 ครั้ง
ความเร็วในการสร้างผลลัพธ์คือตัวกำหนดเวลาสำหรับเอเจนต์
เอเจนต์จะส่งประวัติการสนทนาทั้งหมดกลับไปทุกครั้ง หากการนำอินพุตกลับมาใช้ใหม่ (Prefix Caching) ทำงานได้ดี ก็จะเหลืออินพุตที่ต้องประมวลผลใหม่เพียงเล็กน้อย จากบันทึกการทำงานของเรา 44 รายการ พบว่าจากอินพุตทั้งหมด 21.17 ล้านโทเค็น มีเพียง 9.3% เท่านั้นที่เป็นส่วนใหม่ และเวลาของโมเดลประมาณ 75% ถูกใช้ไปกับการสร้างข้อความ สำหรับงานในครั้งนี้ แม้ความแตกต่างของความเร็วในการรับอินพุต (600–1,070 tok/s) จะส่งผลต่อเวลาเพียงสิบกว่าวินาทีต่อครั้ง แต่ความแตกต่างของความเร็วในการสร้างข้อความ (20–38 tok/s) กลับส่งผลให้เวลาห่างกันถึงหลายสิบวินาทีหรือมากกว่านั้น
วิธีการเพิ่มความเร็วในการสร้างข้อความคือ Speculative Decoding ซึ่งในบทความนี้จะเรียกว่า "การอ่านล่วงหน้า" (Lookahead) โดยเป็นกลไกที่ร่างข้อความล่วงหน้าไปหลายโทเค็น แล้วให้โมเดลหลักตรวจสอบพร้อมกันในการคำนวณเพียงครั้งเดียว หากร่างที่เขียนไว้ไม่ถูกต้องก็จะถูกทิ้งไป ดังนั้นการกระจายตัวของผลลัพธ์จึงไม่เปลี่ยนแปลง ในครั้งนี้เราได้ทดลองใช้ MTP (Multi-Token Prediction) ซึ่งใช้เลเยอร์สำหรับการคาดการณ์ที่อยู่ในน้ำหนักของโมเดล และใช้ DSpark/DFlash2 ซึ่งเป็นโมเดลร่างแยกต่างหาก
ผลการทดสอบจริงของเรา: เครื่องมือและการคาดการณ์ล่วงหน้าแบบใดที่เร็วที่สุด?

ในด้านความเร็ว SGLang ที่ใช้ MTP (คาดการณ์ล่วงหน้า 8 โทเค็น) และ DFlash2 ครองอันดับหนึ่งร่วมกัน โดยมีค่ามัธยฐานของระยะเวลาที่ใช้ในการประมวลผลจนเสร็จสิ้นตามปกติอยู่ที่ 60.2 วินาที และ 62.5 วินาที ตามลำดับ ส่วน Ollama รุ่น 27B ก็สามารถลดระยะเวลาจาก 109.6 วินาที เหลือ 85.5 วินาทีได้ เพียงแค่เพิ่มการคาดการณ์ล่วงหน้าจาก 4 เป็น 12 เท่านั้น
การเปรียบเทียบทั้ง 8 รูปแบบ
นี่คือผลลัพธ์การเปรียบเทียบโดยคงความยาวของการอ่านล่วงหน้า (Lookahead) ไว้ตามการตั้งค่าเดิม (MTP คือ 4, DSpark/DFlash2 คือ 8)
| Engine/Lookahead | Model | เวลาที่ใช้ | tok/s ที่สร้างได้ | คำตอบสุดท้าย | ตารางถูกต้อง |
|---|---|---|---|---|---|
| SGLang・DFlash2 | 27B NVFP4 | 55.1・70.4 วินาที | 38.3 | 24.0 วินาที | 2/2 |
| SGLang・MTP | 27B NVFP4 | 70.9・73.5 วินาที | 34.8 | 33.6 วินาที | 2/3 |
| SGLang・DSpark | 27B NVFP4 | 85.7 วินาที | 28.6 | 38.9 วินาที | 2/2 |
| Ollama・MTP | 27B Q8_0 | 102.6〜119.2 วินาที | 23.6 | 45.7 วินาที | 3/3 |
| llama-server | Flash-Next | 103.3・137.1 วินาที | 24.8 | 49.8 วินาที | 2/2 |
| Ollama | Flash-Next | 112.8・115.6 วินาที | 20.1 | 65.2 วินาที | 3/3 |
| llama-server・MTP | 27B Q8_0 | 114.3・147.1 วินาที | 23.3 | 55.9 วินาที | 2/2 |
| llama-server・ไม่ใช้การอ่านล่วงหน้า | 27B Q8_0 | 249.1〜295.0 วินาที | 7.9 | 153.7 วินาที | 2/3 |
เวลาที่ใช้คือค่าของรอบที่เสร็จสิ้นตามปกติ ส่วน tok/s ที่สร้างได้คือค่ามัธยฐานจากการทดสอบ 3 ครั้ง สำหรับ "ตารางถูกต้อง" คือจำนวนครั้งที่หมายเลขบรรทัดและเมธอดของทั้ง 47 บรรทัดถูกต้องทั้งหมด
หากไม่ใช้การอ่านล่วงหน้า Flash-Next ของ MoE จะทำงานได้เร็วกว่า เนื่องจากน้ำหนักที่ต้องอ่านต่อ 1 โทเค็นมีขนาดเล็กเพียงประมาณ 5.8GB ทำให้ขีดจำกัดจากแบนด์วิดท์อยู่ที่ประมาณ 47 tok/s ในขณะที่รุ่น 27B Q8_0 แบบ Dense ต้องอ่านข้อมูลประมาณ 28.6GB ทุกครั้ง ทำให้ขีดจำกัดอยู่ที่ประมาณ 9.5 tok/s (วัดจริงได้ 7.9) แต่เมื่อใช้ MTP ซึ่งมีการคาดการณ์ที่แม่นยำ การเพิ่มการอ่านล่วงหน้าเข้าไปจึงทำให้ผลลัพธ์กลับมาเหนือกว่าได้
การเพิ่มระยะการคาดการณ์ล่วงหน้าช่วยให้เร็วขึ้นประมาณ 20%
เนื่องจาก MTP ทำงานได้เกือบเต็มขีดจำกัดที่ 4 โทเค็น ผมจึงเพิ่มความยาวของการอ่านล่วงหน้า (lookahead) แล้วรันคำขอเดิมซ้ำ 11 รายการ โดย MTP ของ SGLang จะมีขีดจำกัดสูงสุดอยู่ที่ 8 โทเค็น
| การตั้งค่า SGLang | การเรียกใช้เครื่องมือ | คำตอบแบบยาว | เวลาในการสร้าง 1 ครั้ง (คำนวณ) |
|---|---|---|---|
| MTP 4 | 36.0 tok/s | 31.9 tok/s | ประมาณ 52 วินาที |
| MTP 8 | 54.3 tok/s | 44.5 tok/s | ประมาณ 37 วินาที |
| MTP 12 | 61.5 tok/s | 43.7 tok/s | ประมาณ 35 วินาที |
| DFlash2 | 31.4 tok/s | 46.8 tok/s | ประมาณ 45 วินาที |
เวลาในการสร้าง 1 ครั้ง เป็นค่าที่คำนวณโดยนำการเรียกใช้เครื่องมือประมาณ 700 โทเค็น และคำตอบแบบยาวประมาณ 1,050 โทเค็น มาหารด้วยความเร็วของแต่ละรายการแล้วนำมารวมกัน
ใน Ollama ความยาวของการอ่านล่วงหน้าจะถูกกำหนดโดย draft_num_predict ในการตั้งค่าของโมเดล หากสร้างชื่อนามแฝง (alias) ด้วย Modelfile ต่อไปนี้ น้ำหนัก (weights) จะถูกแชร์ร่วมกับโมเดลต้นฉบับ
FROM <ชื่อโมเดล 27B ต้นฉบับ>
PARAMETER draft_num_predict 12
เมื่อปรับจาก 4 เป็น 12 อัตราการยอมรับ (acceptance rate) จะลดลงจาก 0.886 เหลือ 0.619 ในขณะที่ปริมาณการประมวลผลต่อการตรวจสอบ 1 ครั้งเพิ่มขึ้น ส่งผลให้การเรียกใช้เครื่องมือเพิ่มขึ้นจาก 25.9 เป็น 37.4 tok/s ในงานจริง เวลาของ MTP 8 ใน SGLang ลดลงจากประมาณ 75 วินาทีเหลือ 60.2 วินาที และการอ่านล่วงหน้า 12 ใน Ollama ลดลงจาก 109.6 วินาทีเหลือ 85.5 วินาที แม้ว่า MTP 8 และ DFlash2 (62.5 วินาที) จะมีความเร็วใกล้เคียงกัน แต่ MTP ไม่จำเป็นต้องมีโมเดลร่าง (draft model) แยกต่างหาก
การปรับจูนอัตโนมัติ (adaptive) ของการอ่านล่วงหน้าใน SGLang นั้นช้ากว่าการตั้งค่าคงที่ที่ 8 ส่วนการถอดรหัสแบบต่อเนื่อง (continuous decoding) มีความแตกต่างเพียง 1-2% ซึ่งทั้งสองวิธีไม่ส่งผลดีขึ้นแต่อย่างใด
ทำไมการคาดการณ์ล่วงหน้าจึงไม่มีผลกับข้อความภาษาญี่ปุ่น?

ในขณะที่การคาดการณ์ล่วงหน้า (Speculative Decoding) ให้ผลลัพธ์ที่แม่นยำสำหรับเอาต์พุตที่มีรูปแบบตายตัวอย่างการเรียกใช้เครื่องมือ (Tool Calling) แต่กลับแทบไม่ช่วยเพิ่มความเร็วในการเขียนข้อความภาษาญี่ปุ่นแบบอิสระ ซึ่งมีความเร็วไม่ต่างจากการไม่ใช้การคาดการณ์ล่วงหน้าเลย ดังนั้น เราจึงได้ทำการวัดผลด้วยว่าการทำ Quantization จะสามารถช่วยเร่งความเร็วในการประมวลผลข้อความภาษาญี่ปุ่นได้มากน้อยเพียงใด
อัตราความสำเร็จของการคาดการณ์ล่วงหน้าตามประเภทของผลลัพธ์
จากการใช้งาน Ollama รุ่น 27B (Q8_0, Speculative Decoding 12) เราได้ทำการนับจำนวนตามความยาวของผลลัพธ์จากบันทึก (log) ของ llama-server ที่ทำงานอยู่ภายใน (รวมการทดสอบและการใช้งานจริงทั้งหมด 408 รายการ) โดยในส่วนของข้อความภาษาญี่ปุ่นนั้น เป็นคำสั่งให้เขียนบทความความยาวประมาณ 600 ตัวอักษรโดยไม่มีหัวข้อ จำนวน 3 รูปแบบ รูปแบบละ 2 ครั้ง
| ผลลัพธ์ | จำนวน | tok/s ที่สร้างได้ | อัตราการยอมรับ (Acceptance Rate) |
|---|---|---|---|
| น้อยกว่า 120 โทเค็น (เช่น การเรียกใช้เครื่องมือ) | 383 | 35.6 | 0.83 |
| 120–500 โทเค็น | 5 | 25.1 | 0.47 |
| 500 โทเค็นขึ้นไป (คำตอบที่มีตาราง) | 20 | 24.1 | 0.52 |
| ข้อความภาษาญี่ปุ่น | 6 | 7.7 | 0.12 |
ตัวเลขสำหรับข้อความภาษาญี่ปุ่นเป็นผลรวมของ 6 รายการ ส่วนรายการอื่นเป็นค่ามัธยฐาน ทั้งนี้ 7.7 tok/s ไม่ได้แตกต่างจาก 7.9 tok/s ในกรณีที่ไม่มีการทำ Speculative Decoding ความแตกต่างนี้เกิดจากกรณีการเรียกใช้เครื่องมือหรือตารางที่มีรูปแบบตายตัว ทำให้การร่างคำตอบ (draft) มีความแม่นยำสูง ในขณะที่การเขียนข้อความอย่างอิสระนั้นร่างคำตอบไม่ค่อยแม่นยำ สำหรับค่า --spec-draft-p-min ของ llama-server ซึ่งใช้สำหรับตัดการทำงานของ Speculative Decoding ในกรณีที่ไม่มั่นใจนั้น ไม่สามารถส่งผ่านการตั้งค่าโมเดลของ Ollama ได้ ทางเราจึงยังไม่ได้ทำการทดสอบในส่วนนี้
ผลการทดสอบจริงของเรา: ความเร็วและคุณภาพของ Q8_0, Q6_K และ Q4_K_M
เปรียบเทียบ Q6_K และ Q4_K_M ที่มาจากแหล่งแจกจ่ายเดียวกันกับ 27B Q8_0 โดยเพิ่มค่า lookahead 12 เมื่อใช้ Q4_K_M ระยะเวลาที่ใช้ในงานจริงจะเร็วขึ้น 0.88 เท่า และการสร้างข้อความภาษาญี่ปุ่นจะเร็วขึ้น 1.39 เท่า
| Q8_0 | Q6_K | Q4_K_M | |
|---|---|---|---|
| การรันซ้ำ・การเรียกใช้เครื่องมือ | 37.3 tok/s | 41.2 (1.10 เท่า) | 48.6 (1.30 เท่า) |
| ข้อความภาษาญี่ปุ่น | 7.7 tok/s | 8.7 (1.13 เท่า) | 10.7 (1.39 เท่า) |
| ระยะเวลาในงานจริง (ค่ามัธยฐาน) | 88.0 วินาที | 81.1 วินาที | 77.5 วินาที |
| จำนวนครั้งที่ตารางถูกต้อง (จาก 6 ครั้ง) | 4 | 5 | 5 |
| การใช้งาน OS ทั้งหมด (ทันที → หลังจากนั้น) | 47 → 65GB | 41 → 58GB | 38 → 53GB |
อัตราการเพิ่มขึ้นอยู่ที่ 1.1 ถึง 1.4 เท่า ซึ่งน้อยกว่าขีดจำกัดที่ประเมินจากอัตราส่วนขนาดของน้ำหนัก (ประมาณ 1.3 เท่า และ 1.7 เท่า) โดยที่ยังไม่ได้วัดหาสาเหตุ สำหรับข้อความภาษาญี่ปุ่นที่เพิ่มขึ้นมากที่สุดนั้น เรามองว่าเป็นเพราะส่วนที่การคาดการณ์ล่วงหน้า (lookahead) ไม่แม่นยำ ทำให้ความแตกต่างของปริมาณน้ำหนักที่อ่านส่งผลโดยตรง ในส่วนของจำนวนครั้งที่ผิดพลาด Q8_0 ผิด 2 ครั้ง, Q6_K ผิด 1 ครั้ง และ Q4_K_M ผิด 0 ครั้ง แต่เนื่องจากทดสอบเพียงครั้งละ 6 รอบ จึงยังสรุปไม่ได้ว่าเป็นเพราะความแตกต่างของการทำ Quantization หรือเป็นเพียงความคลาดเคลื่อน
ก่อนที่จะเปลี่ยนการทำ Quantization ให้ตรวจสอบก่อนว่าใน GGUF มีชั้น MTP หรือไม่ โดยเราได้ดึงข้อมูลเฉพาะส่วนต้น 12MB ของไฟล์หลัก (รายการ Tensor) จากแหล่งแจกจ่ายมาตรวจสอบ และค้นหาชื่อชั้น (ในโมเดลนี้คือ blk.64.nextn.*)
ปัญหาการทิ้งข้อมูลอินพุตสำรองในการสนทนาที่ยาวนานคืออะไร?

เมื่อใช้งาน Ollama สนทนาต่อเนื่องเป็นเวลานาน เพียงแค่แทรกคำขอสั้นๆ เข้าไป ก็ทำให้ประวัติการสนทนา (Prompt Cache) ถูกลบทิ้ง ส่งผลให้ต้องป้อนข้อความใหม่ทั้งหมดทุกครั้งที่ต้องการส่งคำขอต่อเนื่อง
ทำไมถึงถูกทิ้ง: การใช้หน่วยความจำเกิน 8 GiB ที่จุดตรวจสอบ Linear Attention
สำหรับแต่ละคำขอ เอเจนต์ของเราจะส่ง "คำขอการตัดสินใจ" สั้นๆ ไปก่อนโดยไม่มีประวัติการสนทนา เพื่อพิจารณาว่าจำเป็นต้องทำงานหรือค้นหาเว็บหรือไม่
Ollama รุ่น 27B ทำงานโดยใช้ llama-server เพียง 1 อินสแตนซ์ (-np 1) เมื่อมีคำขออื่นเข้ามา llama-server จะย้ายแคชของการสนทนาปัจจุบันไปยังพื้นที่พักข้อมูลใน RAM และดึงแคชที่เหมาะสมที่สุดสำหรับคำขอถัดไปกลับมา โดยค่าเริ่มต้นของขีดจำกัดพื้นที่พักข้อมูลนี้อยู่ที่ 8 GiB
ในรุ่น 27B ที่มีการผสม Linear Attention เราจะบันทึกสถานะของ Linear Attention ไว้เป็นจุดตรวจสอบ (Checkpoint) เพื่อให้สามารถคำนวณใหม่จากจุดกลางทางได้ โดยแต่ละจุดมีขนาดประมาณ 150MiB และสามารถสะสมได้สูงสุด 32 จุดต่อการสนทนา ซึ่งสำหรับเอเจนต์ที่ทำงานโดยส่งคำขอทีละก้าว จะถึงขีดจำกัดนี้ภายในเวลาเพียงไม่กี่สิบก้าวเท่านั้น
| ความยาวการสนทนา | จุดตรวจสอบ | ขนาดแคช |
|---|---|---|
| 28,591 โทเค็น | 31 จุด | 7,793MiB |
| ประมาณ 4.2 หมื่นโทเค็น | — | 11,153MiB (ถูกทิ้ง) |
| ประมาณ 8.1 หมื่นโทเค็น | — | 15,910MiB (เช่นเดียวกัน) |
แคชที่เกิน 8 GiB จะถูกทิ้งโดยไม่เกิดข้อผิดพลาด เพียงแต่จะมีข้อความ exceeds cache size limit ปรากฏในบันทึก (Log) เท่านั้น
ผลการทดสอบจริงและวิธีแก้ไขของเรา: อินพุตต่อเนื่องเร็วขึ้นจาก 62.6 วินาทีเหลือ 3.75 วินาที
หลังจากสคริปต์ที่ขยายบทสนทนาในรูปแบบเดียวกับงาน (เพิ่มแหล่งข้อมูล 6,000 ไบต์ในทุกๆ 1 ก้าว รวม 30 ก้าว คิดเป็นประมาณ 4.8 หมื่นโทเค็น) ผมได้แทรกคำขอสั้นๆ ในรูปแบบเดียวกับคำขอให้ตัดสินใจเข้าไป 1 รายการ แล้วจึงส่งส่วนต่อขยายของบทสนทนาไป
| ขีดจำกัดของแคช RAM | อินพุตที่นำกลับมาใช้ใหม่ในส่วนต่อขยาย | เวลาของอินพุต | คำขอที่แทรกเข้าไป |
|---|---|---|---|
| 8 GiB (ค่าเริ่มต้น) | 0 / 49,626 โทเค็น | 62.6 วินาที | 0.96 วินาที |
| 16 GiB | 47,972 / 49,626 โทเค็น | 3.75 วินาที | 4.54 วินาที |
ในทางกลับกัน คำขอสั้นๆ ที่แทรกเข้าไปใช้เวลาเพิ่มขึ้นจากประมาณ 1 วินาทีเป็น 4.5 วินาที ผมคาดว่าเป็นเวลาที่ใช้ในการย้ายแคชประมาณ 11 GiB ไปยัง RAM แต่ยังไม่ได้ทำการวัดผลจริง
ขีดจำกัดจะถูกกำหนดโดย --cache-ram ของ llama-server แต่ไม่สามารถส่งผ่านจากการตั้งค่าโมเดลของ Ollama ได้ เนื่องจาก llama-server รับอาร์กิวเมนต์จำนวนมากผ่านตัวแปรสภาพแวดล้อม (Environment Variable) ได้ (เช่น LLAMA_ARG_CACHE_RAM) และ Ollama จะส่งผ่านตัวแปรสภาพแวดล้อมของตนเองไปโดยตรง ดังนั้นการระบุไว้ในการตั้งค่าของเซอร์วิสจึงได้ผล
1# /etc/systemd/system/ollama.service.d/override.conf (ดำเนินการ daemon-reload และ restart)
2[Service]
3Environment="LLAMA_ARG_CACHE_RAM=16384"
บริษัทของเราตั้งค่าไว้ที่ 16 GiB ซึ่งเป็นค่าที่รองรับบทสนทนาได้สูงสุดประมาณ 8 หมื่นโทเค็น และเมื่อรวมกับหลังจากใช้ Flash-Next (105GB) แล้ว จะรวมเป็น 121GB ซึ่งอยู่ในเกณฑ์ที่กำหนด นอกจากนี้ ผมได้ลองใช้ OLLAMA_NUM_PARALLEL=2 เพื่อทำแคช 2 ชุด แต่ Ollama 0.40.4 ไม่รองรับการทำงานแบบขนานสำหรับโมเดลขนาด 27B รุ่นนี้ (qwen35) จึงยังคงเป็น -np 1 เช่นเดิม
เราหยุดการทำงานซ้ำ (ผลลัพธ์ที่ผิดพลาด) ของเอเจนต์ได้อย่างไร?

การอ่านไฟล์เดิมซ้ำโดยเปลี่ยนช่วงข้อมูลไปทีละน้อยเกิดขึ้นประมาณ 30% ของจำนวนครั้งทั้งหมด โดยไม่ขึ้นอยู่กับ Engine หรือการทำ Quantization เมื่อให้ Agent นับจำนวนครั้งที่อ่านและเพิ่มคำเตือนเข้าไป ก็สามารถหลุดพ้นจากการอ่านซ้ำดังกล่าวได้
ผลลัพธ์ที่ผิดพลาดคงเหลืออยู่ประมาณ 30% แม้จะเปลี่ยนเครื่องมือแล้วก็ตาม
อัตราความผิดพลาด (การวนซ้ำตั้งแต่ 26 ก้าวขึ้นไป หรือการหยุดทำงานเนื่องจากข้อผิดพลาด) มีค่าใกล้เคียงกันในทุกเอนจิน โดย SGLang 27B NVFP4 อยู่ที่ 7 จาก 24 ครั้ง (29%), Ollama 27B Q8_0 อยู่ที่ 3 จาก 11 ครั้ง (27%) และ Flash-Next อยู่ที่ 2 จาก 6 ครั้ง
การวนซ้ำส่วนใหญ่เกิดจากการที่ระบบอ่านไฟล์เป้าหมายซ้ำไปซ้ำมาด้วย read_file โดยเปลี่ยนช่วงการอ่านไปเรื่อยๆ ในบางกรณีมีการเรียกใช้ถึง 150 ครั้งโดยมีอาร์กิวเมนต์ต่างกันถึง 25 รูปแบบ ทำให้ระบบเฝ้าระวังที่ใช้เงื่อนไขว่า "หยุดเมื่อมีการเรียกใช้ซ้ำเดิม" ไม่สามารถหยุดการทำงานได้ เนื่องจากปัญหานี้ไม่ได้รับการแก้ไขแม้จะเปลี่ยนเอนจินแล้ว เราจึงดำเนินการแก้ไขที่ฝั่งเอเจนต์แทน
ระบบตรวจสอบการนับจำนวนครั้งที่อ่านไฟล์เดียวกัน
ระบบเฝ้าระวังจะนับ read_file และการค้นหาที่ระบุไฟล์เดียวกันว่าเป็นคู่สนทนาเดียวกัน แม้ว่าช่วงข้อมูลหรือคำค้นหาจะต่างกันก็ตาม (รวมถึงคำสั่งที่ใช้เพียงเพื่ออ่านข้อมูลอย่าง grep หรือ sed ด้วย)
- ตั้งแต่ครั้งที่ 12 เป็นต้นไป จะมีการแนบคำเตือนในผลลัพธ์การอ่านว่า "คุณได้อ่านไฟล์นี้ครบ 12 ครั้งแล้ว โปรดเขียนคำตอบโดยใช้ผลลัพธ์จนถึงตอนนี้"
- ตั้งแต่ครั้งที่ 20 เป็นต้นไป ระบบจะไม่ดำเนินการอ่านไฟล์ แต่จะส่งขั้นตอนถัดไปโดยไม่ใช้เครื่องมือเพื่อให้โมเดลเขียนคำตอบ
เกณฑ์ดังกล่าวถูกกำหนดขึ้นโดยอ้างอิงจากจำนวนการอ่านไฟล์เดียวกันในกรณีที่จบงานได้ตามปกติ (34 รายการ) ซึ่งอยู่ที่สูงสุด 10 ครั้ง ในขณะที่กรณีที่มีการทำซ้ำอยู่ที่ 20–150 ครั้ง จากการทดสอบนำบทสนทนาที่ทำงานไปถึง 150 ขั้นตอนในเวอร์ชันที่ไม่มีระบบเฝ้าระวัง มาดำเนินการต่อจากขั้นตอนที่ 30 จำนวน 3 ครั้ง พบว่า 2 ครั้งโมเดลเปลี่ยนไปเขียนคำตอบในขั้นตอนถัดจากคำเตือนครั้งที่ 12 และอีก 1 ครั้งเขียนคำตอบก่อนที่จะได้รับคำเตือน โดยทั้ง 3 ครั้งได้ผลลัพธ์ตารางเป็น 47/47
หลังจากหยุดการทำงานแล้ว ยังมีกับดักอีกประการหนึ่งคือ แม้ในคำขอที่ไม่ได้ส่ง tools ไปให้ Ollama แต่โมเดลก็ยังส่งการเรียกใช้เครื่องมือกลับมา ดังนั้นจึงมีการตั้งค่าให้ไม่ดำเนินการตามคำขอนั้น แต่ให้ส่งข้อความกลับไปอีกเพียงครั้งเดียวว่า "ไม่สามารถใช้เครื่องมือได้" ในการทดสอบ พบว่าจาก 7 ครั้งที่หยุดการทำงาน มี 5 ครั้งที่โมเดลพยายามเรียกใช้เครื่องมือ และทั้ง 5 ครั้งนั้นโมเดลสามารถเขียนคำตอบได้ในขั้นตอนถัดมา
ควรเลือกแบบใด? วิธีการเลือกตามวัตถุประสงค์และข้อควรระวัง

หากให้ความสำคัญกับความเร็วเป็นอันดับแรก คำตอบจากการวัดผลจริงของเราคือ MTP 8 ของ SGLang แต่หากต้องการใช้ Ollama ให้จบ ก็คือการตั้งค่า Speculative Decoding (การอ่านล่วงหน้า) ที่ 12 สำหรับรุ่น 27B ไม่ว่าจะเลือกทางใด คุณยังจำเป็นต้องมีการตั้งค่ากลไกป้องกันการตอบผิด (Anti-hallucination) และการตั้งค่าหน่วยความจำสำหรับการสนทนาที่ยาวขึ้นแยกต่างหาก
วิธีการเลือกตามวัตถุประสงค์และการตั้งค่าเริ่มต้นของเรา
- หากให้ความสำคัญกับความเร็วเป็นอันดับแรก ให้ใช้ MTP 8 ของ SGLang รอบที่ทำงานเสร็จตามปกติใช้เวลาประมาณ 0.55 เท่าของ Ollama 27B (Speculative Decoding 4) โดยต้องใช้เวลาประมาณ 3 นาทีในการเริ่มต้นระบบ และจำเป็นต้องใช้งานโดยไม่รันควบคู่กับ Ollama บนเครื่องเดียวกัน สำหรับโมเดลที่ผสม Linear Attention ให้ใส่
--mamba-radix-cache-strategy extra_bufferเพื่อให้สามารถใช้งานทั้ง Speculative Decoding และการนำ Input กลับมาใช้ใหม่ได้พร้อมกัน - หากต้องการใช้เพียง Ollama ให้ตั้งค่า Speculative Decoding ของ 27B เป็น 12 การตั้งค่าเพียงจุดเดียวจะช่วยให้เร็วขึ้นประมาณ 20% และช้ากว่า MTP 8 ของ SGLang เพียงประมาณ 25 วินาทีต่อรอบเท่านั้น
- หากต้องการให้เขียนข้อความภาษาญี่ปุ่นจำนวนมาก ให้ใช้ Q4_K_M จะช่วยให้งานจริงเร็วขึ้นประมาณ 10% และงานเขียนภาษาญี่ปุ่นเร็วขึ้นประมาณ 40%
- หากต้องการสนทนาต่อเนื่องในการทำงานระยะยาว ให้เพิ่มขีดจำกัดของ RAM สำรอง
ค่าเริ่มต้นของบริษัทเราคือ Ollama 27B Q8_0 (Speculative Decoding 12) และตั้งค่า RAM สำรองไว้ที่ 16 GiB แม้จะช้ากว่า SGLang แต่ก็ช่วยให้ไม่ต้องรัน Engine อื่นค้างไว้ สำหรับ Q4_K_M นั้น เนื่องจากความเร็วเพิ่มขึ้นเพียงประมาณ 10% และเราได้ทดสอบผลลัพธ์ไปเพียงอย่างละ 6 ครั้ง เราจึงเพิ่มเข้าไปในรายการโมเดลเพื่อใช้งานและเปรียบเทียบไปพร้อมกัน
ข้อควรระวังและข้อจำกัดของการวัดผลนี้
นี่คือข้อผิดพลาดที่พบระหว่างการวัดผล:
- เมื่อรัน Ollama และเอนจินอื่นบนเครื่องเดียวกัน ในระหว่างการเรียกใช้งานเอเยนต์ Ollama ได้เริ่มโหลด Flash-Next (ประมาณ 67GB) ทำให้ llama-server ถูกบังคับปิดเนื่องจากหน่วยความจำไม่เพียงพอ
fa3ที่มักปรากฏในตัวอย่างการเริ่มต้นใช้งาน SGLang นั้นรองรับเฉพาะ sm_90 เท่านั้น ไม่สามารถใช้กับ GB10 ได้ จึงต้องใช้--attention-backend flashinferแทน- เมื่อการนำเข้าโมเดลของ Ollama ค้างอยู่ที่ 91% เป็นเวลานานกว่า 25 นาที การลองใหม่จะทำให้ระบบกลับมาทำงานต่อจากจุดเดิมและเสร็จสิ้นภายในไม่กี่วินาที
นอกจากนี้ยังมีข้อจำกัดในการวัดผล โดยงานที่ใช้มีเพียงประเภทเดียวคือการอ่านเท่านั้น และจำนวนครั้งในการทดสอบอยู่ที่ 3-8 ครั้งต่อกลุ่ม สำหรับโมเดล 27B นั้น แต่ละเอนจินมีการทำ Quantization ที่แตกต่างกัน และวิธีการวัดความเร็วในการป้อนข้อมูลของ SGLang ก็แตกต่างจากเอนจินอื่น อีกทั้งแม้จะปรับเป็น 16 GiB แล้ว แต่ก็ไม่สามารถรองรับประวัติการสนทนาที่ยาวเกินกว่า 80,000 โทเค็นได้
คำถามที่พบบ่อย

ในส่วนนี้ เราจะมาตอบคำถามที่มักพบบ่อยเมื่อใช้งาน Agent บน DGX Spark หรือ Ollama โดยอ้างอิงจากข้อมูลที่ได้จากการวัดผลในครั้งนี้
Q1: จะทำให้ Speculative Decoding (MTP) เร็วขึ้นบน Ollama ของ DGX Spark ได้อย่างไร?
เพิ่มความยาวของการคาดการณ์ล่วงหน้า (speculative decoding) การตั้งค่าเดียวที่สามารถส่งจาก Ollama ไปยังการคาดการณ์ล่วงหน้าได้คือ draft_num_predict ซึ่งในการทดสอบกับงานจริงของบริษัทเรา การปรับค่าจาก 4 เป็น 12 ช่วยให้ความเร็วเพิ่มขึ้นประมาณ 20% เมื่อต้องการเปลี่ยนการทำ Quantization โปรดตรวจสอบให้แน่ใจก่อนว่าไฟล์ GGUF นั้นมีเลเยอร์ MTP รวมอยู่ด้วยหรือไม่
Q2: ทำไมการสนทนาที่ยาวนานถึงช้าลงเฉพาะช่วงท้าย?
ข้อมูลที่ป้อนเข้ามาอาจเกินขีดจำกัดของพื้นที่จัดเก็บ RAM (ค่าเริ่มต้นคือ 8 GiB) ทำให้ถูกละทิ้งไปโดยไม่มีการแจ้งเตือน หากในบันทึก (log) ของ llama-server ปรากฏข้อความ exceeds cache size limit แสดงว่านี่คือสาเหตุของปัญหา การเพิ่มขีดจำกัดด้วย LLAMA_ARG_CACHE_RAM ช่วยให้ในสภาพแวดล้อมของเรา การป้อนข้อมูลต่อเนื่องที่ 4.8 หมื่นโทเค็นใช้เวลาลดลงจาก 62.6 วินาที เหลือเพียง 3.75 วินาที
บทสรุป

หากคุณใช้ DGX Spark เพียง 1 เครื่องเพื่อรัน Local LLM สำหรับ Agent ประเด็นสำคัญคือการเร่งความเร็วในการสร้างข้อความ (Generation) ซึ่งเป็นส่วนที่ใช้เวลามากที่สุด จากการทดสอบจริงของเรา การเพิ่มความยาวของ Speculative Decoding (MTP) ให้ผลลัพธ์ดีที่สุด โดย MTP 8 ของ SGLang ให้ความเร็วสูงสุด ส่วน Ollama ก็ทำเวลาได้เร็วขึ้นประมาณ 20% ด้วยการตั้งค่า Speculative Decoding ไว้ที่ 12 สำหรับข้อความภาษาญี่ปุ่นที่การคาดการณ์ล่วงหน้า (Speculative Decoding) มักจะพลาด การใช้ Q4_K_M จะช่วยเพิ่มความเร็วได้ประมาณ 40%
สิ่งที่มักมองข้ามไปคือปัญหาที่หน่วยความจำสำรองของ Input ในการสนทนาที่ยาวนานถูกลบทิ้งโดยไม่รู้ตัว ซึ่งสามารถตรวจสอบได้จากข้อความ exceeds cache size limit ใน Log เนื่องจากปัญหาการทำซ้ำที่ไม่ตรงจุดนี้ไม่สามารถแก้ไขได้ด้วยการเปลี่ยน Engine ข้อสรุปของเราคือต้องใช้งานร่วมกับการตรวจสอบจากฝั่ง Agent สำหรับภาพรวมในการเลือก Local LLM สามารถดูเพิ่มเติมได้ที่ การเปรียบเทียบการนำ Local LLM / SLM มาใช้งาน
ทางเรายังให้บริการสนับสนุนการตรวจสอบและทำ PoC สำหรับ Local LLM และ Agent อีกด้วย หากต้องการปรึกษา สามารถติดต่อได้ที่ บริการสนับสนุน AI/DX
เอกสารอ้างอิง (ณ เวลาที่เขียน): RAM cache (#16391) และ Checkpoints (#15293) ของ llama.cpp, เอกสาร Modelfile ของ Ollama, และขั้นตอนการเปิดใช้งาน SGLang สำหรับ GB10 (MiaAI-Lab)
ผู้เขียน・ผู้ตรวจสอบ

Yusuke Ishihara
เริ่มเขียนโปรแกรมตั้งแต่อายุ 13 ปี ด้วย MSX หลังจบการศึกษาจากมหาวิทยาลัย Musashi ได้ทำงานพัฒนาระบบขนาดใหญ่ รวมถึงระบบหลักของสายการบิน และโครงสร้าง Windows Server Hosting/VPS แห่งแรกของญี่ปุ่น ร่วมก่อตั้ง Site Engine Inc. ในปี 2008 ก่อตั้ง Unimon Inc. ในปี 2010 และ Enison Inc. ในปี 2025 นำทีมพัฒนาระบบธุรกิจ การประมวลผลภาษาธรรมชาติ และแพลตฟอร์ม ปัจจุบันมุ่งเน้นการพัฒนาผลิตภัณฑ์และการส่งเสริม AI/DX โดยใช้ generative AI และ Large Language Models (LLM)
บทความแนะนำ


คำศัพท์ที่เกี่ยวข้องกับบทความนี้
LLM ในเครื่อง
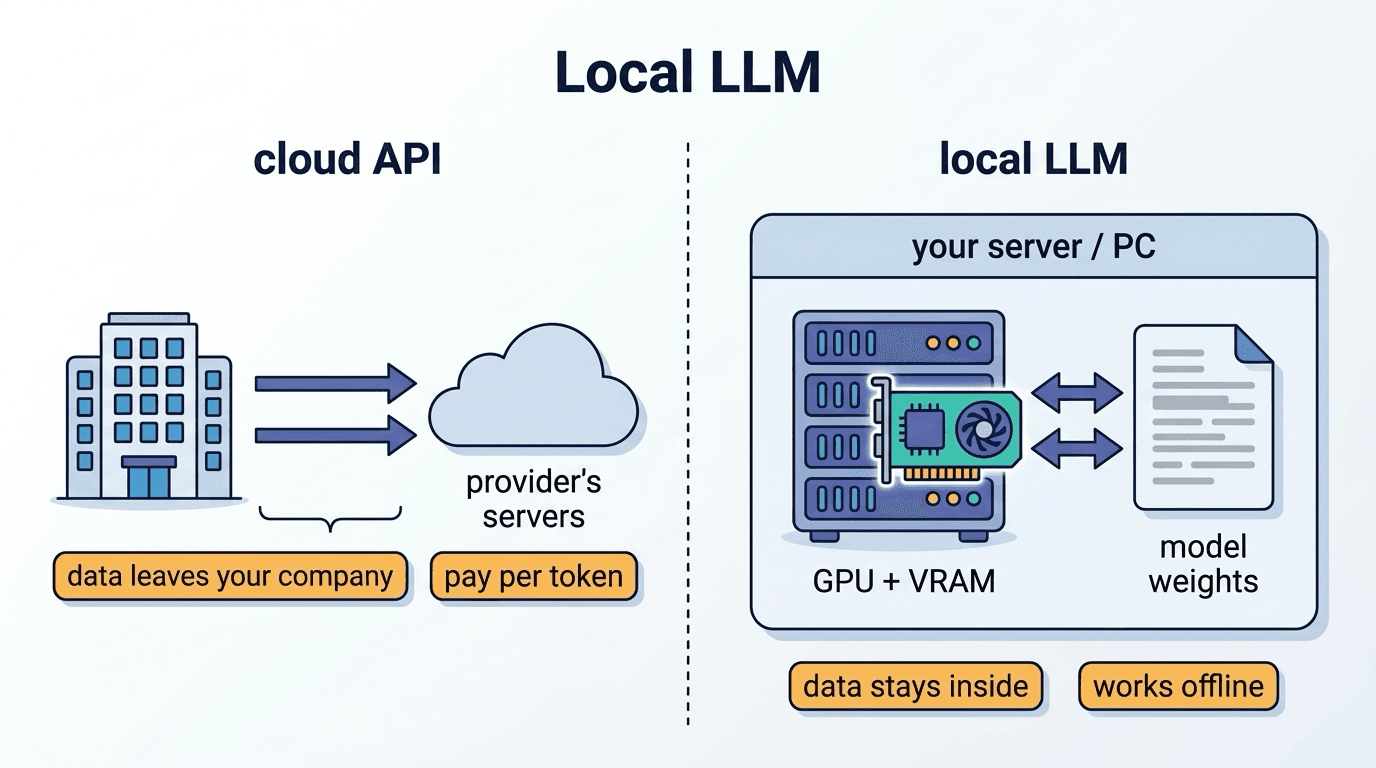
Local LLM คือรูปแบบการใช้งานที่รันโมเดลภาษาขนาดใหญ่ (Large Language Model) โดยตรงบนเซิร์ฟเวอร์หรือพี

SLM (Small Language Model) โมเดลภาษาขนาดเล็ก
SLM (Small Language Model) คือชื่อเรียกรวมของโมเดลภาษาที่จำกัดจำนวนพารามิเตอร์ไว้ที่ระดับหลายพันล้าน
TurboQuant
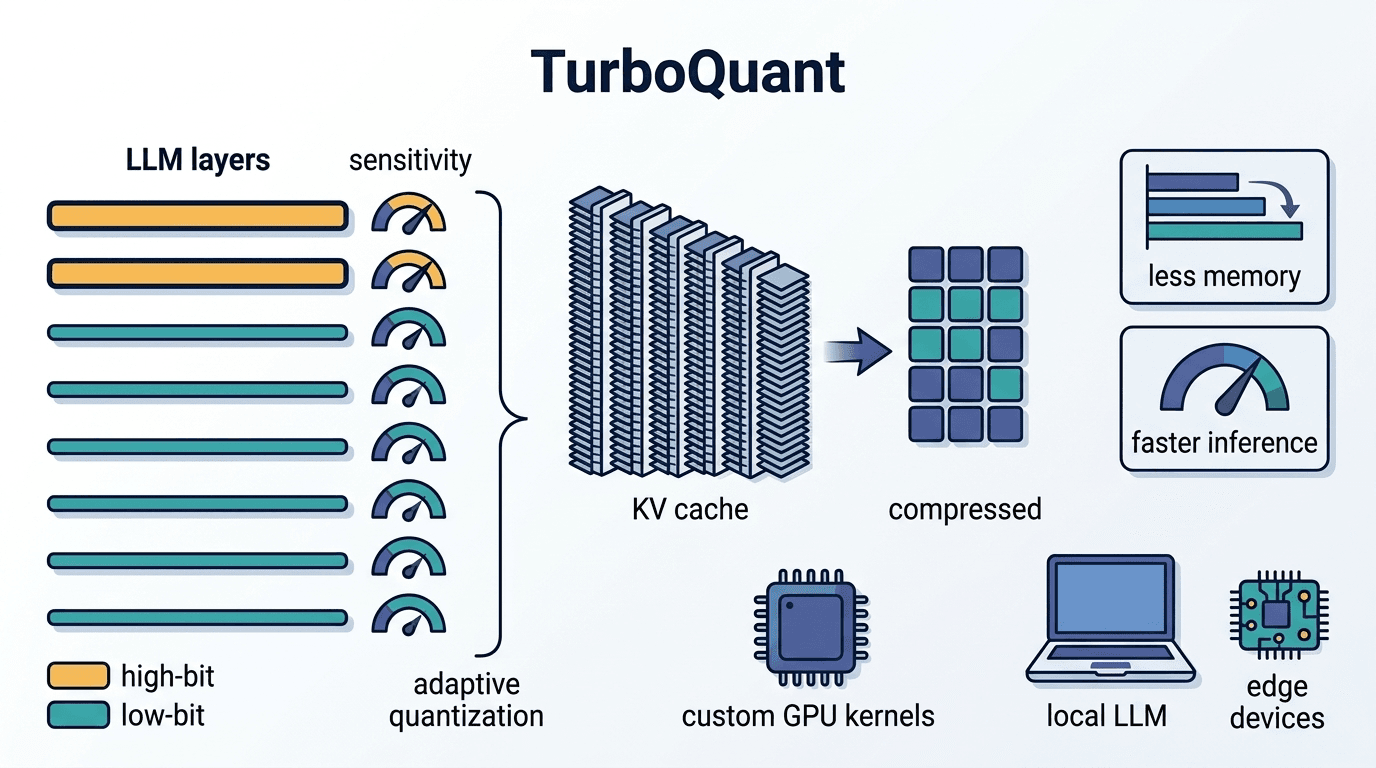
เทคโนโลยีการบีบอัดหน่วยความจำสำหรับ LLM ที่พัฒนาโดย Google ใช้การ Quantization เพื่อลดการใช้หน่วยควา