TurboQuant
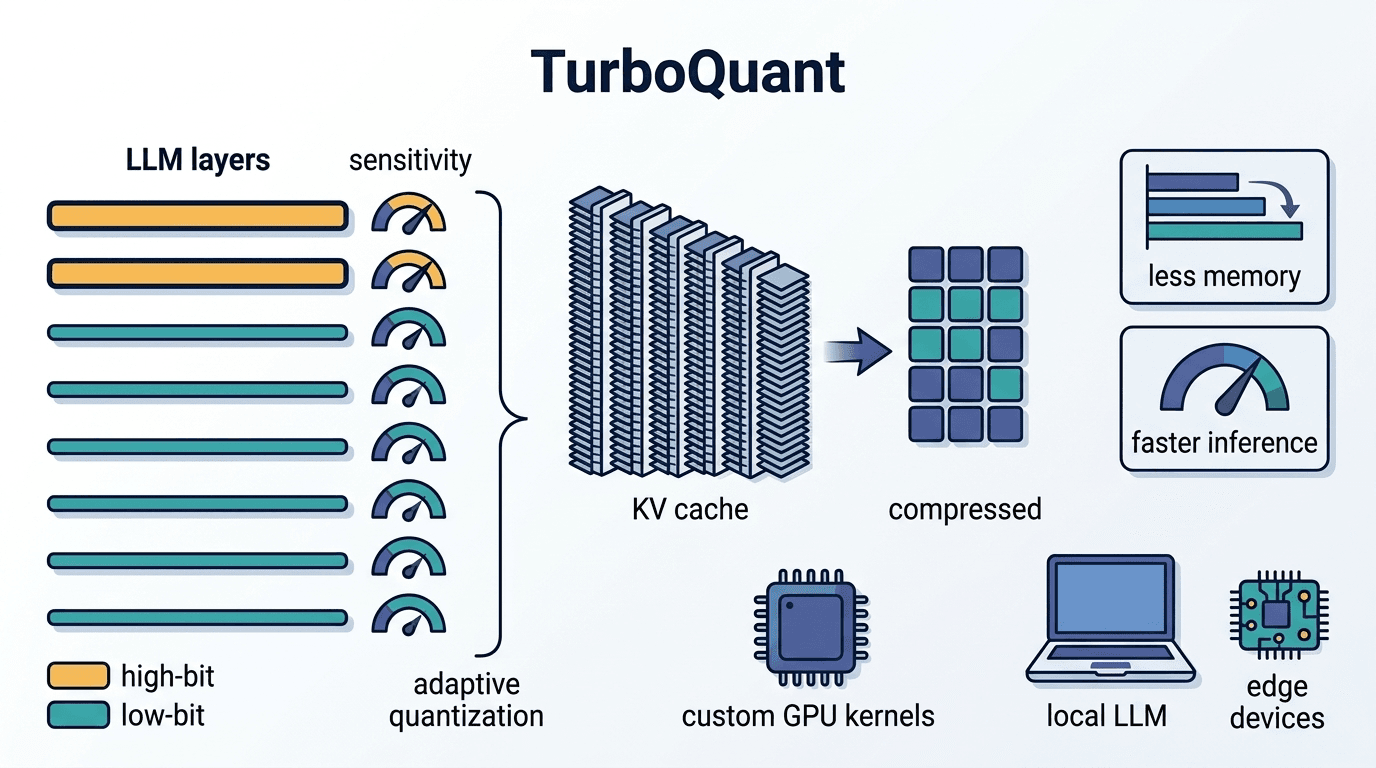
เทคโนโลยีการบีบอัดหน่วยความจำสำหรับ LLM ที่พัฒนาโดย Google ใช้การ Quantization เพื่อลดการใช้หน่วยความจำได้สูงสุดถึง 1/6 และเพิ่มความเร็วในการ Inference ได้สูงสุดถึง 8 เท่า
TurboQuant คือเทคโนโลยีการบีบอัดหน่วยความจำสำหรับLLM (Large Language Model)ที่ว่ากันว่า Google เป็นผู้พัฒนา อย่างไรก็ตาม ณ เวลาที่เขียนบทความนี้ ยังไม่มีการยืนยันว่าเทคโนโลยีที่ใช้ชื่อนี้เป็นการประกาศอย่างเป็นทางการจาก Google จึงควรระมัดระวังในเรื่องความถูกต้องของข้อมูล โดยทั่วไปแล้ว การนำQuantization (การควอนไทซ์)มาใช้สามารถลดการใช้หน่วยความจำของโมเดลได้อย่างมาก และช่วยเพิ่มความเร็วในการ Inference ท่ามกลางกระแสการขยายขนาดของโมเดล AI ที่เร่งตัวขึ้น เทคโนโลยีนี้จึงได้รับความสนใจในฐานะแนวทางที่ช่วยลดทั้งต้นทุนการ Deploy และ Latency ไปพร้อมกัน
เหตุใดการบีบอัดหน่วยความจำจึงสำคัญในตอนนี้
การพัฒนาประสิทธิภาพของ LLM ผูกติดอยู่กับการเพิ่มจำนวน Parameter ของโมเดลอย่างแยกไม่ออก แต่ยิ่ง Parameter มากขึ้นเท่าใด หน่วยความจำGPU (Graphics Processing Unit)ที่จำเป็นในการ Inference ก็ยิ่งพองตัวขึ้น และต้นทุนการดำเนินงานจริงก็พุ่งสูงขึ้นอย่างรวดเร็ว โดยเฉพาะอย่างยิ่งในงานที่ต้องใช้Reasoning ModelหรือMulti-step Reasoning ปริมาณหน่วยความจำที่ใช้ในการ Inference แต่ละครั้งมักจะมากกว่าปกติหลายเท่า
แม้วิธีการ Quantization แบบดั้งเดิมจะสามารถลดหน่วยความจำได้ แต่ก็มักมาพร้อมกับการแลกเปลี่ยนกับความเสื่อมถอยของความแม่นยำอยู่เสมอ การออกแบบที่มุ่งรับมือกับความท้าทายเหล่านี้โดยตรง เพื่อให้บรรลุทั้งอัตราการบีบอัดและความเร็วในขณะที่ยังคงรักษาความแม่นยำไว้ จึงเป็นสิ่งที่ต้องการอย่างยิ่ง
กลไกทางเทคนิค
แก่นของเทคโนโลยี Quantization ประเภทนี้อยู่ที่กระบวนการ Quantization ที่แปลง Weight ของโมเดลให้อยู่ในรูปแบบ Low-bit โดยปกติแล้ว Weight ของ LLM จะถูกเก็บในรูปแบบ FP32 (32-bit Floating Point) หรือ BF16 (16-bit) แต่จะถูกบีบอัดให้เหลือ Bit ที่ต่ำลงไปอีก สิ่งสำคัญในกระบวนการนี้คือการใช้ Adaptive Quantization Scheme ที่คำนึงถึงความไวของแต่ละ Layer แทนที่จะเป็นเพียงการปัดเศษแบบธรรมดา
เมื่อสรุปคุณลักษณะเฉพาะแล้ว มีดังต่อไปนี้
- การวิเคราะห์ความไวแยกตาม Layer: แทนที่จะบีบอัดโมเดลทั้งหมดอย่างสม่ำเสมอ Layer ที่มีผลกระทบต่อความแม่นยำมากจะใช้ High-bit ส่วน Layer ที่มีผลกระทบน้อยจะใช้ Low-bit ในการ Quantize
- การปรับแต่ง Kernel: ติดตั้ง Kernel เฉพาะทางเพื่อรันการคำนวณหลังการ Quantize บน GPU ได้อย่างมีประสิทธิภาพ และขจัดคอขวดของ Memory Bandwidth
- การผสานรวมกับการบีบอัด Cache: รวม KV Cache (พื้นที่เก็บ Intermediate Representation ระหว่างการ Inference) ไว้ในขอบเขตการบีบอัดด้วย เพื่อเพิ่มประสิทธิภาพหน่วยความจำในการประมวลผล Long Context
การออกแบบนี้ทำให้การทำงานในสภาพแวดล้อมที่มีทรัพยากรจำกัด เช่น Local LLM หรือ Edge AI กลายเป็นตัวเลือกที่เป็นไปได้จริงในทางปฏิบัติ
สถานการณ์ที่คาดว่าจะได้ประโยชน์
สภาพแวดล้อมการผลิตจริงที่มีข้อกำหนดเข้มงวดทั้งด้าน Latency และต้นทุน คือกลุ่มที่ได้รับประโยชน์สูงสุดจากเทคโนโลยีการบีบอัดหน่วยความจำประเภทนี้ ตัวอย่างเช่น ในMulti-agent Systemที่AI Agentประสานงานโมเดลหลายตัวเข้าด้วยกัน ต้นทุนการ Inference แต่ละครั้งจะสะสมกัน ดังนั้นผลของการลดการใช้หน่วยความจำต่อครั้งจึงมีนัยสำคัญมาก ในทำนองเดียวกัน สถาปัตยกรรมที่วนซ้ำระหว่างการ Retrieval และการ Generation เช่น Agentic RAG ก็จะเห็นประโยชน์ด้าน Throughput ที่ชัดเจน
นอกจากนี้ยังมีประสิทธิภาพในการ Serving Foundation Modelที่ผ่านFine-tuningแล้ว ทำให้สามารถประมวลผล Request ได้มากขึ้นแบบ Parallel บน GPU Resource เดิม มีหลายกรณีที่ต้นทุน Infrastructure ซึ่งไม่เป็นปัญหาในขั้นPoC (Proof of Concept) กลับปรากฏชัดขึ้นอย่างฉับพลันเมื่อขยายสู่ Production Scale เทคโนโลยี Quantization ถือเป็นหนึ่งในตัวเลือกทางเทคนิคที่ช่วยเติมเต็มช่องว่างนั้น
ประเด็นที่ควรทราบก่อนนำไปใช้งาน
สิ่งที่ใช้ได้กับเทคโนโลยีการบีบอัดหน่วยความจำโดยทั่วไปคือ Quantization ไม่ใช่ยาครอบจักรวาล ยิ่งเพิ่มอัตราการบีบอัดมากเท่าใด ความเสี่ยงที่ความแม่นยำจะลดลงในงานเฉพาะก็ยิ่งสูงขึ้น ตัวชี้วัดที่เกี่ยวข้องโดยตรงกับคุณภาพ เช่น ความถี่ในการเกิดHallucination และความสอดคล้องของStructured Output ควรได้รับการเปรียบเทียบและตรวจสอบก่อนและหลังการบีบอัดอย่างเคร่งครัด
นอกจากนี้ เพื่อให้เทคโนโลยี Quantization แสดงประสิทธิภาพสูงสุด จำเป็นต้องมี GPU Architecture ที่รองรับและ Optimized Kernel เป็นพื้นฐาน ในการผนวกรวมเข้ากับ MLOps Pipeline ที่มีอยู่ การตรวจสอบความเข้ากันได้กับโครงสร้างพื้นฐานMLOpsก็เป็นสิ่งที่ขาดไม่ได้เช่นกัน แม้ว่าการปรับปรุงด้านความเร็วและต้นทุนจะน่าดึงดูดใจ แต่การทำ Benchmark อย่างเพียงพอสำหรับโมเดลและงานเป้าหมายก่อนการนำไปใช้งาน คือเส้นทางลัดสู่การดำเนินงาน Production ที่มีเสถียรภาพ
บทความที่กล่าวถึงคำศัพท์นี้
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน
- คู่มือการเพิ่มประสิทธิภาพต้นทุน LLM — การลดโทเค็น การเลือกโมเดล และการทำแคชคู่มือลดต้นทุนการใช้งาน LLM ในระดับโปรดักชัน ด้วย 4 กลยุทธ์: การปรับแต่ง Token, การเลือก Model, Prompt Cache และ RAG เพื่อลดค่าใช้จ่ายรายเดือนลงครึ่งหนึ่งโดยยังคงความแม่นยำไว้ได้
- วิธีเลือกใช้ Fine-tuning และ RAG: คู่มือเปรียบเทียบตามต้นทุน ความแม่นยำ และการใช้งานจริงเลือกใช้ Fine-tuning หรือ RAG ดี? เปรียบเทียบ 4 ปัจจัยหลัก (ต้นทุน, ความแม่นยำ, การอัปเดต, ความปลอดภัย) พร้อมเกณฑ์การเลือกที่เหมาะสมกับธุรกิจคุณ
- Inference-time Scaling คืออะไร? วิธีปรับสมดุลระหว่างต้นทุนและความแม่นยำของ AIเจาะลึกกลไก Test-Time Compute และวิธีเพิ่มประสิทธิภาพ Trade-off ระหว่างต้นทุนและความแม่นยำ พร้อมแนวทางออกแบบการใช้งาน LLM ให้คุ้มค่าในยุค Inference Model


คำศัพท์ที่เกี่ยวข้อง
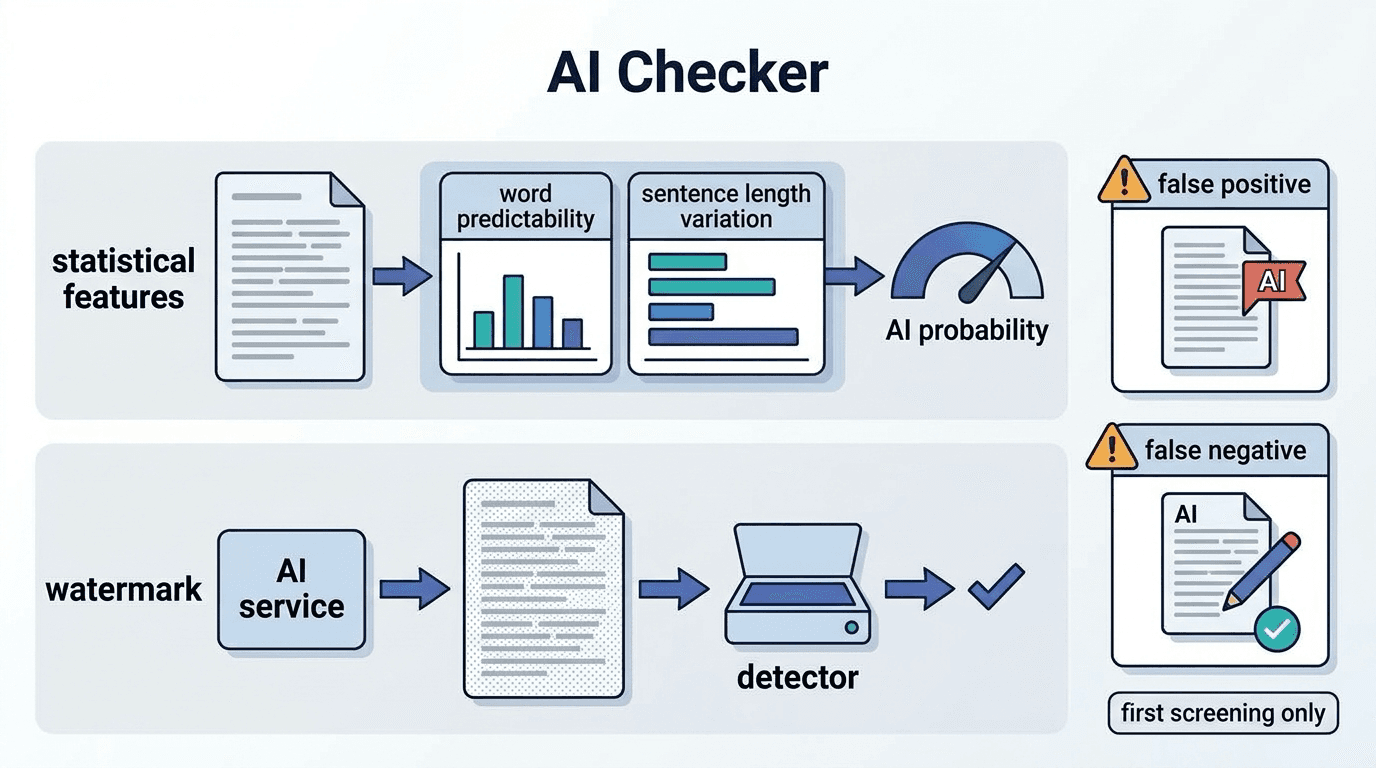
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
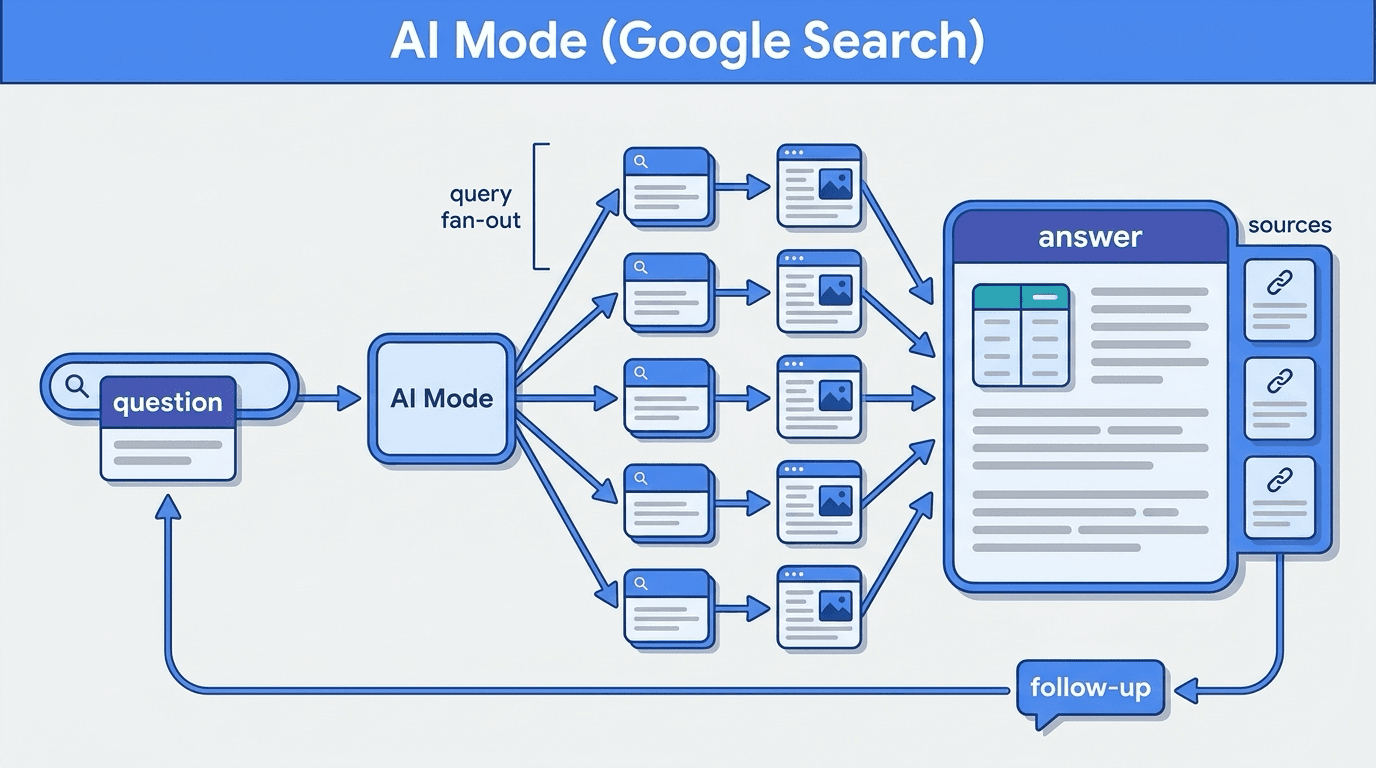
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
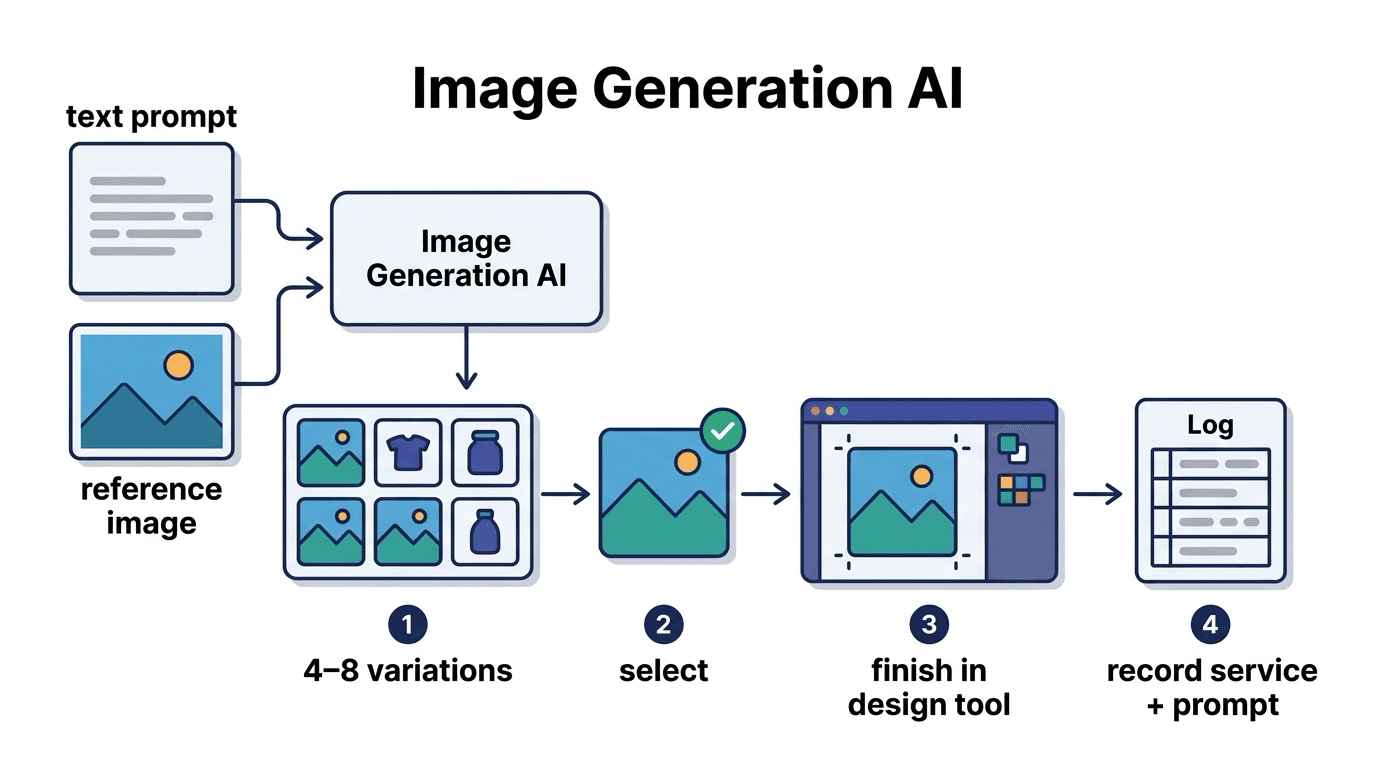
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
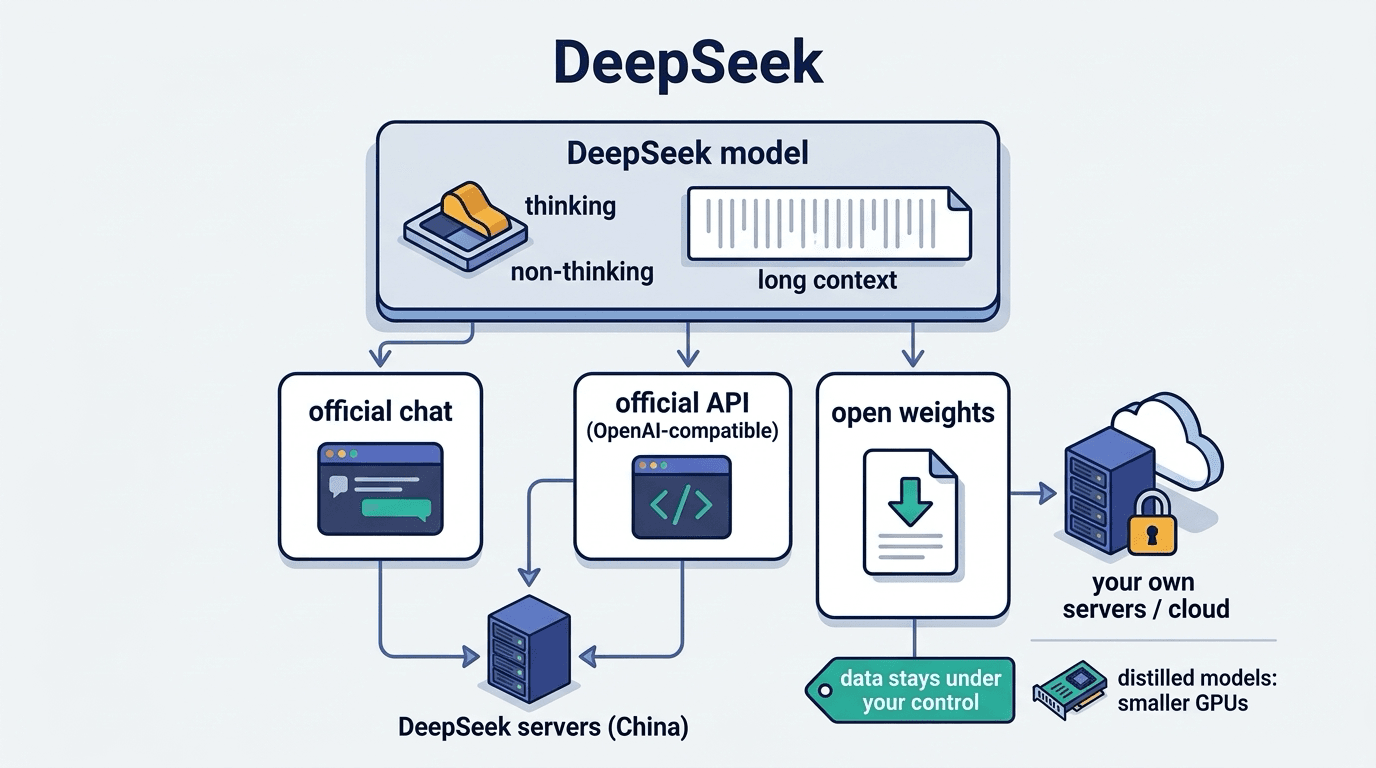
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ