การควอนไทซ์ (Quantization)
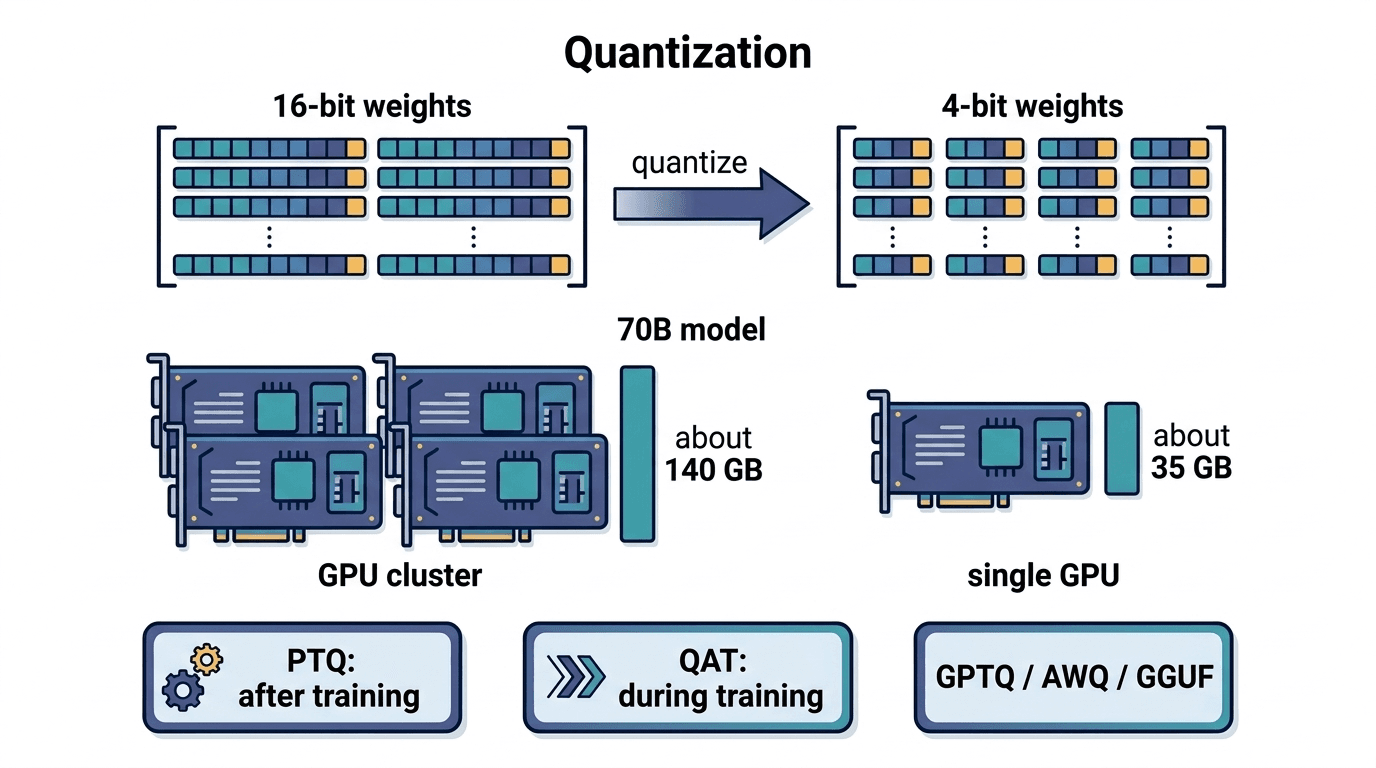
เทคนิคการปรับแต่งที่ลดความแม่นยำของพารามิเตอร์โมเดลจาก 16 บิต ลงเหลือ 4 บิต เป็นต้น เพื่อบีบอัดขนาดและเปิดใช้งานการ inference ภายใต้ทรัพยากรการประมวลผลที่จำกัด
Quantization คืออะไร
Quantization (การ Quantize) คือเทคนิคการปรับแต่งที่ลดความแม่นยำของค่าตัวเลขในพารามิเตอร์น้ำหนักของโมเดล (เช่น จาก floating point 32 บิต → integer 4 บิต) เพื่อบีบอัดขนาดโมเดลและการใช้หน่วยความจำ
ความเข้าใจเชิงสัญชาตญาณ
คล้ายกับการลดคุณภาพของภาพถ่ายแล้วทำให้ขนาดไฟล์เล็กลง แม้ว่าปริมาณข้อมูลต่อพารามิเตอร์หนึ่งตัวจะลดลง แต่ประสิทธิภาพโดยรวมของโมเดลกลับคงอยู่ได้อย่างน่าแปลกใจ หากนำโมเดลขนาด 70B พารามิเตอร์มาทำ Quantization แบบ 4 บิต การใช้งาน VRAM จะลดลงจากประมาณ 140GB เหลือประมาณ 35GB ทำให้สามารถ Inference ได้โดยไม่ต้องใช้ GPU cluster ราคาแพง
ประเภทของ Quantization
| วิธีการ | ลักษณะเฉพาะ |
|---|---|
| Post-Training Quantization (PTQ) | Quantize โมเดลที่เทรนแล้วโดยตรง ทำได้ง่ายแต่อาจมีความแม่นยำลดลงมาก |
| Quantization-Aware Training (QAT) | เทรนโดยคำนึงถึงการ Quantize ให้ความแม่นยำสูงกว่า PTQ แต่ต้องใช้ต้นทุนในการเทรน |
| GPTQ / AWQ / GGUF | รูปแบบ Quantization ที่ปรับแต่งมาสำหรับ LLM โดยเฉพาะ และแพร่หลายในฐานะรูปแบบการแจกจ่าย Local LLM |
QLoRA คือเทคนิคที่ผสมผสาน Quantization นี้เข้ากับ LoRA ซึ่งช่วยให้สามารถทำ Fine-tuning ในสถานะที่ถูก Quantize เป็น 4 บิตได้
เกณฑ์การตัดสินใจในการใช้งานจริง
มีผลการวิจัยหลายชิ้นรายงานว่า "การนำโมเดลขนาดใหญ่มา Quantize" ให้ประสิทธิภาพสูงกว่า "การใช้โมเดลขนาดเล็กที่มีความแม่นยำสูง" เมื่อต้องเลือกโมเดลในสภาพแวดล้อม Edge AI การค้นหาคำตอบที่เหมาะสมที่สุดจะขึ้นอยู่กับการผสมผสานระหว่างขนาดโมเดลและจำนวนบิตที่ใช้ใน Quantization
บทความที่กล่าวถึงคำศัพท์นี้
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน
- การออกแบบงบประมาณความหน่วงสำหรับ AI Agent — วิธีควบคุมการแลกเปลี่ยนระหว่างเวลาคิดและเวลาตอบสนองอธิบายปัญหา "เวลาคิด" ใน Multi-step reasoning agent ที่ทำให้เกิดความล่าช้า พร้อมเปรียบเทียบการจัดสรร Latency budget และรูปแบบการใช้งานตามความซับซ้อนของงาน
- วิธีเลือกใช้ Fine-tuning และ RAG: คู่มือเปรียบเทียบตามต้นทุน ความแม่นยำ และการใช้งานจริงเลือกใช้ Fine-tuning หรือ RAG ดี? เปรียบเทียบ 4 ปัจจัยหลัก (ต้นทุน, ความแม่นยำ, การอัปเดต, ความปลอดภัย) พร้อมเกณฑ์การเลือกที่เหมาะสมกับธุรกิจคุณ
- การอนุมาน AI ขนาดเล็กด้วย Firecracker: การรัน LLM ในสภาพแวดล้อม MicroVM และการเพิ่มประสิทธิภาพต้นทุนเรียนรู้วิธีสร้างสภาพแวดล้อม AI Inference น้ำหนักเบาด้วย Firecracker พร้อมขั้นตอนการรัน LLM บน MicroVM เพื่อเพิ่มประสิทธิภาพต้นทุน กลยุทธ์การขยายระบบ และแนวทางปฏิบัติที่ดีที่สุด


คำศัพท์ที่เกี่ยวข้อง
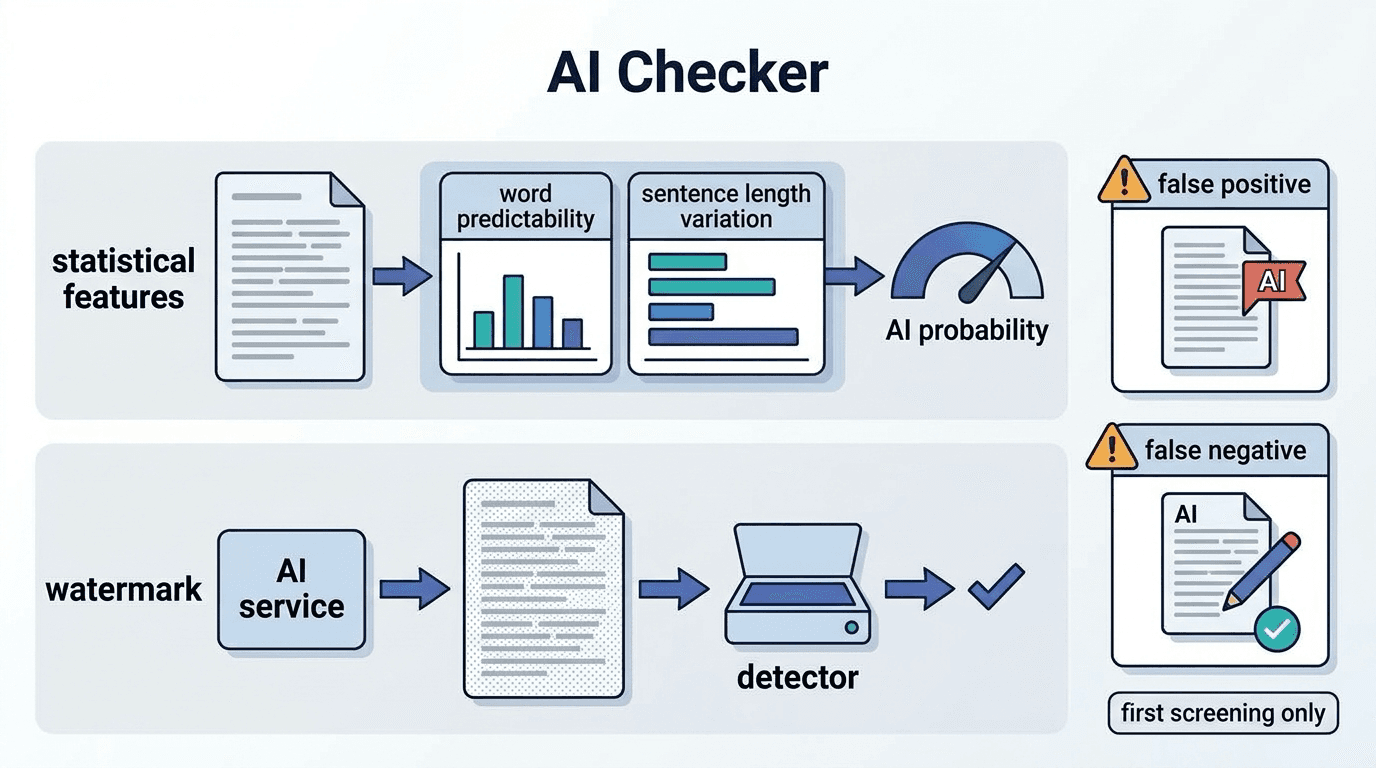
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
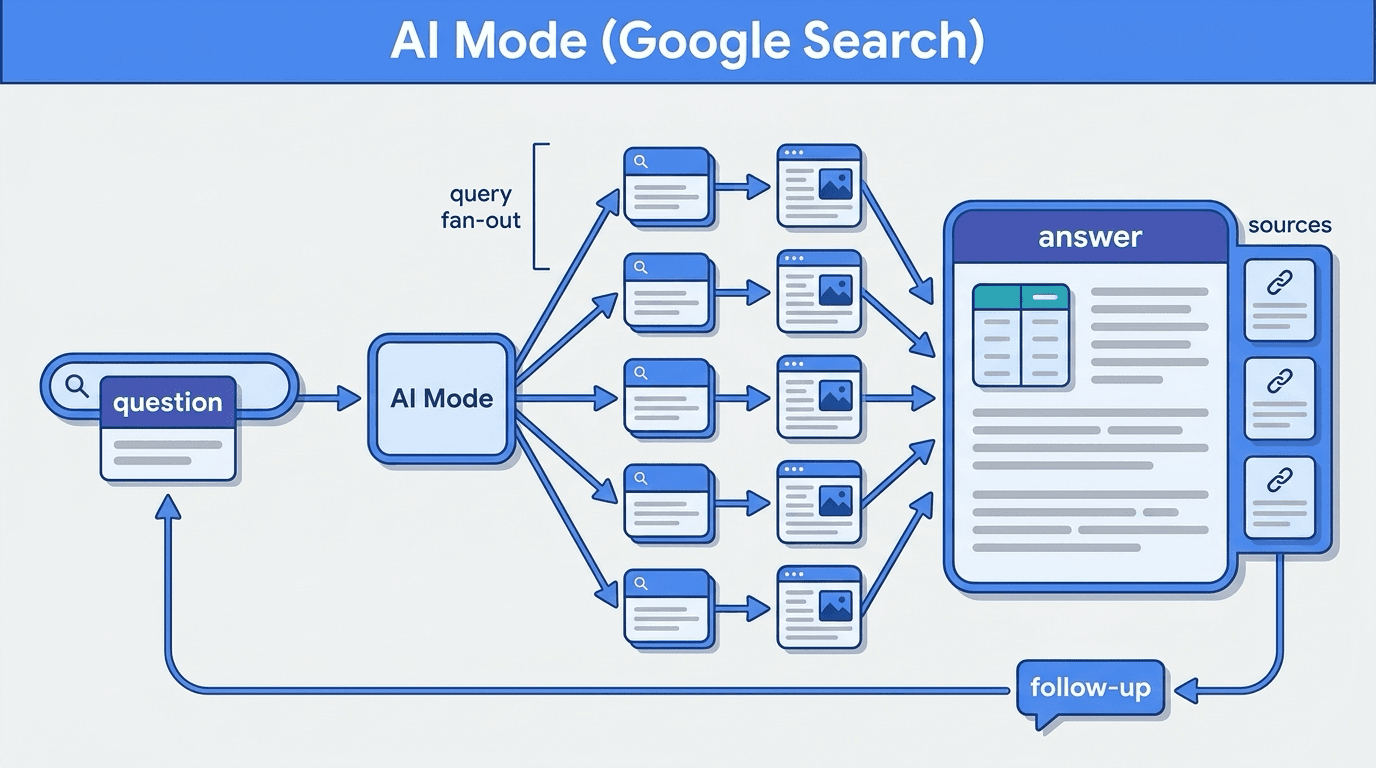
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
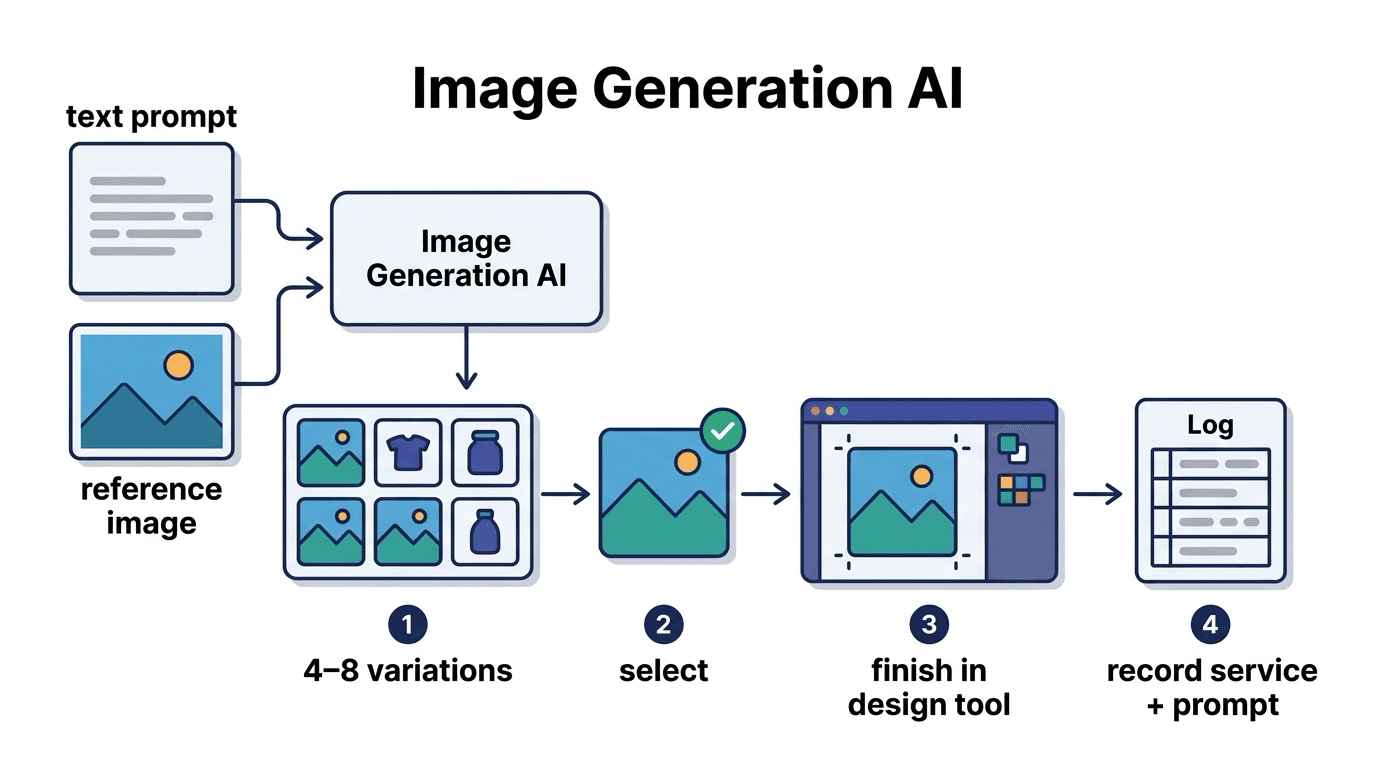
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
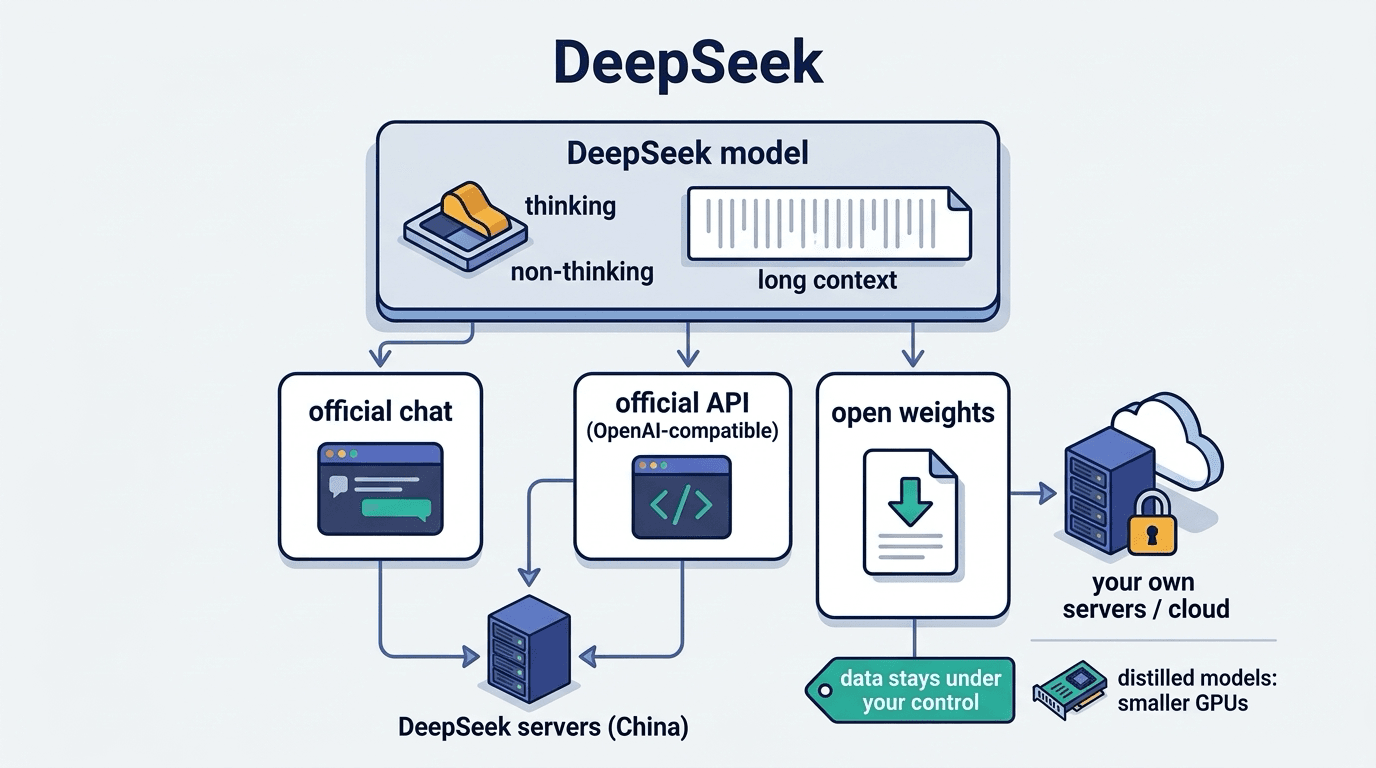
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ