การปรับขนาดในช่วงอนุมาน (Test-time Compute)

การปรับขนาดการประมวลผลในช่วง Inference (Inference-Time Scaling) คือวิธีการที่เพิ่มหรือลดปริมาณการคำนวณในช่วง Inference ของโมเดลอย่างพลวัต โดยใช้ "ขั้นตอนการคิด" มากขึ้นสำหรับปัญหาที่ซับซ้อน และตอบทันทีสำหรับปัญหาที่ง่าย
ขยายการเรียนรู้ หรือยืดการอนุมาน
การพัฒนาประสิทธิภาพของ LLM แบบดั้งเดิมนั้นมุ่งเน้นที่ "การ scaling ในช่วงเรียนรู้" เป็นหลัก ไม่ว่าจะเป็นข้อมูลที่มากขึ้น โมเดลที่ใหญ่ขึ้น หรือเวลาเรียนรู้ที่นานขึ้น วิวัฒนาการจาก GPT-3 สู่ GPT-4 คือตัวอย่างที่ชัดเจนของแนวทางนี้
การ scaling ในช่วงอนุมานมีแนวคิดที่แตกต่างออกไป โดยคงขนาดของโมเดลไว้เท่าเดิม แต่ปรับปริมาณการคำนวณที่ใช้ในช่วงอนุมานตามระดับความยากของปัญหา คำถามอย่าง "วันนี้อากาศเป็นอย่างไร?" ตอบได้ในขั้นตอนเดียว ในขณะที่ "ช่วยตรวจสอบการพิสูจน์ทางคณิตศาสตร์นี้" อาจต้องใช้การอนุมานภายในหลายสิบขั้นตอน แนวทางนี้ถูกนำมาใช้ใน o1/o3 ของ OpenAI และ extended thinking ของ Claude จาก Anthropic
กลไกการทำงาน
โมเดลจะสร้าง "thinking token" ภายใน และแสดงกระบวนการอนุมานอย่างชัดเจนจนกว่าจะได้คำตอบสุดท้าย สิ่งที่แตกต่างจาก Chain-of-Thought (CoT) prompting แบบที่สั่งจากภายนอก คือตัวโมเดลเองจะสร้าง reasoning chain ที่ยาวตามความจำเป็น
วิธีการควบคุม computation budget นั้นแตกต่างกันไปตามแต่ละโมเดล เช่น การกำหนดจำนวน token สูงสุด การหยุดเมื่อค่าความเชื่อมั่นเกินเกณฑ์ที่กำหนด หรือการรัน reasoning path หลายเส้นทางแบบขนานแล้วใช้การโหวตเสียงข้างมาก (Best-of-N)
เหตุใดจึงได้รับความสนใจ
การ scaling ในช่วงเรียนรู้มีข้อจำกัดที่เรียกว่า "กำแพงข้อมูล" และ "กำแพงต้นทุน" ข้อมูลเรียนรู้ที่มีคุณภาพสูงนั้นมีจำกัด และต้นทุนในการขยายโมเดลให้ใหญ่ขึ้นสองเท่าก็ไม่ได้เพิ่มขึ้นเพียงแค่สองเท่าเท่านั้น ในทางกลับกัน การ scaling ในช่วงอนุมานมีลักษณะคล้ายกับระบบจ่ายตามการใช้งาน ที่เสียค่าใช้จ่ายเฉพาะเมื่อจำเป็น ในการใช้งานจริงที่ query ส่วนใหญ่เป็นคำถามง่าย จึงสามารถลดต้นทุนเฉลี่ยได้ในขณะที่ยังรับมือกับปัญหายากได้อย่างมีประสิทธิภาพ
ณ ปี 2026 "hybrid scaling" ที่ผสมผสานทั้งการ scaling ในช่วงเรียนรู้และการ scaling ในช่วงอนุมานเข้าด้วยกัน กำลังกลายเป็นแนวทางหลักที่ได้รับความนิยมมากขึ้นเรื่อยๆ
บทความที่กล่าวถึงคำศัพท์นี้
- Inference-time Scaling คืออะไร? วิธีปรับสมดุลระหว่างต้นทุนและความแม่นยำของ AIเจาะลึกกลไก Test-Time Compute และวิธีเพิ่มประสิทธิภาพ Trade-off ระหว่างต้นทุนและความแม่นยำ พร้อมแนวทางออกแบบการใช้งาน LLM ให้คุ้มค่าในยุค Inference Model
- การอนุมาน AI ขนาดเล็กด้วย Firecracker: การรัน LLM ในสภาพแวดล้อม MicroVM และการเพิ่มประสิทธิภาพต้นทุนเรียนรู้วิธีสร้างสภาพแวดล้อม AI Inference น้ำหนักเบาด้วย Firecracker พร้อมขั้นตอนการรัน LLM บน MicroVM เพื่อเพิ่มประสิทธิภาพต้นทุน กลยุทธ์การขยายระบบ และแนวทางปฏิบัติที่ดีที่สุด
- การออกแบบงบประมาณความหน่วงสำหรับ AI Agent — วิธีควบคุมการแลกเปลี่ยนระหว่างเวลาคิดและเวลาตอบสนองอธิบายปัญหา "เวลาคิด" ใน Multi-step reasoning agent ที่ทำให้เกิดความล่าช้า พร้อมเปรียบเทียบการจัดสรร Latency budget และรูปแบบการใช้งานตามความซับซ้อนของงาน
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน


คำศัพท์ที่เกี่ยวข้อง
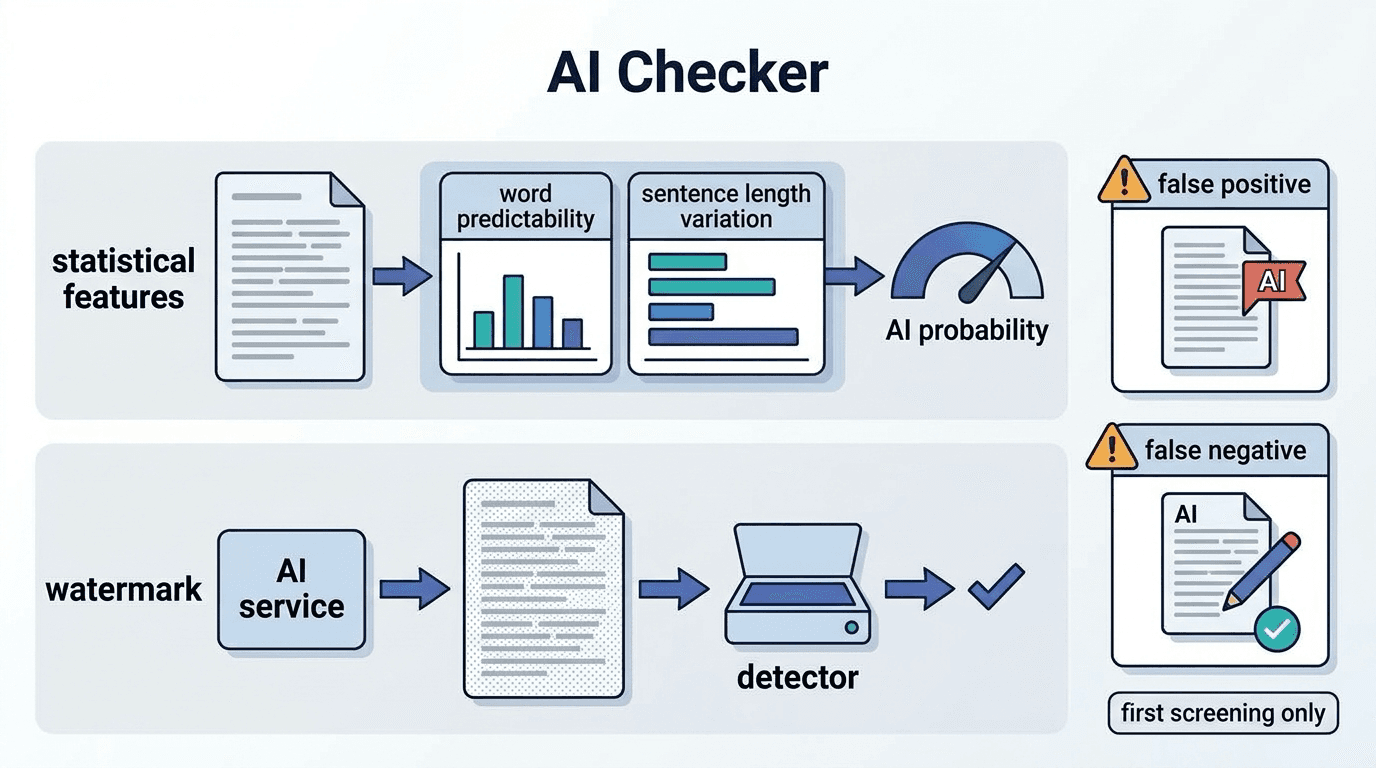
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
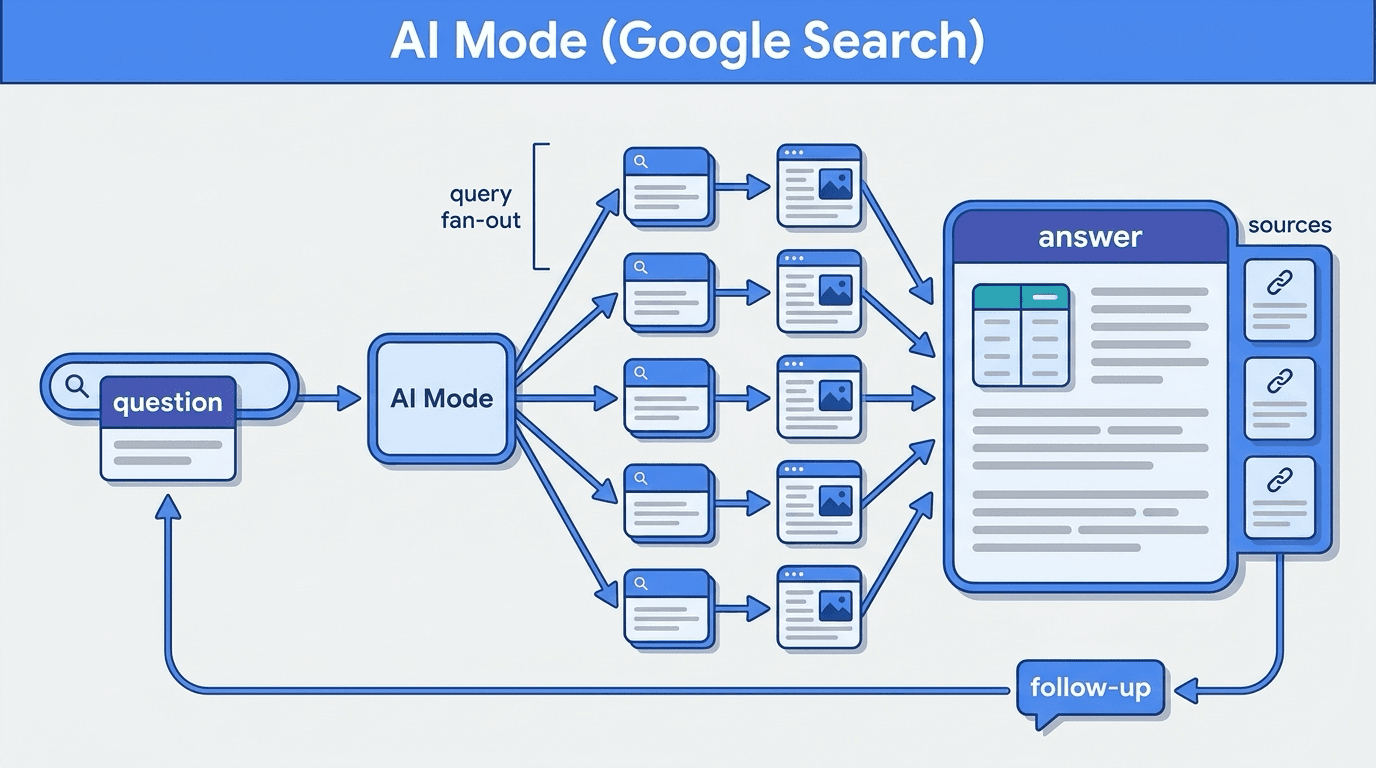
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
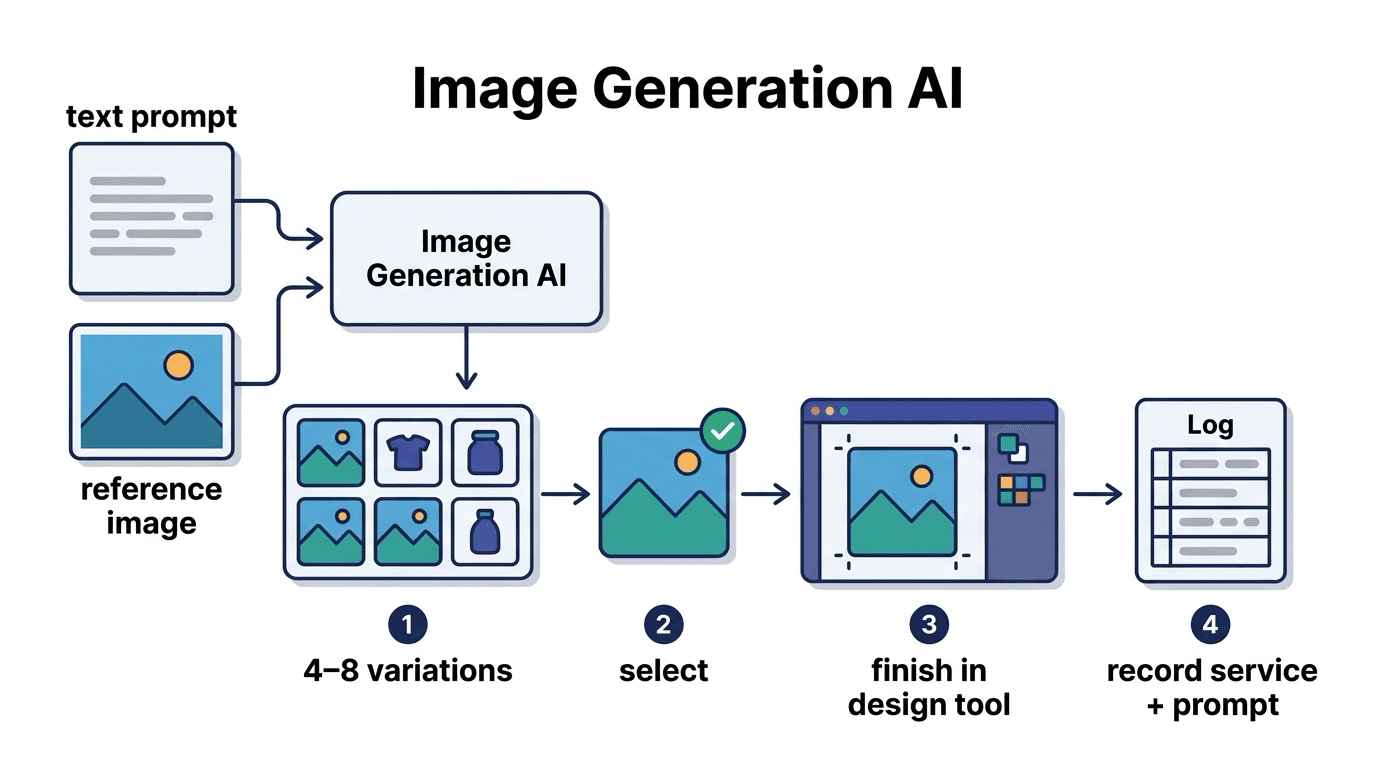
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
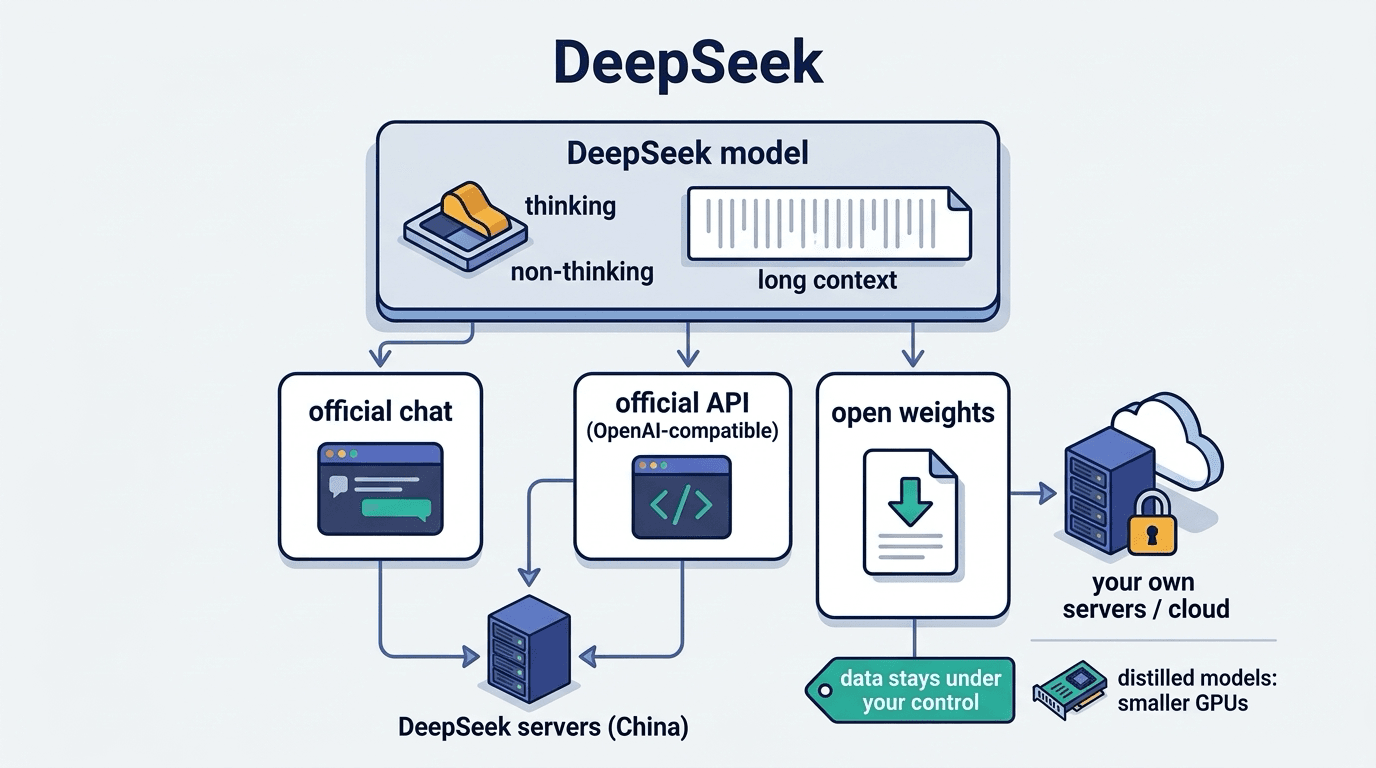
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ