PEFT

PEFT (Parameter-Efficient Fine-Tuning) คือชื่อเรียกรวมของวิธีการ fine-tuning ที่ปรับโมเดลให้เข้ากับงานเฉพาะด้วยทรัพยากรการคำนวณและข้อมูลที่น้อยลง โดยอัปเดตเพียงบางส่วนของพารามิเตอร์ในโมเดลภาษาขนาดใหญ่ แทนที่จะอัปเดตพารามิเตอร์ทั้งหมด
การฝึก LLM ที่มีพารามิเตอร์หลายพันล้านตัวแบบเต็มรูปแบบนั้น แม้จะใช้ A100 ถึง 8 ใบ ก็ยังต้องใช้เวลามากกว่าครึ่งวัน ในสภาพแวดล้อมที่มีงบประมาณและฮาร์ดแวร์จำกัด ตัวเลือกนี้มักไม่ได้รับการพิจารณาตั้งแต่ต้น PEFT เอาชนะอุปสรรคนี้ด้วยแนวทาง "แช่แข็งพารามิเตอร์ส่วนใหญ่ของโมเดล แล้วฝึกเฉพาะพารามิเตอร์ส่วนน้อยที่เพิ่มเข้ามา"
เมื่อจัดระเบียบวิธีการที่เป็นตัวแทน จะได้ดังนี้
- LoRA (Low-Rank Adaptation) — แทรกส่วนต่างของ rank ต่ำลงในเมทริกซ์น้ำหนัก พารามิเตอร์ที่เพิ่มเข้ามาอยู่ที่ประมาณ 0.1〜1% ของโมเดลทั้งหมด เป็นวิธีที่ได้รับการนำไปใช้มากที่สุดในปัจจุบัน
- QLoRA — ผสมผสาน LoRA เข้ากับการ quantization แบบ 4bit เพื่อบีบอัด GPU memory ให้เหลือไม่ถึงครึ่ง สามารถฝึกโมเดล 7B ได้แม้บน consumer GPU
- Prefix Tuning / Prompt Tuning — วิธีการเพิ่มเวกเตอร์ที่ฝึกได้ทางฝั่ง input โดยไม่แตะต้องตัวโมเดลหลักเลย
- Adapter — แทรก bottleneck layer ระหว่าง Transformer layer เป็นวิธีหลักก่อนที่ LoRA จะปรากฏขึ้น แต่ปัจจุบันความนิยมลดลงบ้าง
ทีมของผู้เขียนได้ฝึก LLM ขนาด 7B พารามิเตอร์ด้วย LoRA บน A100 เพียง 1 ใบ ใช้เวลาประมาณ 3 ชั่วโมง และสามารถเพิ่มความแม่นยำเฉพาะงานได้ 15〜20% เมื่อเทียบกับ base model หากใช้ Full FT งานเดียวกันต้องการ A100×8 และใช้เวลา 12 ชั่วโมง ความแตกต่างด้านต้นทุนจึงชัดเจนมาก
อย่างไรก็ตาม PEFT ไม่ใช่วิธีที่ใช้ได้กับทุกกรณี การให้โมเดลได้รับความสามารถที่ไม่มีอยู่เดิม เช่น การสร้างข้อความในภาษาที่ยังไม่รองรับ ด้วย PEFT เพียงอย่างเดียวนั้นเป็นเรื่องยาก ในกรณีดังกล่าวจำเป็นต้องใช้ร่วมกับ Continued Pre-training
มักมีคำถามว่า "ควรใช้ PEFT หรือ RAG" แต่ที่จริงแล้วทั้งสองมีบทบาทต่างกัน RAG ทำหน้าที่อ้างอิงความรู้จากภายนอก ส่วน PEFT ทำหน้าที่ปรับพฤติกรรมและสไตล์ของโมเดล หากต้องการให้อ้างอิงความรู้ภายในองค์กรได้อย่างแม่นยำให้ใช้ RAG หากต้องการปรับโทนหรือรูปแบบของคำตอบให้ใช้ PEFT นี่คือจุดเริ่มต้นของการแบ่งการใช้งานในทางปฏิบัติ และการนำทั้งสองมาใช้ร่วมกันก็ไม่ใช่เรื่องแปลก
บทความที่กล่าวถึงคำศัพท์นี้
- PEFT (Parameter-Efficient Fine-Tuning) คืออะไร? เทคนิคลดต้นทุนการปรับแต่ง AI Model ได้ถึง 90%อธิบาย PEFT (Parameter-Efficient Fine-Tuning) และวิธีหลัก (LoRA, QLoRA, Adapter) สำหรับผู้บริหาร พร้อมกรณีศึกษา GPU และแนวทางตัดสินใจลงทุน
- คู่มือเริ่มต้นการทำ Fine-tuning: พื้นฐานและเกณฑ์การตัดสินใจสำหรับองค์กร B2B ก่อนสร้าง LLM ของตนเองอธิบายกลไก Fine-tuning ตั้งแต่พื้นฐาน ความสัมพันธ์กับ PEFT/LoRA การเลือกใช้ร่วมกับ RAG การคำนวณต้นทุน และเช็คลิสต์สำหรับธุรกิจ B2B ในการพัฒนาโมเดลเอง
- วิธีเลือกใช้ Fine-tuning และ RAG: คู่มือเปรียบเทียบตามต้นทุน ความแม่นยำ และการใช้งานจริงเลือกใช้ Fine-tuning หรือ RAG ดี? เปรียบเทียบ 4 ปัจจัยหลัก (ต้นทุน, ความแม่นยำ, การอัปเดต, ความปลอดภัย) พร้อมเกณฑ์การเลือกที่เหมาะสมกับธุรกิจคุณ
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน


คำศัพท์ที่เกี่ยวข้อง
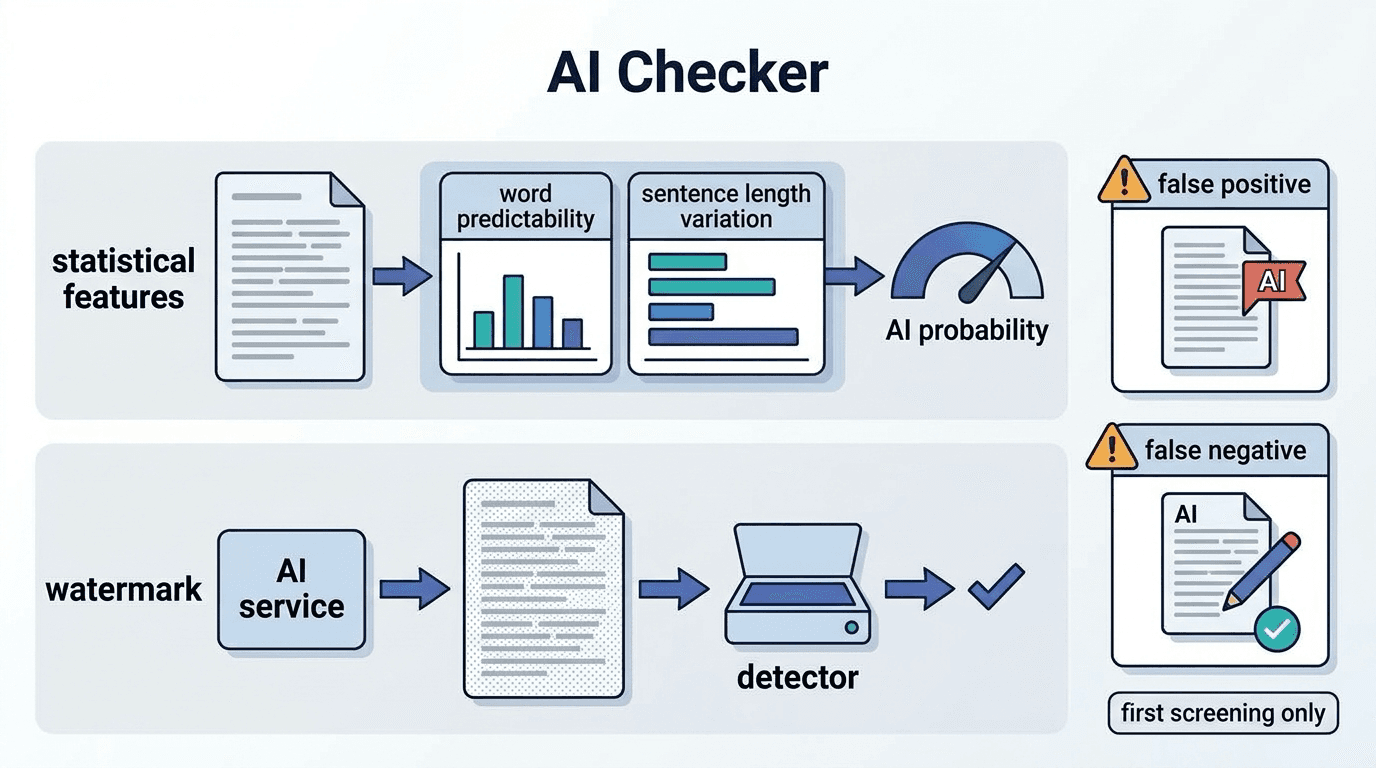
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
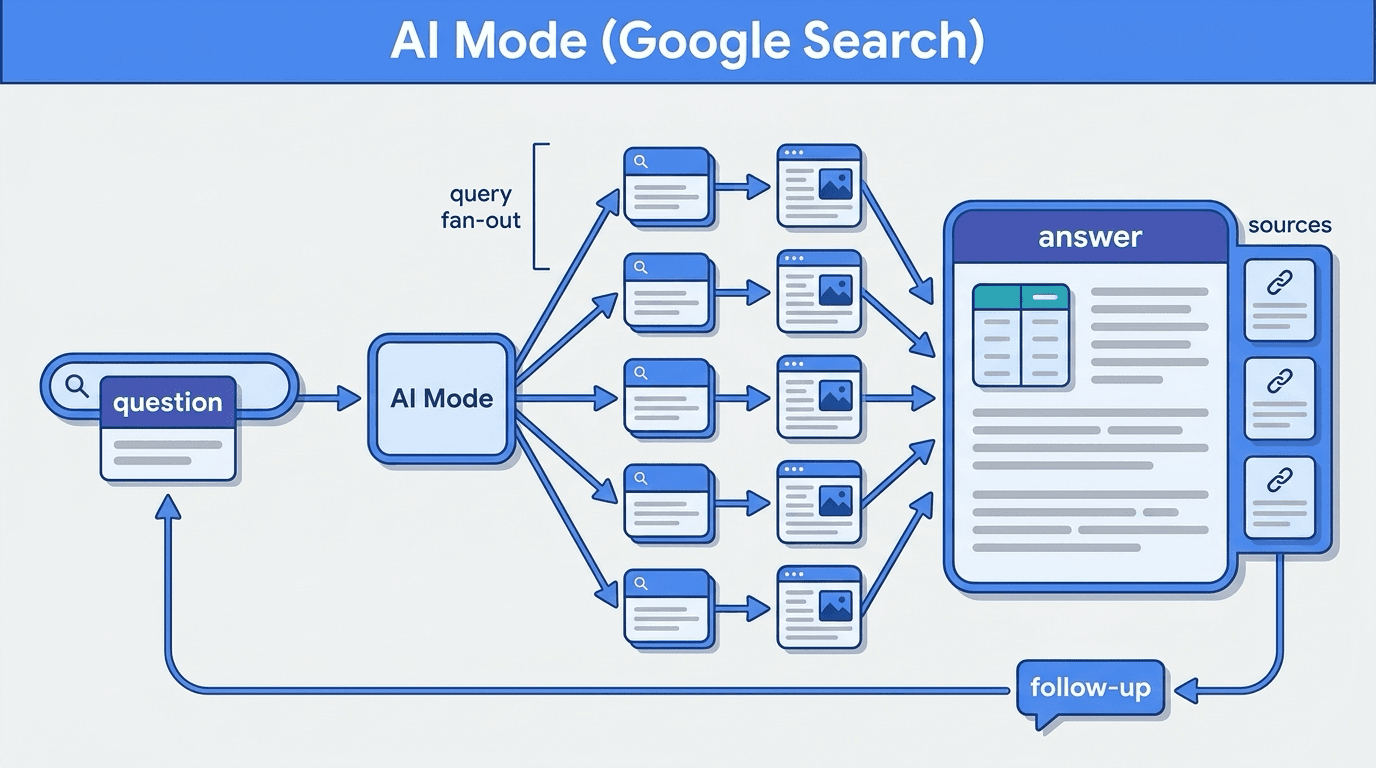
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
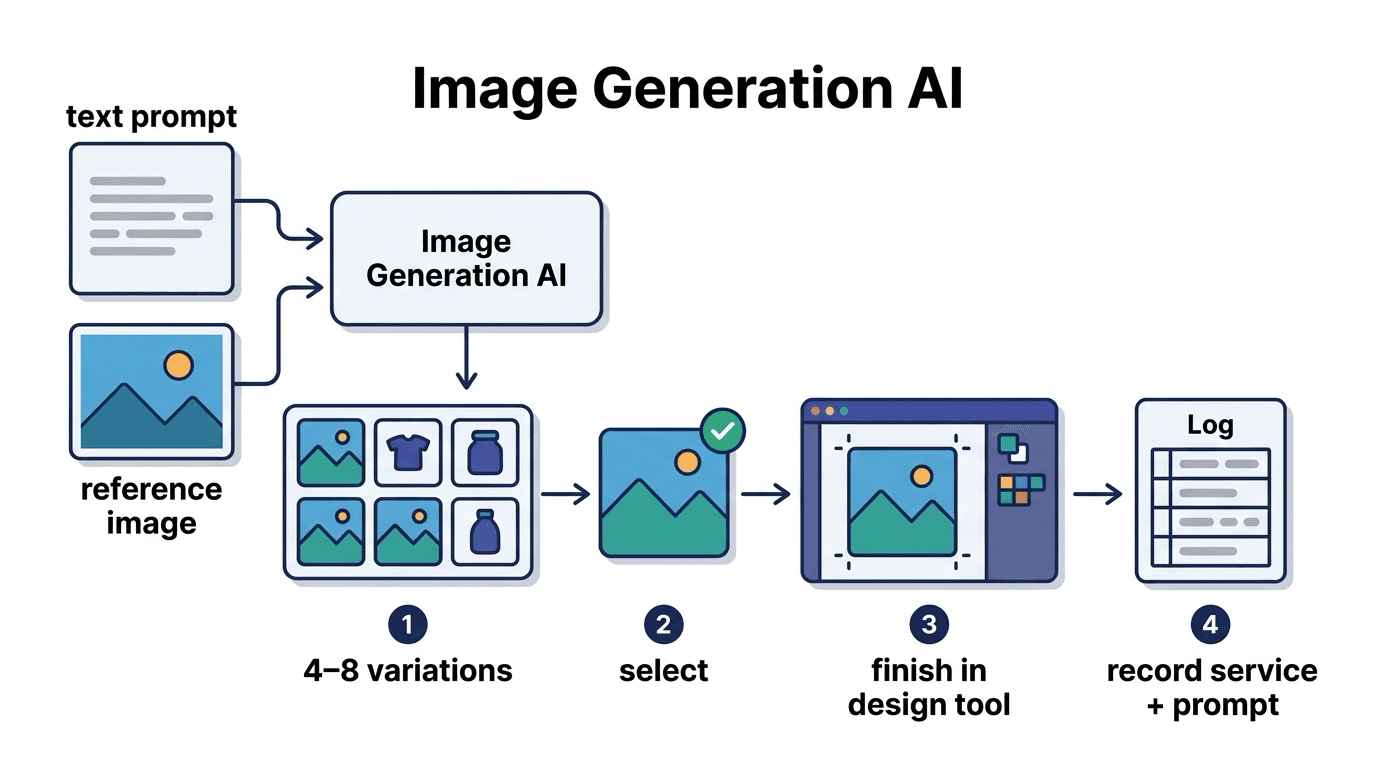
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
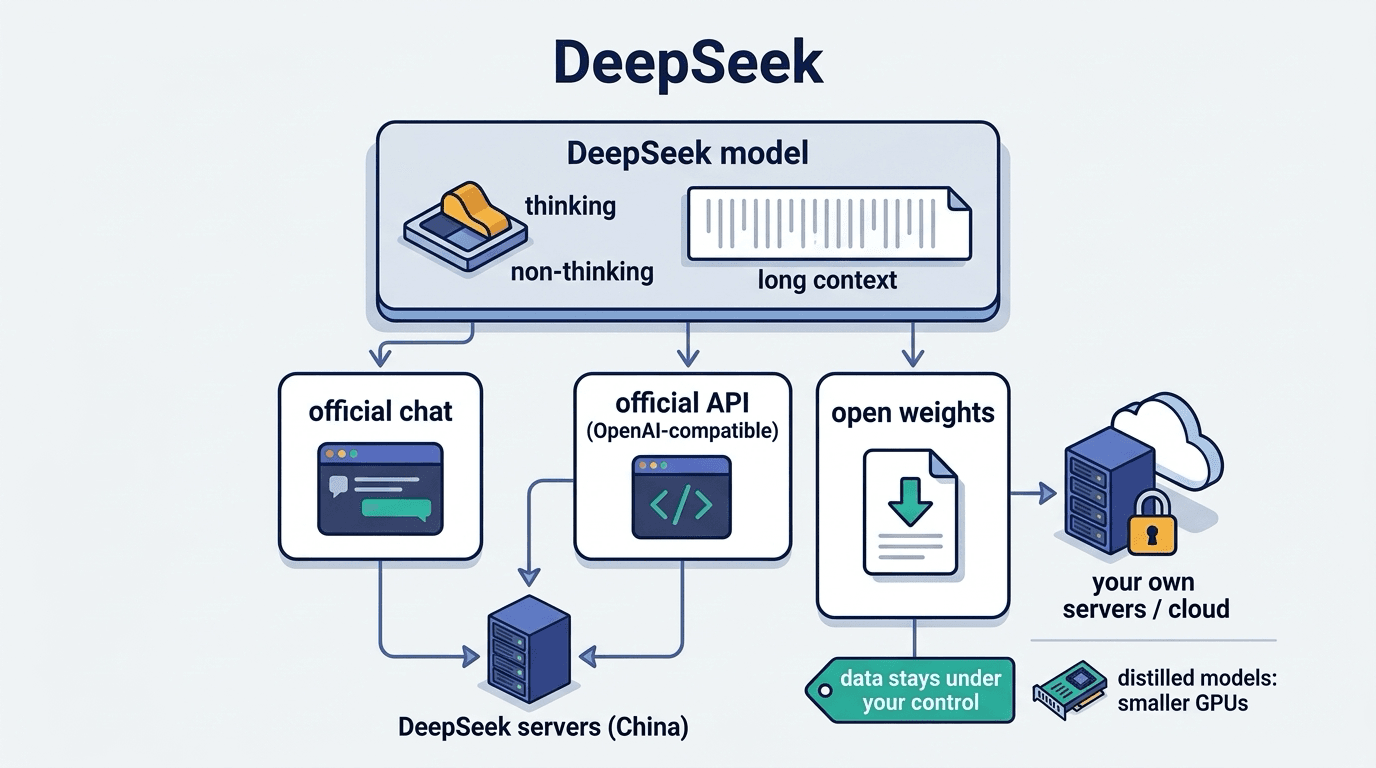
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ