SLM (Small Language Model) โมเดลภาษาขนาดเล็ก

SLM (Small Language Model) คือชื่อเรียกรวมของโมเดลภาษาที่จำกัดจำนวนพารามิเตอร์ไว้ที่ระดับหลายพันล้านถึงประมาณหนึ่งหมื่นล้านพารามิเตอร์ โดยมีคุณสมบัติเด่นคือสามารถทำ Inference และ Fine-tuning ได้โดยใช้ทรัพยากรการคำนวณน้อยกว่า LLM
"เล็ก" ไม่ได้แปลว่า "อ่อนแอ"
ในโลกของ LLM นั้น "ยิ่งใหญ่ยิ่งฉลาด" ถือเป็นความเชื่อที่ยึดถือกันมายาวนาน GPT-4 มีพารามิเตอร์โดยประมาณถึง 1.8 ล้านล้านตัว ในขณะที่ SLM มีเพียง 1B ถึง 10B เท่านั้น ซึ่งต่างกันถึงสองหลัก อย่างไรก็ตาม หลังจากปี 2025 เป็นต้นมา ความเชื่อนี้กำลังพังทลายลงอย่างรวดเร็ว
Phi-4 (14B) ของ Microsoft ทำคะแนนในบางเบนช์มาร์กด้านการอนุมานได้เทียบเท่ากับ GPT-4o ส่วน Gemma 3 ของ Google ที่มีขนาดตั้งแต่ 1B ถึง 27B นั้น มีประสิทธิภาพต่อขนาดที่สูงมาก ด้วยการปรับปรุงสถาปัตยกรรมของโมเดลและการคัดสรรข้อมูลการเรียนรู้คุณภาพสูง ทำให้ "เล็กแต่มีประสิทธิภาพเพียงพอสำหรับงานเฉพาะด้าน" กลายเป็นความเป็นจริงขึ้นมาแล้ว
ใช้งานที่ไหนบ้าง
สนามรบหลักของ SLM มีอยู่ 3 แห่ง
Edge Device: สภาพแวดล้อมที่มีทรัพยากร GPU จำกัด เช่น สมาร์ทโฟน, IoT Gateway และอุปกรณ์ embedded ต่าง ๆ การที่ Apple รันการอนุมานแบบ on-device บน iPhone ถือเป็นตัวอย่างที่ชัดเจนของ SLM
การเพิ่มประสิทธิภาพด้านต้นทุน: การใช้โมเดลระดับ GPT-4 กับงานประจำ เช่น การจำแนกประเภท การสรุปความ และการดึงข้อมูล ถือว่าเกินความจำเป็น SLM สามารถลดต้นทุนการอนุมานลงได้มากกว่า 10 เท่าในบางกรณี
ข้อกำหนดด้าน Latency: สถานการณ์ที่ต้องการการตอบสนองในระดับหลายสิบมิลลิวินาที เช่น แชทแบบเรียลไทม์ การตอบสนองด้วยเสียง และ Game AI เนื่องจากมีพารามิเตอร์น้อยกว่า ความเร็วในการอนุมานจึงเร็วกว่าอย่างเห็นได้ชัด
การแบ่งบทบาทระหว่าง LLM และ SLM
ในสถานการณ์ที่ต้องการคำตอบแบบครอบจักรวาล เช่น การอนุมานที่ซับซ้อน การรองรับหลายภาษา และการสร้างข้อความยาว LLM ยังคงมีความได้เปรียบอยู่ ในทางกลับกัน หากสามารถจำกัดขอบเขตของงานได้ การ Fine-tuning SLM อาจให้ผลดีกว่าทั้งในด้านความแม่นยำ ความเร็ว และต้นทุน
ในทางปฏิบัติ กระบวนการที่กำลังกลายเป็นมาตรฐานคือ "สร้างต้นแบบด้วย LLM API ก่อน แล้วเมื่องานชัดเจนแล้วจึง distill ลงสู่ SLM เพื่อลดต้นทุน" โดย distillation (การกลั่น) คือเทคนิคการฝึกโมเดลขนาดเล็กโดยใช้ผลลัพธ์จากโมเดลขนาดใหญ่เป็นข้อมูลสำหรับการสอน
บทความที่กล่าวถึงคำศัพท์นี้
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน
- SLM Distillation คืออะไร? วิธีสร้างโมเดลขนาดเล็กเฉพาะทางจาก LLM ขนาดใหญ่เรียนรู้วิธีสร้าง SLM Distillation เพื่อพัฒนาโมเดลขนาดเล็กเฉพาะทางด้วยต้นทุนต่ำ โดยใช้ LLM ขนาดใหญ่เป็นครู พร้อมอธิบายกลไกและขั้นตอนการใช้งานจริง
- คู่มือการออกแบบไฮบริด Cloud LLM × On-device SLM — กลยุทธ์การจัดเส้นทางงาน (Task Routing)เจาะลึกกลยุทธ์การทำ Hybrid Design ระหว่าง Cloud LLM และ On-device SLM พร้อมเทคนิคการ Routing งานตามต้นทุน ความหน่วง และการปฏิบัติตามข้อกำหนด
- การออกแบบงบประมาณความหน่วงสำหรับ AI Agent — วิธีควบคุมการแลกเปลี่ยนระหว่างเวลาคิดและเวลาตอบสนองอธิบายปัญหา "เวลาคิด" ใน Multi-step reasoning agent ที่ทำให้เกิดความล่าช้า พร้อมเปรียบเทียบการจัดสรร Latency budget และรูปแบบการใช้งานตามความซับซ้อนของงาน


คำศัพท์ที่เกี่ยวข้อง
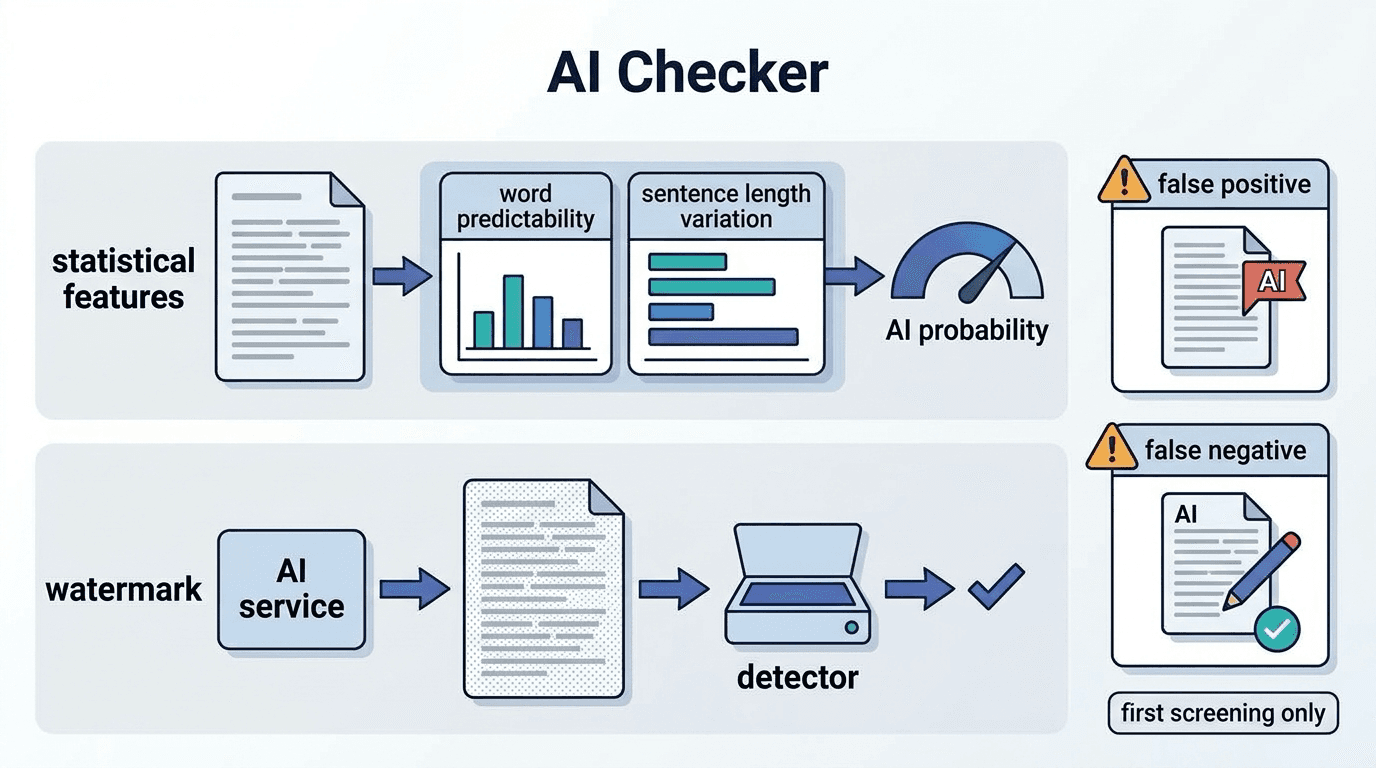
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
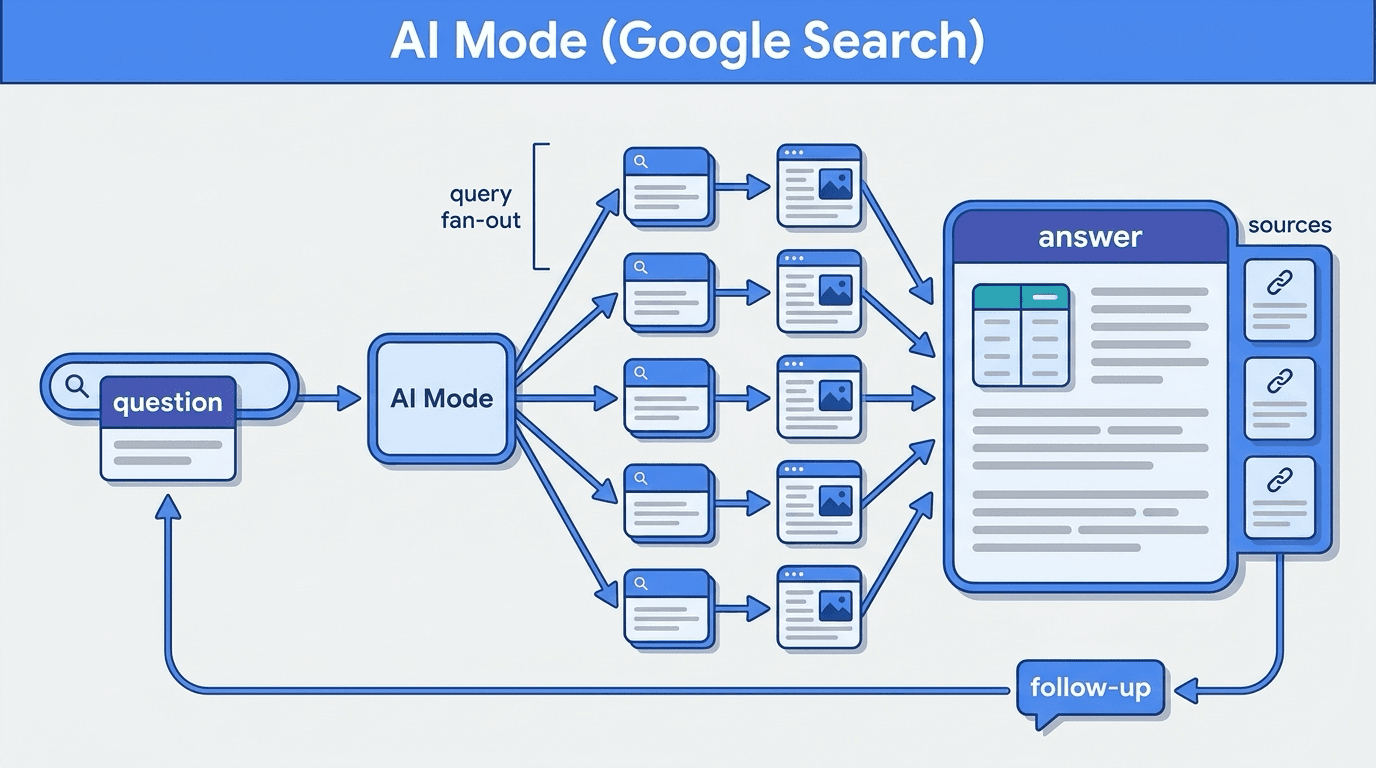
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
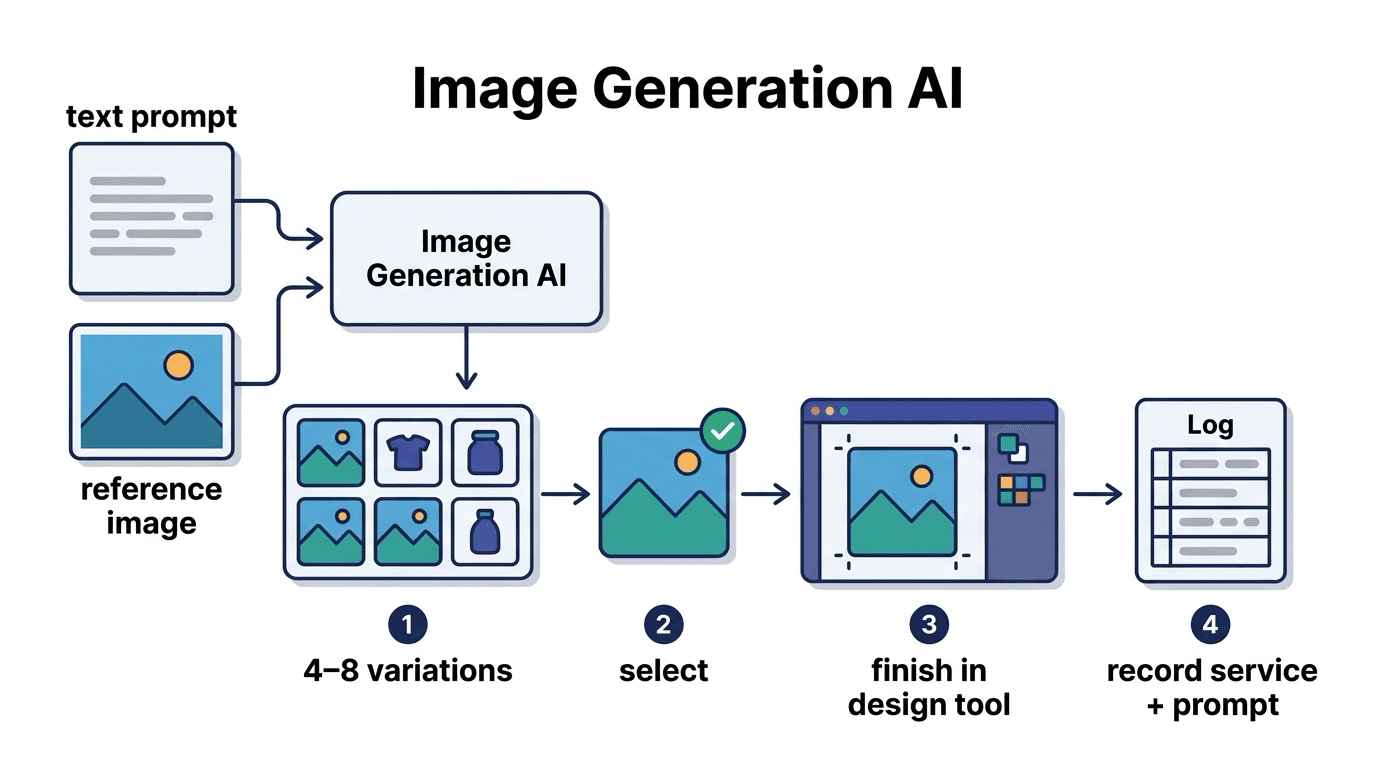
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
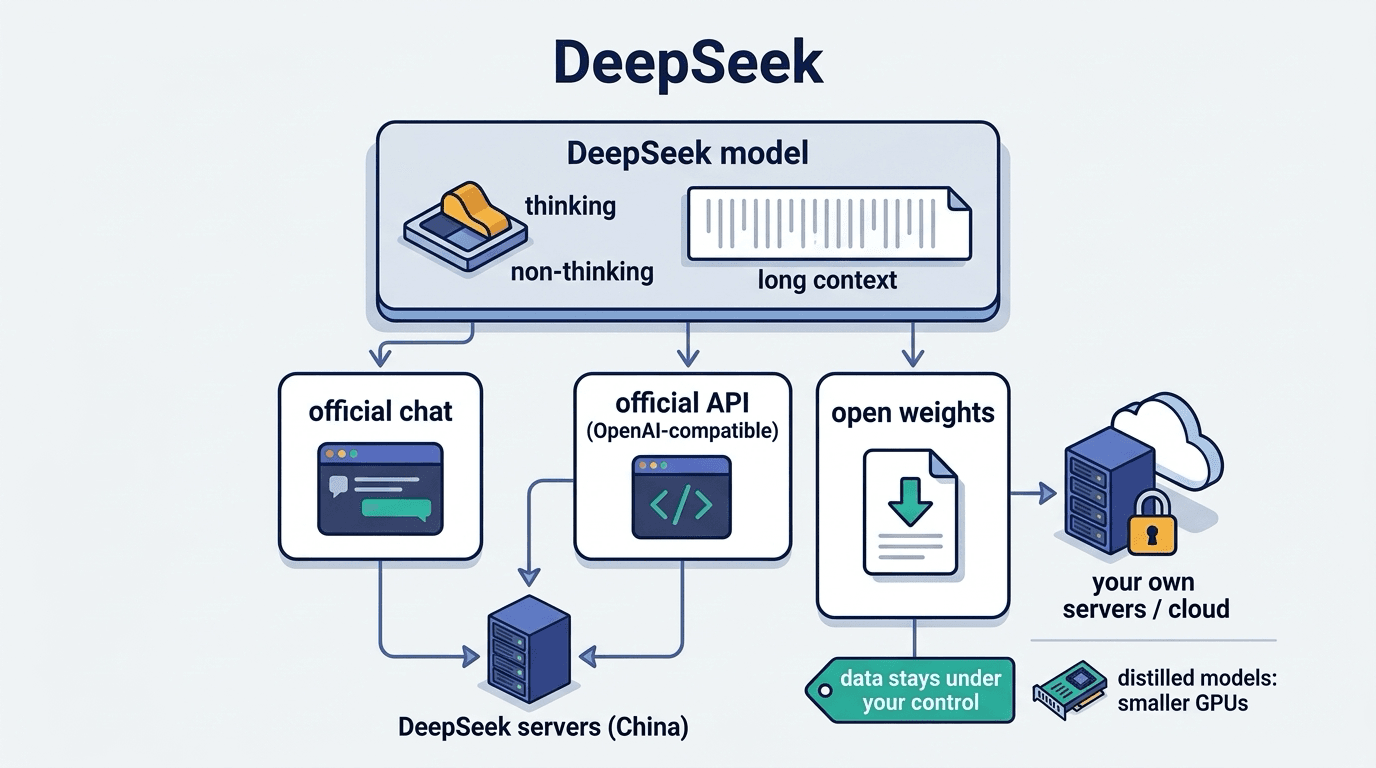
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ