MoE (Mixture of Experts) หรือ การผสมผสานผู้เชี่ยวชาญ
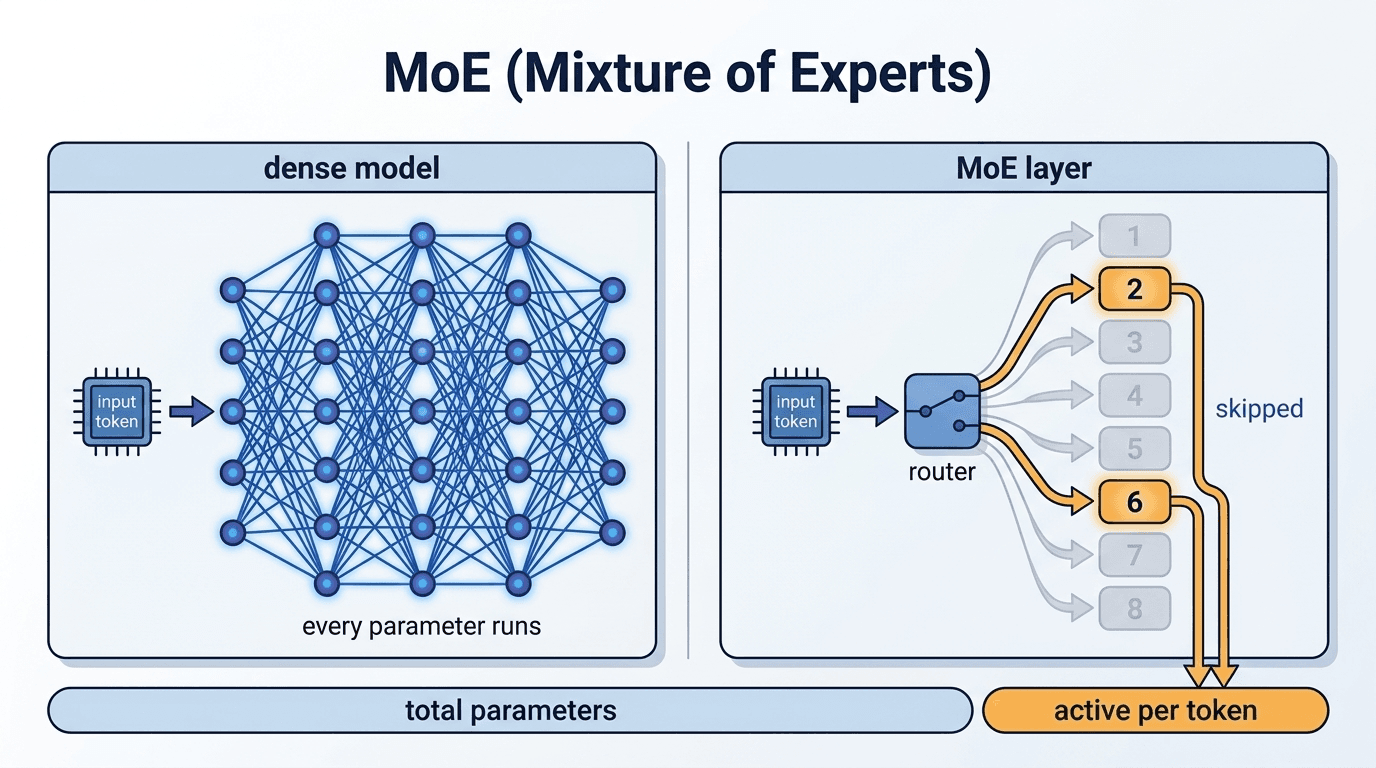
MoE (Mixture of Experts) คือสถาปัตยกรรมที่มี "ผู้เชี่ยวชาญ" (Expert) ซับเน็ตเวิร์กหลายตัวภายในโมเดล โดยจะเปิดใช้งานเพียงบางส่วนสำหรับแต่ละอินพุต ซึ่งช่วยให้สามารถเพิ่มจำนวนพารามิเตอร์ทั้งหมดได้ในขณะที่ยังควบคุมต้นทุนการอนุมานให้อยู่ในระดับต่ำ
เร็วเพราะไม่ได้ใช้ทั้งหมด
เหตุใดโมเดลขนาดใหญ่อย่าง GPT-4 หรือ Llama 4 จึงสามารถ inference ได้ด้วยความเร็วที่ค่อนข้างเป็นจริงในทางปฏิบัติ คำตอบหนึ่งคือสถาปัตยกรรม MoE
ใน Transformer model แบบปกติ (Dense model) token ที่รับเข้ามาจะผ่านพารามิเตอร์ทั้งหมด หากเป็นโมเดลขนาด 100B พารามิเตอร์ น้ำหนัก 100B ตัวจะเข้าร่วมในการคำนวณทุกครั้ง แต่ใน MoE แม้โมเดลทั้งหมดจะมีพารามิเตอร์ถึง 2 ล้านล้านตัว การ inference แต่ละครั้งจะใช้จริงเพียงประมาณ 170B เท่านั้น — expert ที่เหลือจะถูกข้ามไปในฐานะ "ไม่มีบทบาทในรอบนี้"
สิ่งที่ทำหน้าที่ตัดสินใจว่าจะใช้ expert ใดคือ "gating network" (router) ซึ่งจะพิจารณาลักษณะของ token ที่รับเข้ามาแล้วเลือก expert ที่เหมาะสมที่สุด 2–4 ตัว เข้าใจได้ง่ายๆ ว่า หากเป็นโจทย์คณิตศาสตร์ก็จะเลือก expert สายลอจิก หากเป็นงานแปลภาษาก็จะเลือก expert สายภาษา
โมเดลที่นำไปใช้จริง
Llama 4 ของ Meta นำสถาปัตยกรรมนี้มาใช้ใน Scout (17B active / 109B total) และ Maverick (17B active / 400B total) ซีรีส์ Gemini ของ Google ก็ถูกระบุว่าใช้พื้นฐาน MoE เช่นกัน ส่วน Mixtral 8x7B ของ Mistral มีโครงสร้างที่รวม expert ขนาด 7B พารามิเตอร์จำนวน 8 ตัวเข้าด้วยกัน โดยใช้เพียง 2 ตัวในระหว่างการ inference
สิ่งที่มีเหมือนกันคือ "active parameter ในระหว่างการ inference น้อยกว่าจำนวนพารามิเตอร์ทั้งหมดอย่างมาก" ซึ่งช่วยให้รักษาความจุด้านความรู้ของโมเดลไว้ได้ ขณะเดียวกันก็ควบคุมความเร็วในการ inference และต้นทุนให้อยู่ในระดับที่เป็นจริงในทางปฏิบัติ
การเลือกใช้ร่วมกับ Dense model
Dense model ที่ใช้พารามิเตอร์ทั้งหมดนั้นเรียบง่ายและจัดการได้ง่ายในระดับขนาดเล็กถึงกลาง การ fine-tuning ก็ทำได้ตรงไปตรงมา MoE เป็นสถาปัตยกรรมที่แสดงศักยภาพที่แท้จริงในโมเดลขนาดใหญ่ และอาจไม่คุ้มค่ากับ overhead สำหรับโมเดลที่มีขนาดต่ำกว่าหลักสิบ B
นอกจากนี้ การ fine-tuning โมเดล MoE ยังต้องระมัดระวังไม่ให้ส่งผลกระทบต่อ expert ทั้งหมด และยังต้องอาศัยความรู้เฉพาะทางในการผสมผสานกับวิธี PEFT อย่าง LoRA เป็นต้น
บทความที่กล่าวถึงคำศัพท์นี้
- การออกแบบงบประมาณความหน่วงสำหรับ AI Agent — วิธีควบคุมการแลกเปลี่ยนระหว่างเวลาคิดและเวลาตอบสนองอธิบายปัญหา "เวลาคิด" ใน Multi-step reasoning agent ที่ทำให้เกิดความล่าช้า พร้อมเปรียบเทียบการจัดสรร Latency budget และรูปแบบการใช้งานตามความซับซ้อนของงาน
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน
- วิธีเลือกใช้ Fine-tuning และ RAG: คู่มือเปรียบเทียบตามต้นทุน ความแม่นยำ และการใช้งานจริงเลือกใช้ Fine-tuning หรือ RAG ดี? เปรียบเทียบ 4 ปัจจัยหลัก (ต้นทุน, ความแม่นยำ, การอัปเดต, ความปลอดภัย) พร้อมเกณฑ์การเลือกที่เหมาะสมกับธุรกิจคุณ
- PEFT (Parameter-Efficient Fine-Tuning) คืออะไร? เทคนิคลดต้นทุนการปรับแต่ง AI Model ได้ถึง 90%อธิบาย PEFT (Parameter-Efficient Fine-Tuning) และวิธีหลัก (LoRA, QLoRA, Adapter) สำหรับผู้บริหาร พร้อมกรณีศึกษา GPU และแนวทางตัดสินใจลงทุน


คำศัพท์ที่เกี่ยวข้อง
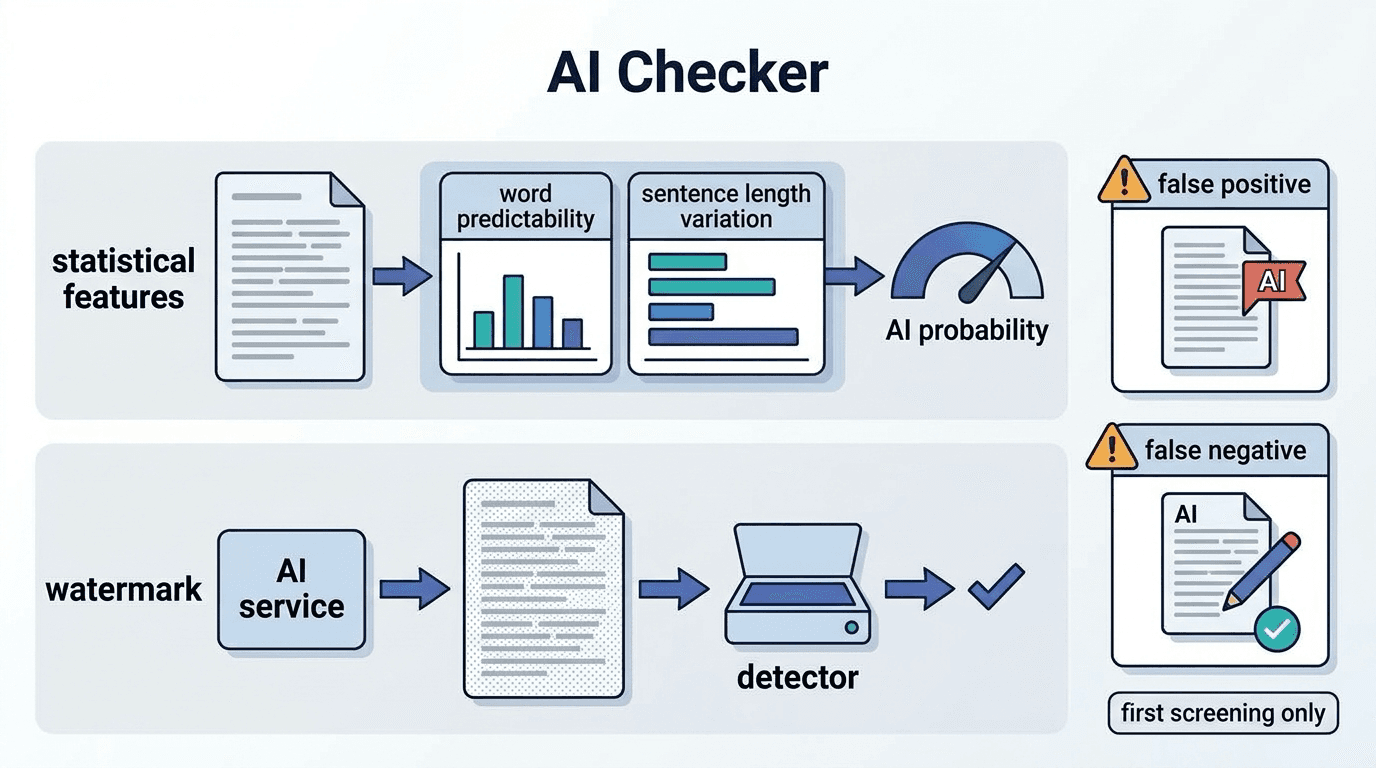
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
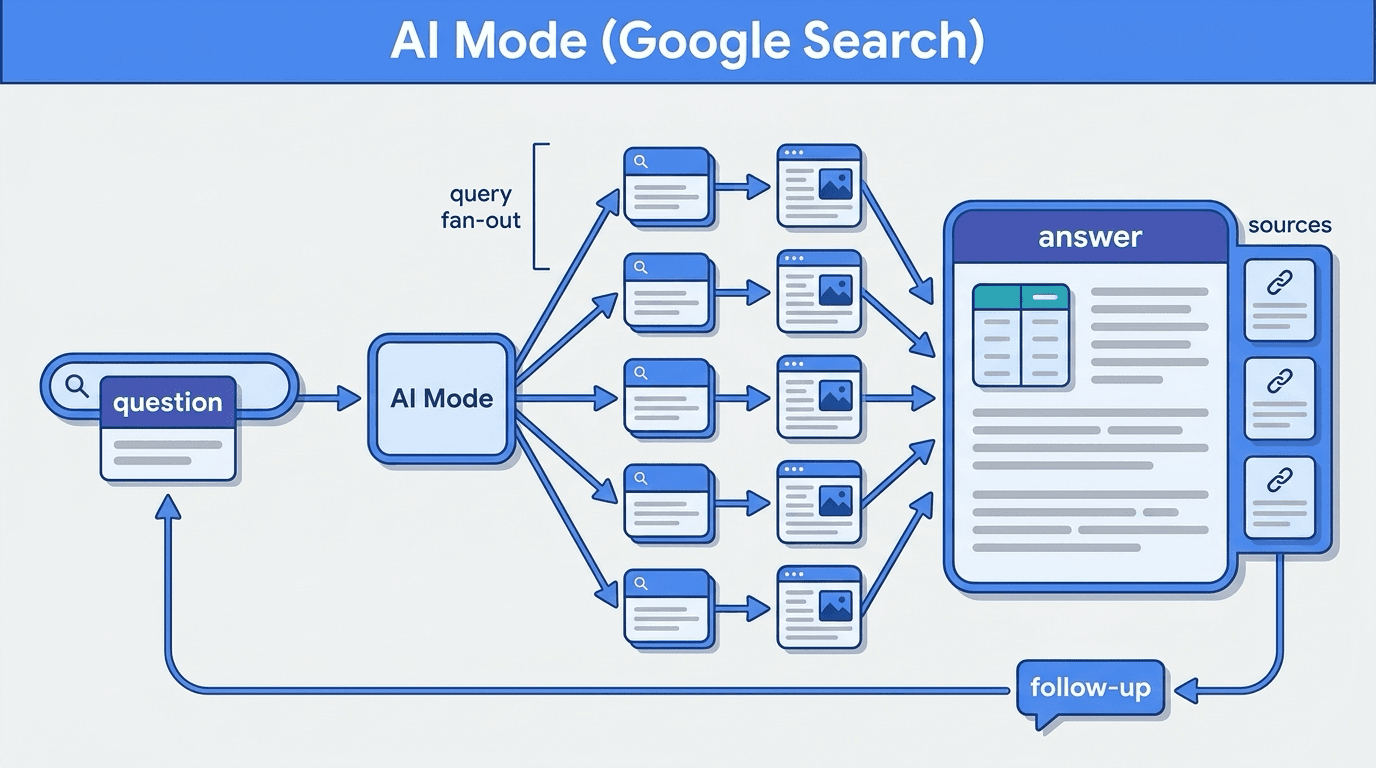
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
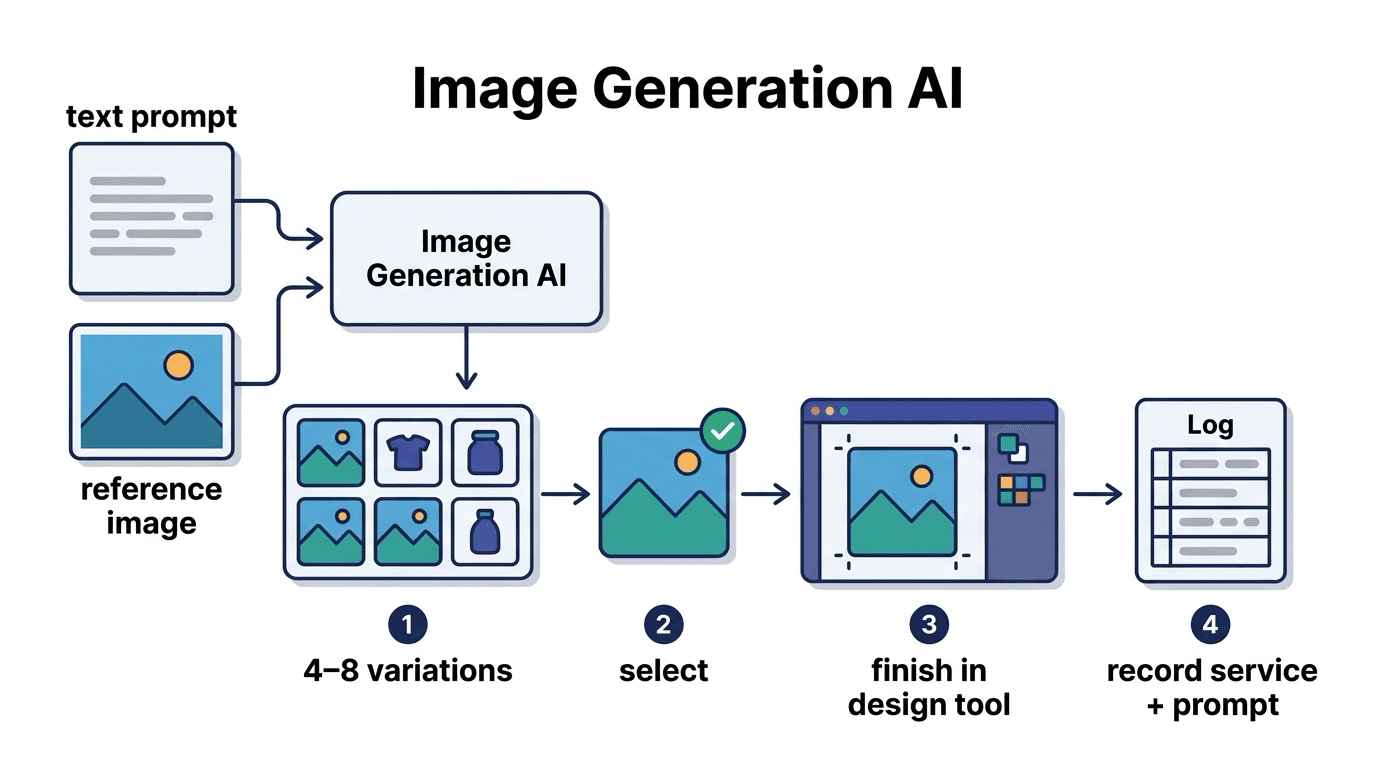
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
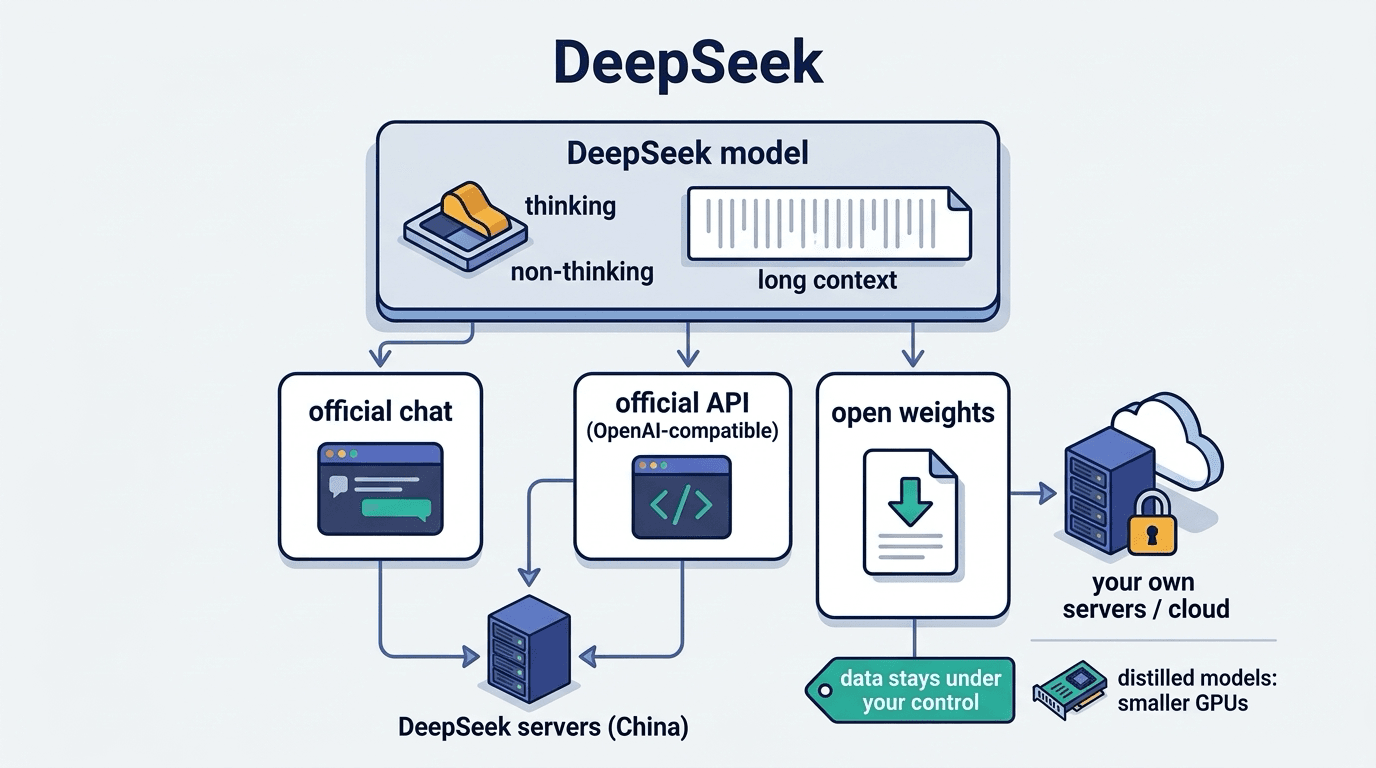
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ