Dense Model (โมเดลแบบหนาแน่น)

Dense Model (โมเดลแบบเชื่อมต่อหนาแน่น) คือสถาปัตยกรรมเครือข่ายประสาทเทียมที่ใช้พารามิเตอร์ทั้งหมดของโมเดลในการคำนวณระหว่างการอนุมาน ต่างจาก MoE (Mixture of Experts) ที่เปิดใช้งานเฉพาะบางส่วนของ Expert Dense Model จะให้ weight ทั้งหมดมีส่วนร่วมในการประมวลผลเสมอ ไม่ว่า input จะเป็นอะไรก็ตาม
ทำไมถึงเรียกว่า "Dense"
ในโลกของ Neural Network นั้น มีธรรมเนียมปฏิบัติที่เรียก Fully Connected Layer ว่า Dense Layer อยู่แล้ว คำเรียก Dense Model จึงสื่อถึงลักษณะเชิงโครงสร้างที่ว่า โมเดลทั้งหมดประกอบขึ้นจาก "การเชื่อมต่อที่ไม่มีช่องว่าง" นั่นคือ Parameter ทั้งหมดจะทำงานทุกครั้งที่มีการ Inference
คำที่ถูกนำมาใช้เป็นคำตรงข้ามคือสถาปัตยกรรม MoE (Mixture of Experts) ใน MoE นั้น กลไก Routing จะคัดเลือก Expert เพียงจำนวนน้อยสำหรับแต่ละ Input Token และปล่อยให้ Expert ที่เหลืออยู่ในสถานะพักงาน ผลลัพธ์คือ แม้จำนวน Parameter รวมจะเท่ากัน แต่ปริมาณการคำนวณ (FLOPs) ในขณะ Inference จะลดลงอย่างมาก ที่ Mixtral 8x7B ถูกอธิบายว่า "มี Parameter 46.7B แต่ Active Parameter เพียง 12.9B" ก็เป็นเพราะกลไกนี้
จุดแข็งและข้อจำกัดของ Dense Model
ข้อดีที่ยิ่งใหญ่ที่สุดของ Dense Model คือความเรียบง่ายในการออกแบบ ไม่จำเป็นต้องกังวลเรื่องความไม่สมดุลของ Routing หรือการกระจายภาระงานระหว่าง Expert (Load Balancing) ทำให้การ Training มีเสถียรภาพสูง ที่โมเดลหลักอย่าง Llama 3 Series และ Claude ยังคงใช้สถาปัตยกรรม Dense อย่างต่อเนื่อง ก็เพราะเสถียรภาพนี้มีความสำคัญอย่างยิ่งในการ Training ขนาดใหญ่
ในทางกลับกัน สิ่งที่หลีกเลี่ยงไม่ได้คือจำนวน Parameter ส่งผลโดยตรงต่อต้นทุนการ Inference Dense Model ขนาด 70B Parameter จะต้องอ่านและคำนวณน้ำหนักทั้ง 70B ทุกครั้งที่ Inference หากสามารถบรรลุคุณภาพที่เทียบเท่าได้ด้วย MoE ต้นทุนการ Inference อาจลดลงเหลือเพียงเศษเสี้ยวหนึ่ง
เกณฑ์การตัดสินใจในทางปฏิบัติ
ในการคัดเลือกโมเดล การตัดสินใจโดยพิจารณาความเหมาะสมกับ Workload จะมีประโยชน์ในทางปฏิบัติมากกว่าการมองว่าต้องเลือกระหว่าง Dense หรือ MoE เพียงอย่างใดอย่างหนึ่ง
สำหรับการสนทนาแบบ Real-time ที่มีข้อกำหนด Latency เข้มงวด หรืองานที่มีรูปแบบ Input/Output หลากหลายจนคาดเดาการกระจุกตัวของ Expert ไม่ได้ ต้นทุนการคำนวณที่คาดการณ์ได้ของ Dense Model จะง่ายต่อการดูแลระบบมากกว่า ในทางตรงกันข้าม สำหรับการประมวลผลข้อความจำนวนมากด้วย Batch Inference หรือ Scenario ที่เน้น Throughput ประสิทธิภาพการคำนวณของ MoE จะแสดงศักยภาพได้อย่างเต็มที่
จากประสบการณ์ของผู้เขียน สิ่งที่ส่งผลกระทบมากที่สุดเมื่อต้องเปลี่ยนโมเดลในสภาพแวดล้อม Production ไม่ใช่ "จำนวน Parameter" แต่คือ "วิธีที่โมเดลโหลดลง GPU Memory" Dense 70B นั้นพอดีแบบหวุดหวิดบน A100 80GB จำนวน 2 ใบ ในขณะที่ MoE ที่มี Active Parameter 13B สามารถรันได้บนการ์ดเพียงใบเดียว ความแตกต่างนี้คือสิ่งที่กำหนดต้นทุนด้านโครงสร้างพื้นฐาน
บทความที่กล่าวถึงคำศัพท์นี้
- การออกแบบงบประมาณความหน่วงสำหรับ AI Agent — วิธีควบคุมการแลกเปลี่ยนระหว่างเวลาคิดและเวลาตอบสนองอธิบายปัญหา "เวลาคิด" ใน Multi-step reasoning agent ที่ทำให้เกิดความล่าช้า พร้อมเปรียบเทียบการจัดสรร Latency budget และรูปแบบการใช้งานตามความซับซ้อนของงาน
- คู่มือเริ่มต้นการทำ Fine-tuning: พื้นฐานและเกณฑ์การตัดสินใจสำหรับองค์กร B2B ก่อนสร้าง LLM ของตนเองอธิบายกลไก Fine-tuning ตั้งแต่พื้นฐาน ความสัมพันธ์กับ PEFT/LoRA การเลือกใช้ร่วมกับ RAG การคำนวณต้นทุน และเช็คลิสต์สำหรับธุรกิจ B2B ในการพัฒนาโมเดลเอง
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน
- GLM-5.3 คืออะไร? การป้องกันองค์กรในยุคที่ AI เข้าถึงได้ง่ายช่วยให้การโจมตีเป็นเรื่องอัตโนมัติGLM-5.3 คือ AI ที่ NIST ยกย่องว่ามีขีดความสามารถด้านไซเบอร์สูงสุดในกลุ่ม Open-weight เจาะลึกการเปลี่ยนแปลงและแนวทางป้องกันที่องค์กรต้องเร่งปรับปรุง


คำศัพท์ที่เกี่ยวข้อง
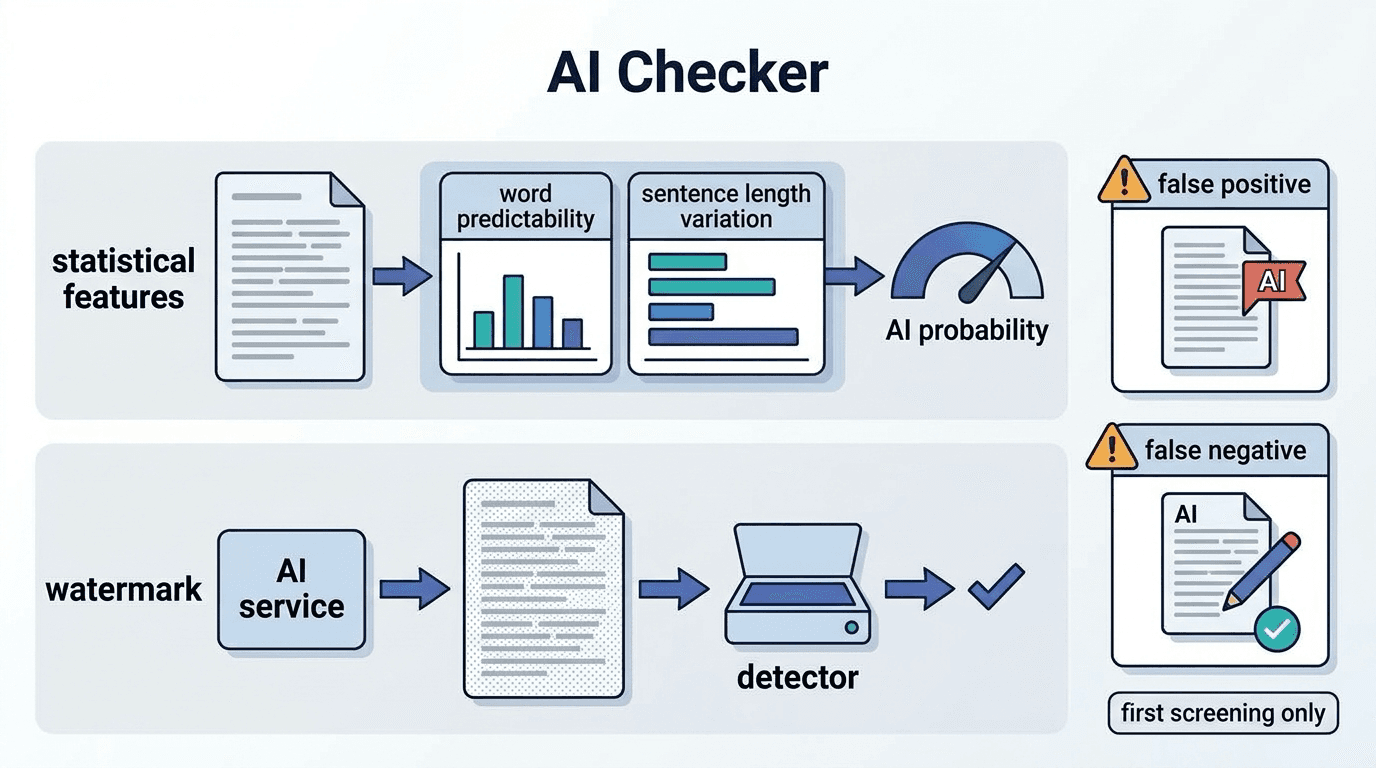
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
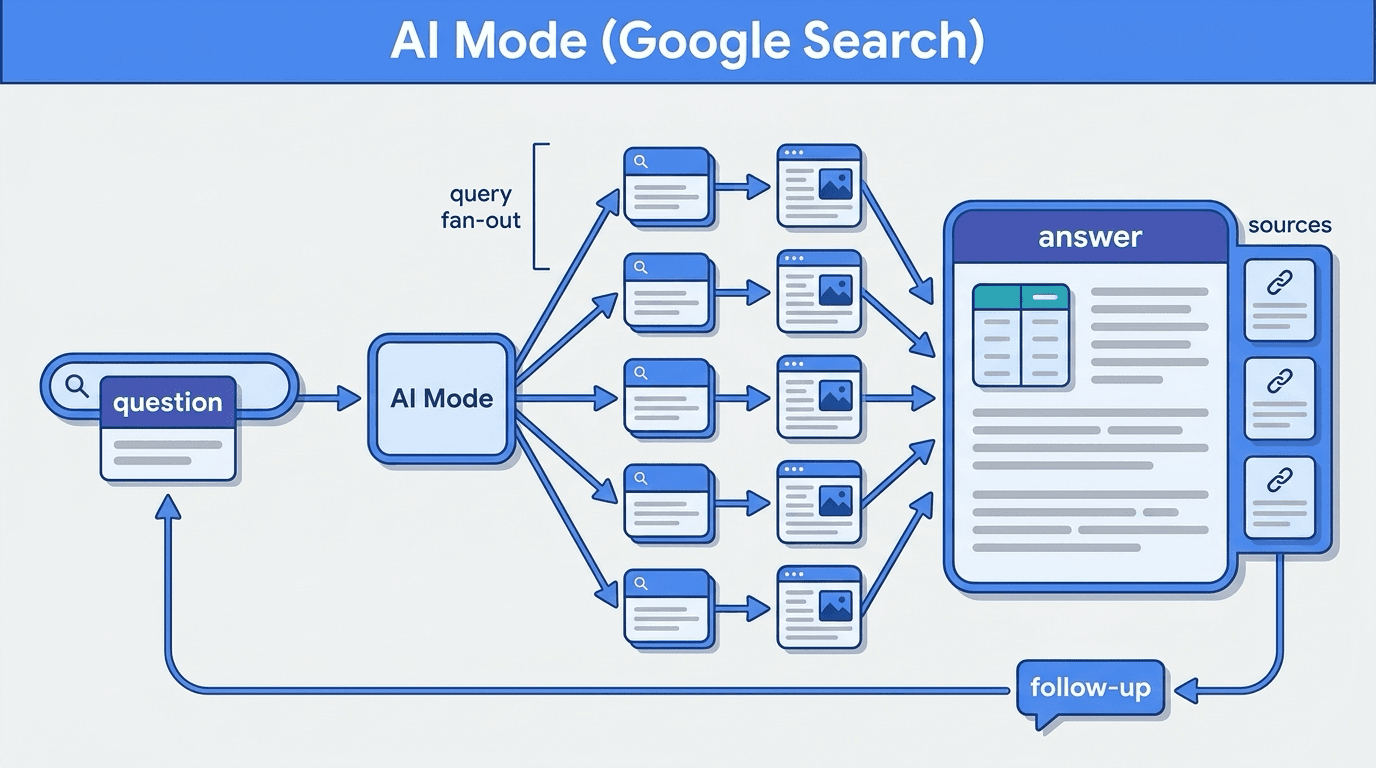
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
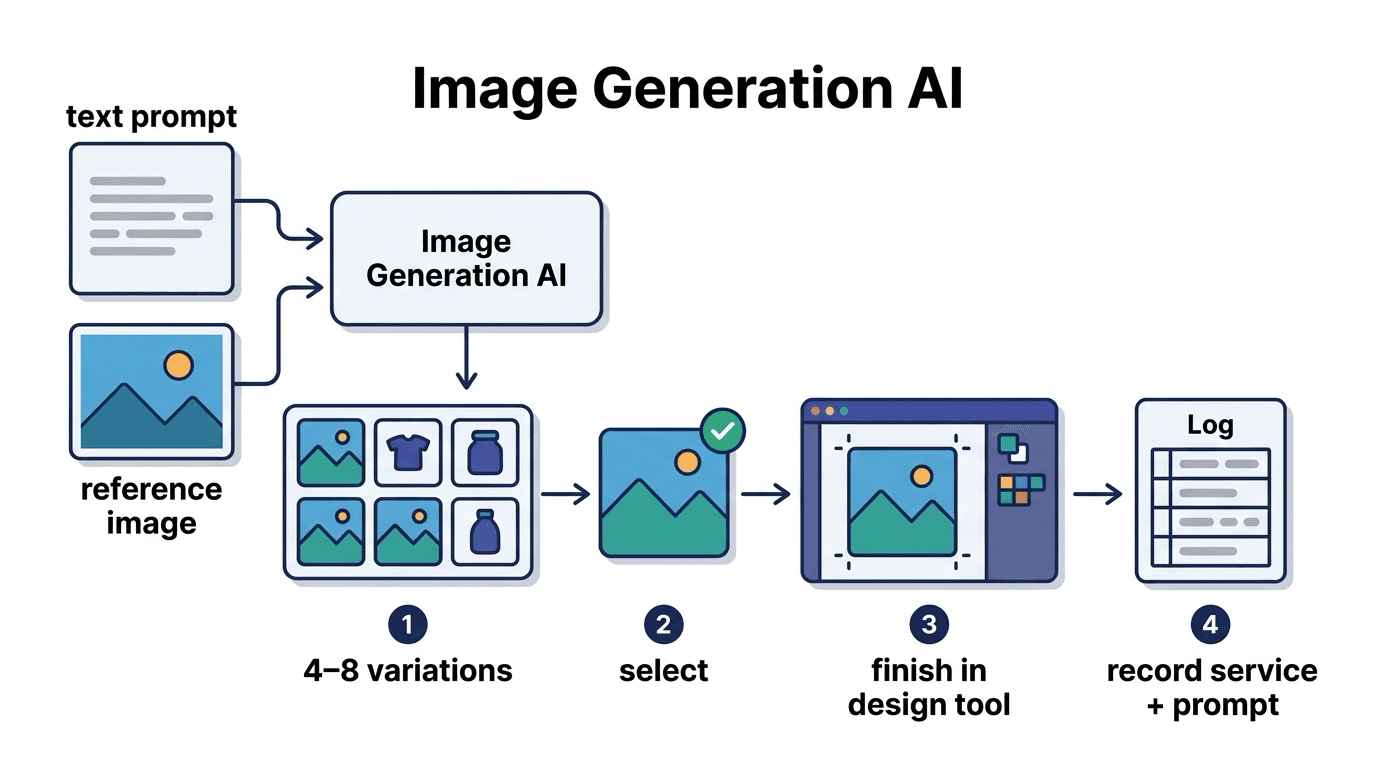
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
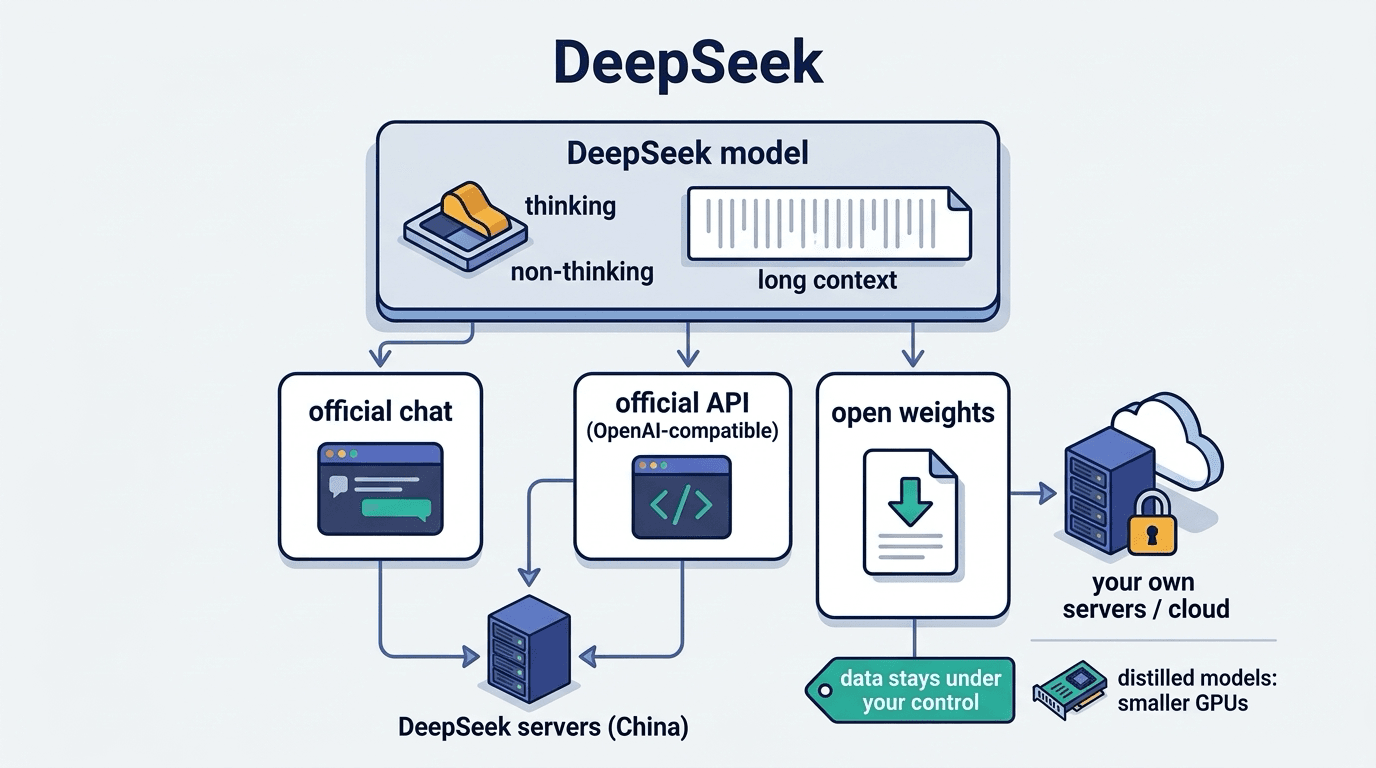
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ