RLHF
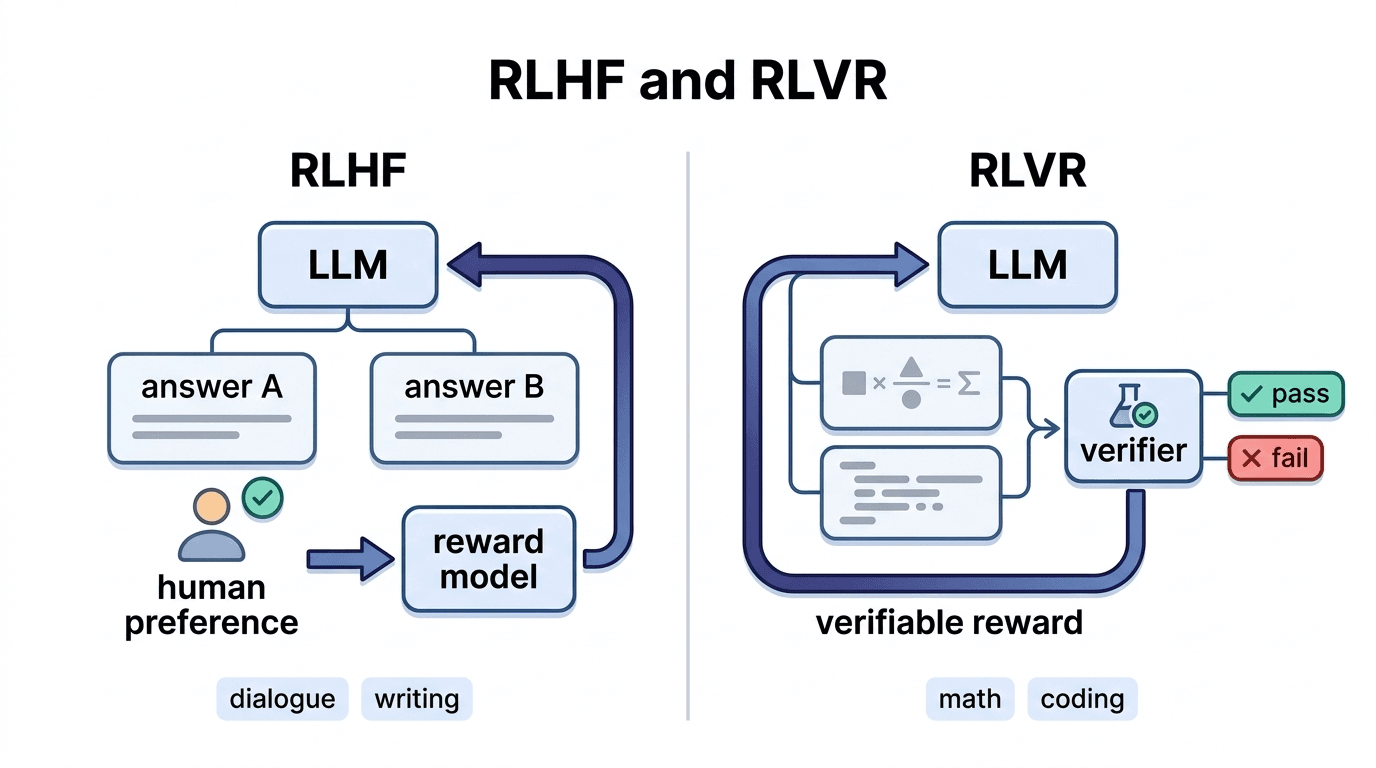
RLHF คือวิธีการเรียนรู้เสริมแรง (Reinforcement Learning) ที่ใช้ข้อเสนอแนะจากมนุษย์เป็นรางวัล ส่วน RLVR คือวิธีการเรียนรู้เสริมแรงที่ใช้คำตอบที่ตรวจสอบได้เป็นรางวัล โดยทั้งสองวิธีถูกนำมาใช้เพื่อปรับผลลัพธ์ของ LLM ให้สอดคล้องกับความคาดหวังของมนุษย์
เทคโนโลยีที่เปลี่ยน LLM จาก "ฉลาด" ให้ "ใช้งานได้จริง"
LLM ที่ผ่านการ pre-training มาแล้วนั้นมีความรู้มหาศาล แต่ในสภาพดิบยังใช้งานได้ยาก เช่น แทนที่จะตอบคำถาม กลับสร้างข้อความต่อเนื่องออกมา หรืออาจสร้างเนื้อหาที่เป็นอันตราย กระบวนการที่เปลี่ยนสภาวะ "ฉลาดแต่จัดการยาก" ให้กลายเป็น "ฉลาดและใช้งานง่าย" เรียกว่า alignment (การปรับความสอดคล้อง) และเทคโนโลยีหลักของกระบวนการนี้คือ RLHF
RLHF: ให้มนุษย์เป็นผู้ตัดสิน
ใน RLHF (Reinforcement Learning from Human Feedback) annotator ที่เป็นมนุษย์จะเปรียบเทียบ output หลายรายการของโมเดลและประเมินว่า "อันนี้ดีกว่า" จากนั้นนำข้อมูลการประเมินดังกล่าวไปเทรน reward model แล้วปรับ LLM ด้วย reinforcement learning ให้มุ่งสู่การได้รับ reward ที่สูงขึ้น การที่ ChatGPT และ Claude สามารถตอบสนองได้ "เหมือนการสนทนาจริง" นั้นเป็นผลลัพธ์ของ RLHF
อย่างไรก็ตาม ยังมีความท้าทายอยู่ การประเมินโดยมนุษย์มีต้นทุนสูง มีความแปรปรวนเชิงอัตวิสัย และ scale ได้ยาก นอกจากนี้ยังมีการชี้ให้เห็นปัญหาที่เรียกว่า reward hacking ซึ่งคำตอบที่ "ดูสมเหตุสมผลแต่ผิด" กลับได้รับการประเมินสูง
RLVR: จำกัดเฉพาะงานที่สามารถตรวจสอบคำตอบได้
RLVR (Reinforcement Learning with Verifiable Rewards) คือวิธีการที่ได้รับความสนใจในปี 2025 จาก DeepSeek-R1 โดยจำกัดเฉพาะงานที่สามารถตรวจสอบความถูกต้องได้ด้วยเครื่องจักร เช่น การพิสูจน์ทางคณิตศาสตร์หรือผลลัพธ์จากการรันโค้ด และให้ reward โดยไม่ต้องผ่านการประเมินของมนุษย์
เนื่องจากไม่มีความเป็นอัตวิสัยของมนุษย์เข้ามาเกี่ยวข้อง noise ของ reward จึงน้อยลง และสามารถสร้าง feedback จำนวนมากได้ด้วยต้นทุนต่ำ ใน benchmark ด้านคณิตศาสตร์ การเขียนโค้ด และ formal logic มีรายงานว่าการปรับปรุงความแม่นยำของ RLVR นั้นเหนือกว่า RLHF อัลกอริทึมที่เป็นรูปธรรม เช่น GRPO และ DPO ต่างก็อยู่ในกระแสนี้
ควรใช้วิธีไหน
ทั้งสองวิธีไม่ได้ขัดแย้งกัน สำหรับงานที่ตรวจสอบได้ (การสร้างโค้ด คณิตศาสตร์ การตรวจสอบข้อเท็จจริง) RLVR มีประสิทธิภาพมากกว่า ในขณะที่งานซึ่ง "ไม่มีคำตอบที่ถูกต้องเพียงหนึ่งเดียว" เช่น การเขียนเชิงสร้างสรรค์หรือคุณภาพของการสนทนา ยังคงต้องพึ่ง RLHF อยู่ ในทางปฏิบัติ แนวทาง hybrid ที่ผสมผสานทั้งสองวิธีเข้าด้วยกันกำลังเพิ่มมากขึ้น
บทความที่กล่าวถึงคำศัพท์นี้
- คู่มือเริ่มต้นการทำ Fine-tuning: พื้นฐานและเกณฑ์การตัดสินใจสำหรับองค์กร B2B ก่อนสร้าง LLM ของตนเองอธิบายกลไก Fine-tuning ตั้งแต่พื้นฐาน ความสัมพันธ์กับ PEFT/LoRA การเลือกใช้ร่วมกับ RAG การคำนวณต้นทุน และเช็คลิสต์สำหรับธุรกิจ B2B ในการพัฒนาโมเดลเอง
- LLM-as-a-Judge คืออะไร? วิธีประเมินผลลัพธ์ AI ด้วย AI และการตรวจจับ HallucinationLLM-as-a-Judge คือวิธีประเมินผลลัพธ์ LLM ด้วย LLM เอง ครอบคลุมการเปรียบเทียบวิธีต่างๆ การแก้ Bias, 4 ขั้นตอนการใช้งาน และการผสานกับ Observability และ Guardrails
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน
- คู่มือการออกแบบการประเมิน AI Agent — การเรียกใช้เครื่องมือ, รอยทางการทำงาน และการตรวจจับการถดถอยสำหรับ AI Agent นั้น สิ่งที่ขาดไม่ได้ไม่ใช่เพียงแค่ผลลัพธ์สุดท้าย แต่รวมถึงการตรวจสอบการเรียกใช้เครื่องมือ (Tool calling) และเส้นทางการทำงาน (Execution trajectory) อีกด้วย เราจะอธิบายขั้นตอนตั้งแต่การออกแบบ Golden Set, การให้คะแนนเส้นทางการทำงาน, ไปจนถึงการตรวจจับการถดถอย (Regression) ภายใต้สภาวะที่ไม่แน่นอน (Non-determinism) และการเชื่อมต่อกับ CI


คำศัพท์ที่เกี่ยวข้อง
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
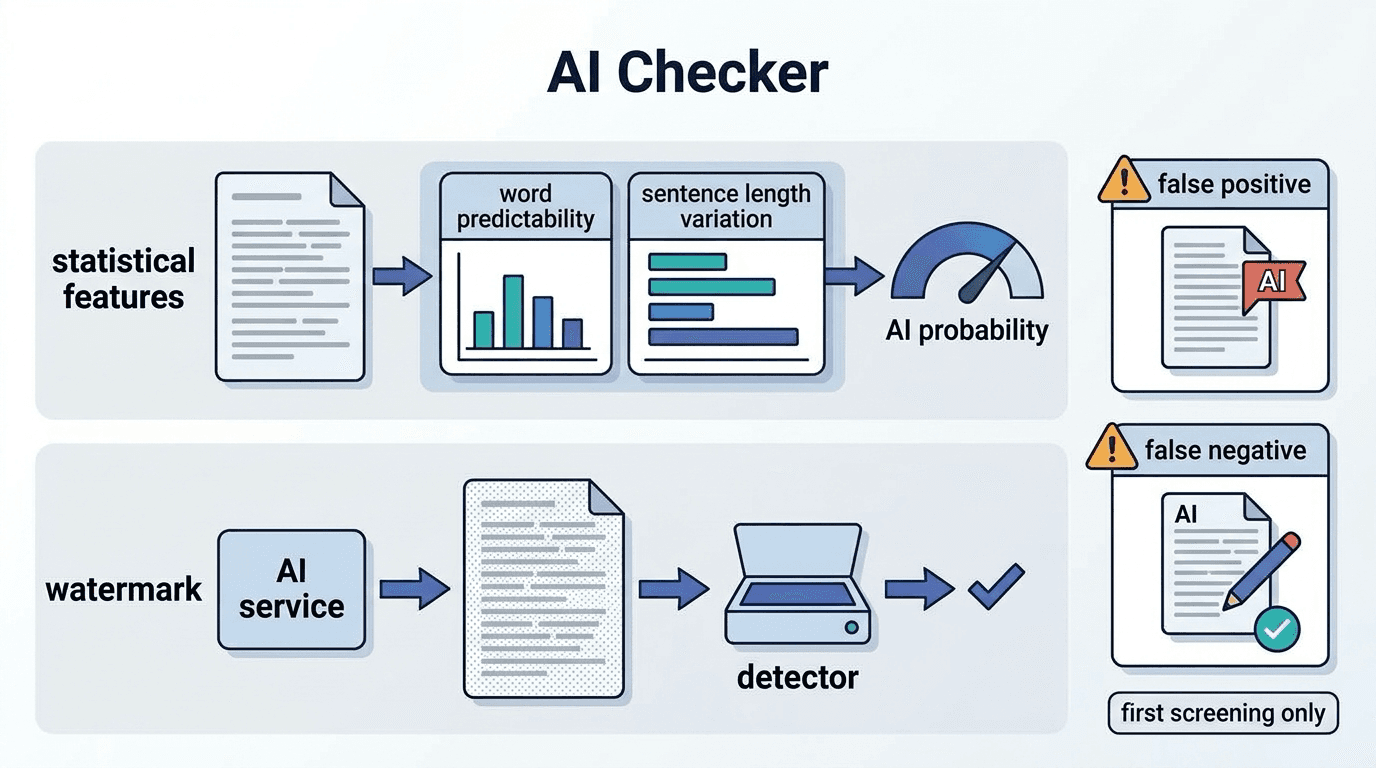
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
AI Mode (โหมด AI ของ Google)
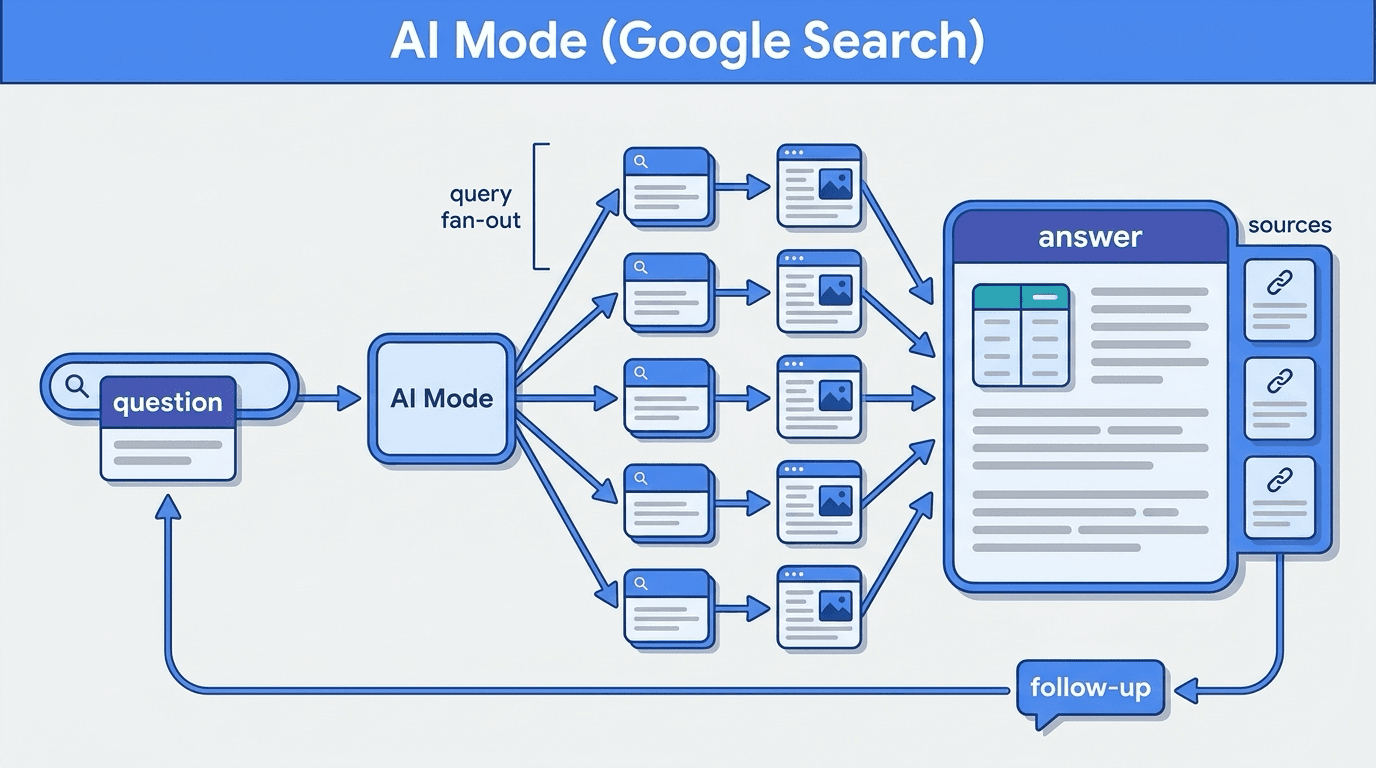
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
AI สร้างภาพ (Image Generation AI)
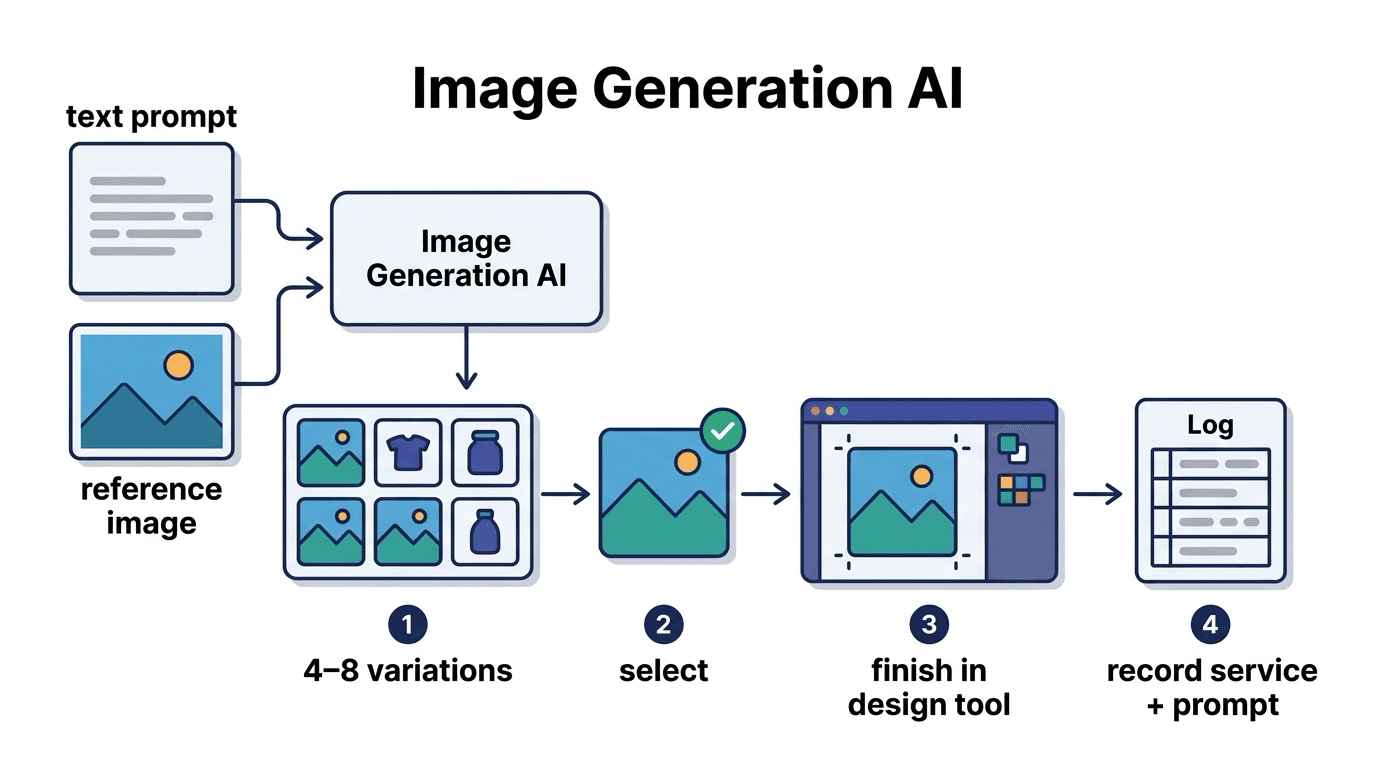
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
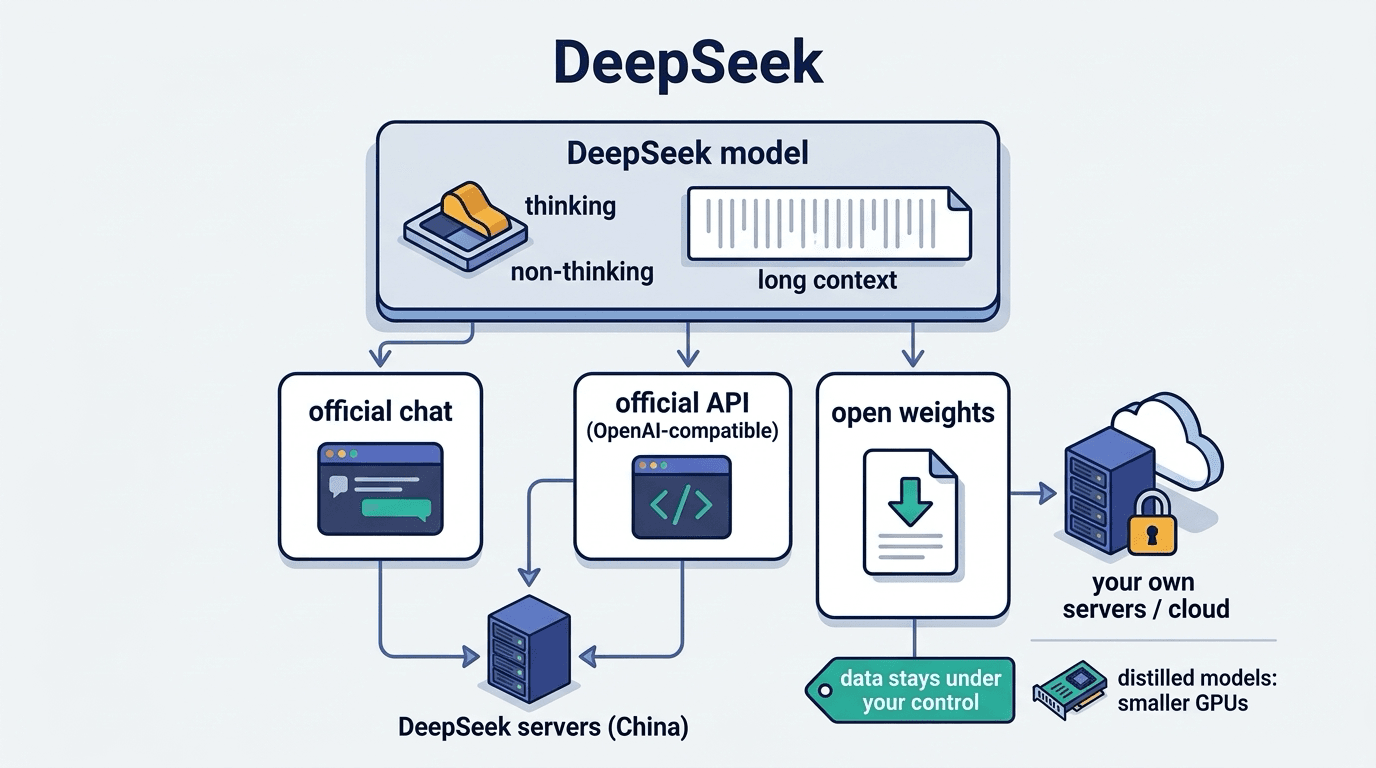
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ