LLM (โมเดลภาษาขนาดใหญ่)
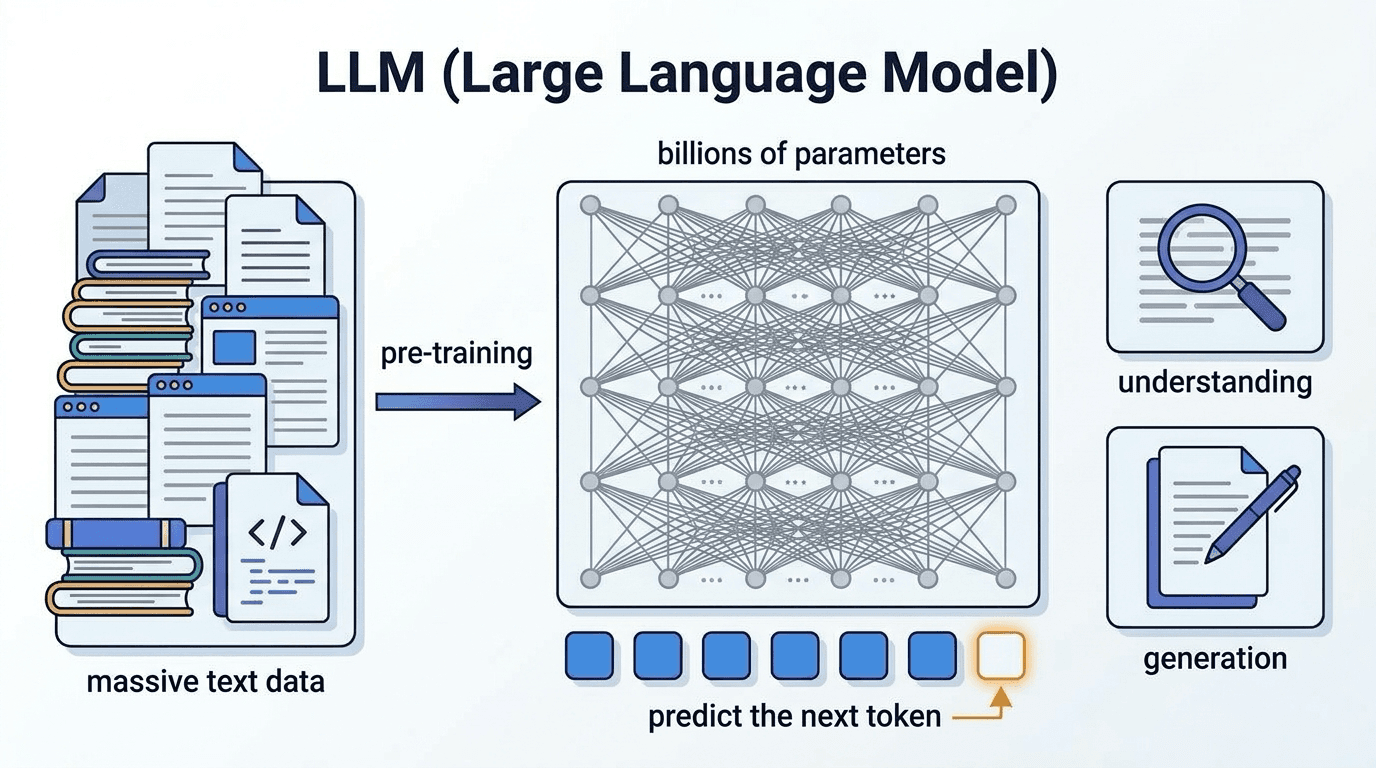
LLM (Large Language Model) คือชื่อเรียกรวมของโมเดลเครือข่ายประสาทเทียมที่มีพารามิเตอร์ตั้งแต่หลายพันล้านถึงหลายล้านล้านตัว ซึ่งผ่านการเรียนรู้ล่วงหน้าด้วยข้อมูลข้อความจำนวนมหาศาล และสามารถทำความเข้าใจและสร้างภาษาธรรมชาติได้อย่างแม่นยำสูง
นับตั้งแต่การเปิดตัว ChatGPT ในเดือนพฤศจิกายน ปี 2022 คำว่า LLM ได้แพร่หลายออกไปไม่เพียงแค่ในหมู่นักเทคโนโลยี แต่ยังเป็นที่รู้จักในวงกว้างทั่วไปอีกด้วย อย่างไรก็ตาม สาระสำคัญที่ซ่อนอยู่ในชื่อ "Large Language Model" นั้นเรียบง่ายมาก นั่นคือ "โมเดลที่ถูกฝึกให้อ่านข้อความจำนวนมหาศาล และทำซ้ำการฝึกเพื่อทำนายคำถัดไป" เพียงเท่านั้น ความน่าสนใจของ LLM อยู่ที่ความสามารถที่หลากหลาย ไม่ว่าจะเป็นการแปลภาษา การสรุปความ การสร้างโค้ด และการอนุมาน ซึ่งล้วนเกิดขึ้นอย่าง emergent จากเป้าหมายการเรียนรู้ที่เรียบง่ายนี้ และในขณะเดียวกัน นี่ก็เป็นส่วนที่ความเข้าใจในเชิงทฤษฎียังตามไม่ทัน
หากจะให้เห็นภาพของขนาดอย่างเป็นรูปธรรม GPT-3 มีพารามิเตอร์ 1.75 แสนล้านตัว (ปี 2020), Llama 3 มี 7 หมื่นล้านตัว (ปี 2024) และ GPT-4 แม้จะไม่มีการเปิดเผยตัวเลขอย่างเป็นทางการ แต่คาดการณ์ว่าเกิน 1 ล้านล้านตัว แม้จำนวนพารามิเตอร์ที่มากขึ้นจะมีแนวโน้มทำให้โมเดลฉลาดขึ้น แต่ข้อเท็จจริงที่ว่า Llama 3 70B สามารถเอาชนะ GPT-3 175B ในหลาย benchmark ก็แสดงให้เห็นว่าคุณภาพของข้อมูลฝึกและการปรับปรุง architecture นั้นมีความสำคัญไม่แพ้กัน หรืออาจมากกว่าด้วยซ้ำ
เส้นทางหลักในการนำ LLM ไปใช้งานจริงมีอยู่ 3 แนวทาง
แนวทางที่ 1 คือ ผ่าน API ซึ่งเป็นการเรียกใช้โมเดลของ OpenAI หรือ Anthropic โดยตรง วิธีนี้สะดวกที่สุด แต่มีข้อท้าทายในเรื่องการส่งข้อมูลออกไปภายนอก และการบริหารต้นทุนแบบ pay-per-use
แนวทางที่ 2 คือ การใช้ร่วมกับ RAG โดยการค้นหาเอกสารภายในองค์กรแล้วส่งต่อให้ LLM ซึ่งช่วยลด hallucination (การสร้างผลลัพธ์ที่ไม่ตรงกับความเป็นจริง) พร้อมกับนำความรู้ภายในองค์กรมาใช้ประโยชน์ได้ เนื่องจากไม่ต้องแก้ไขตัวโมเดล จึงมีอุปสรรคในการนำไปใช้ต่ำ
แนวทางที่ 3 คือ fine-tuning ซึ่งเป็นการปรับพฤติกรรมของโมเดลด้วยข้อมูลขององค์กรเอง มีประสิทธิภาพในกรณีที่ต้องการความสม่ำเสมอของโทนการตอบ หรือต้องการใช้คำศัพท์เฉพาะทางในอุตสาหกรรมอย่างถูกต้อง แต่ต้องใช้ทั้งการเตรียมข้อมูลฝึกและต้นทุนด้าน GPU
การเลือกแนวทางใดขึ้นอยู่กับ "ปัญหาที่ต้องการแก้ไข" เป็นหลัก และกรณีที่นำทั้ง 3 แนวทางมาผสมผสานกันก็มีให้เห็นมากขึ้นเรื่อยๆ
บทความที่กล่าวถึงคำศัพท์นี้
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน
- คู่มือการเพิ่มประสิทธิภาพต้นทุน LLM — การลดโทเค็น การเลือกโมเดล และการทำแคชคู่มือลดต้นทุนการใช้งาน LLM ในระดับโปรดักชัน ด้วย 4 กลยุทธ์: การปรับแต่ง Token, การเลือก Model, Prompt Cache และ RAG เพื่อลดค่าใช้จ่ายรายเดือนลงครึ่งหนึ่งโดยยังคงความแม่นยำไว้ได้
- LLM-as-a-Judge คืออะไร? วิธีประเมินผลลัพธ์ AI ด้วย AI และการตรวจจับ HallucinationLLM-as-a-Judge คือวิธีประเมินผลลัพธ์ LLM ด้วย LLM เอง ครอบคลุมการเปรียบเทียบวิธีต่างๆ การแก้ Bias, 4 ขั้นตอนการใช้งาน และการผสานกับ Observability และ Guardrails
- Edge AI คืออะไร? ทำความรู้จัก On-device LLM และวิธีเลือกใช้งานในธุรกิจเรียนรู้พื้นฐาน Edge AI และ On-device LLM พร้อมวิธีออกแบบระบบสำหรับงานที่ต้องการความหน่วงต่ำ ข้อมูลห้ามรั่วไหล และพื้นที่ที่สัญญาณไม่เสถียร


คำศัพท์ที่เกี่ยวข้อง
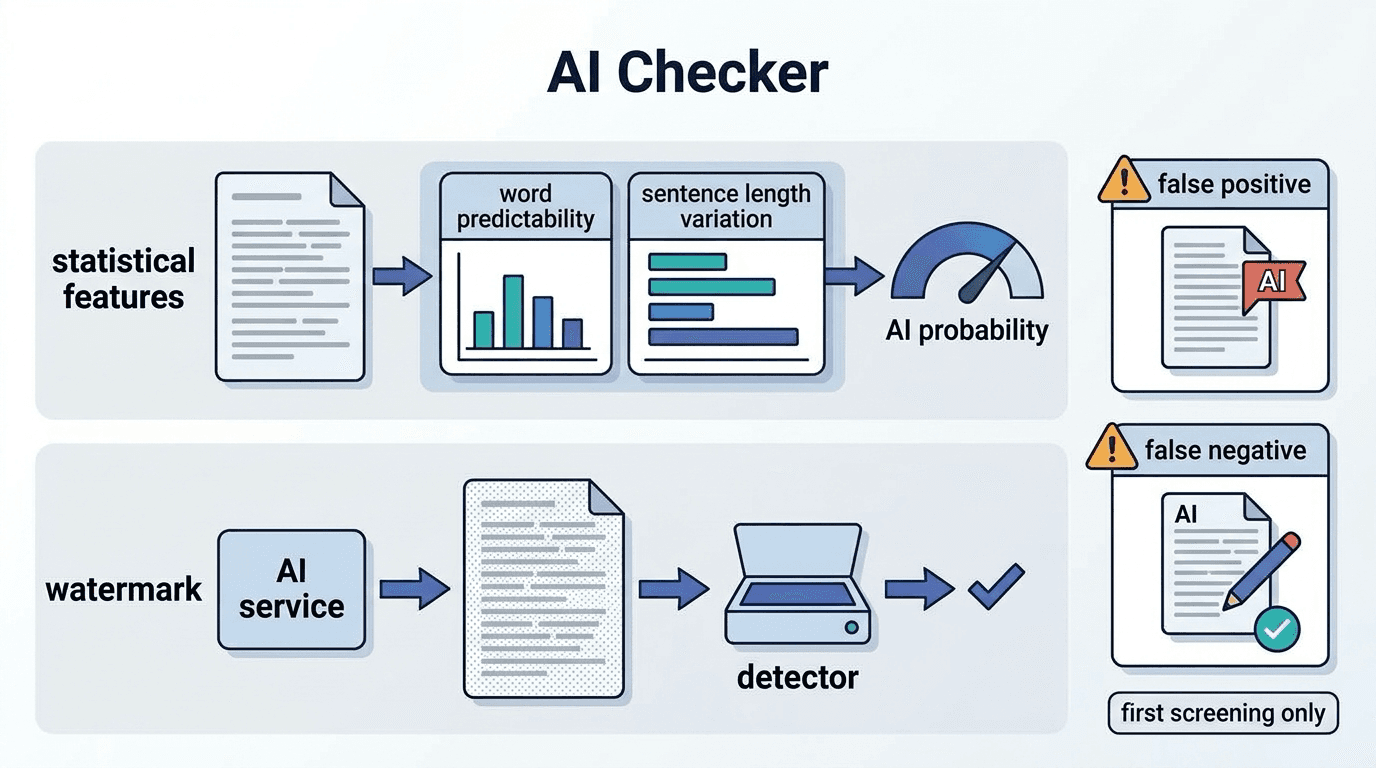
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
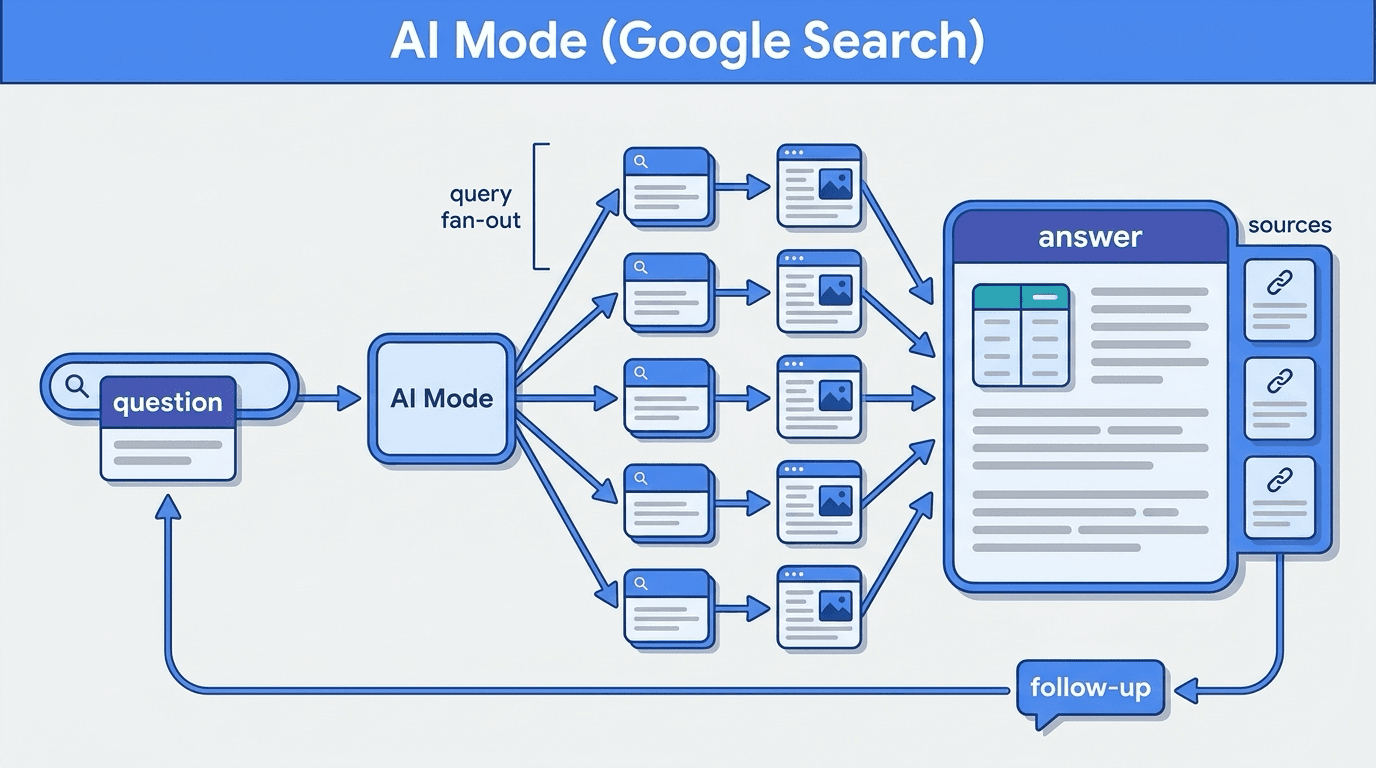
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
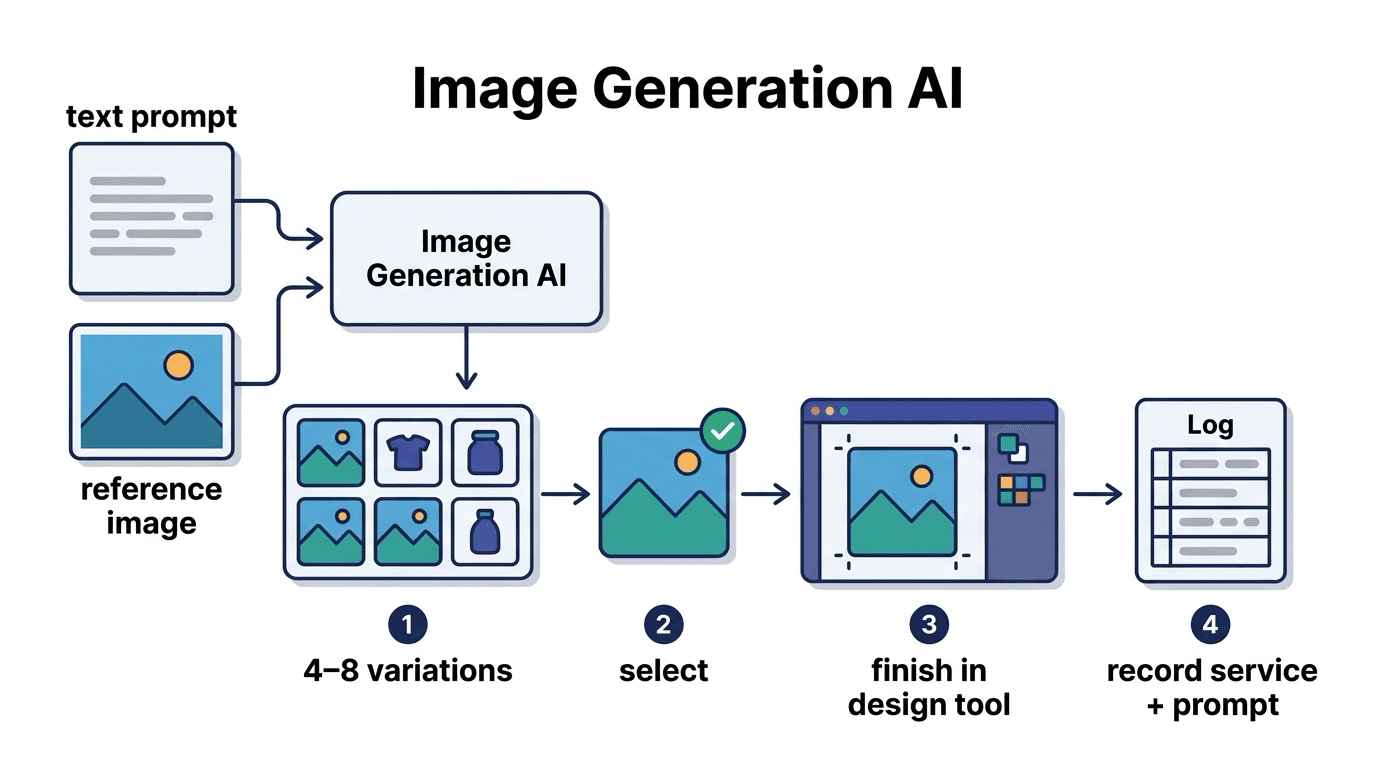
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
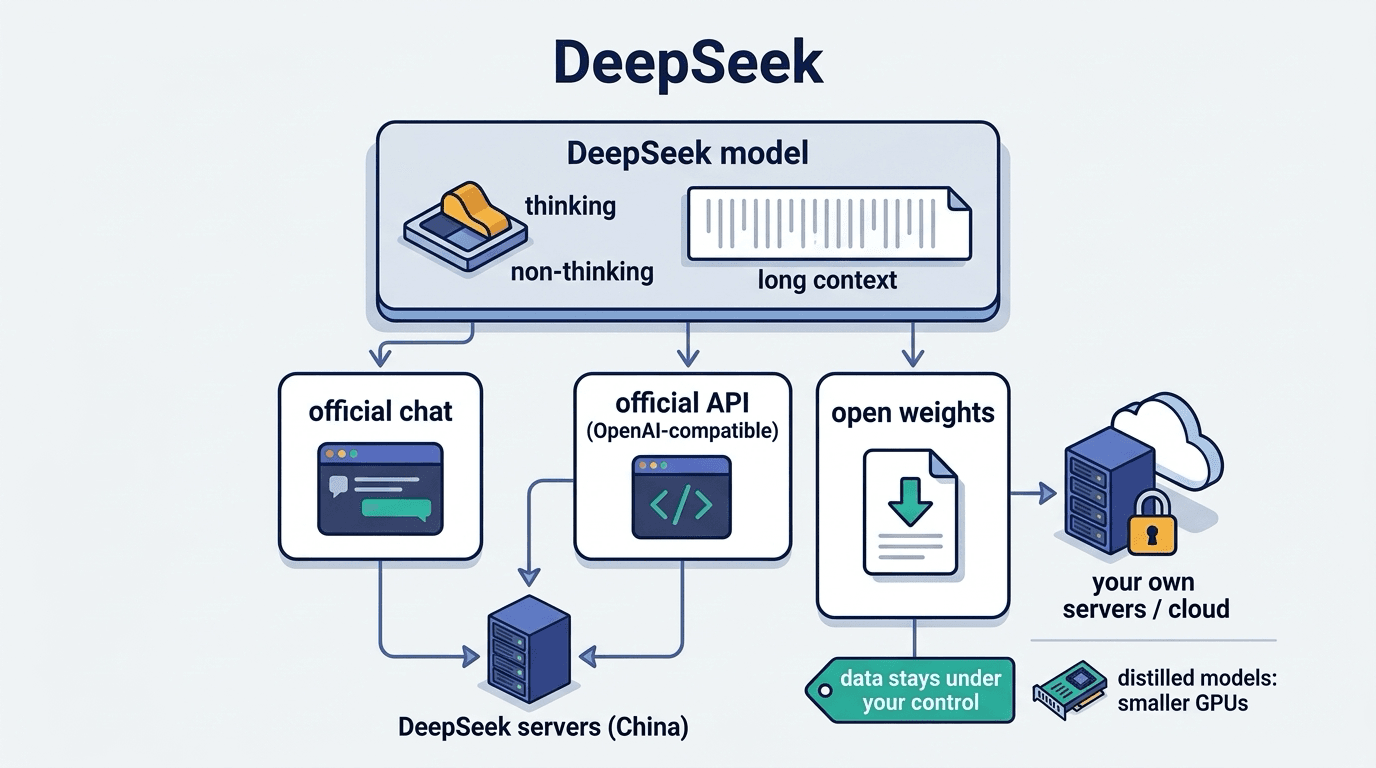
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ