เอไอแบบหลายรูปแบบ (Multimodal AI)
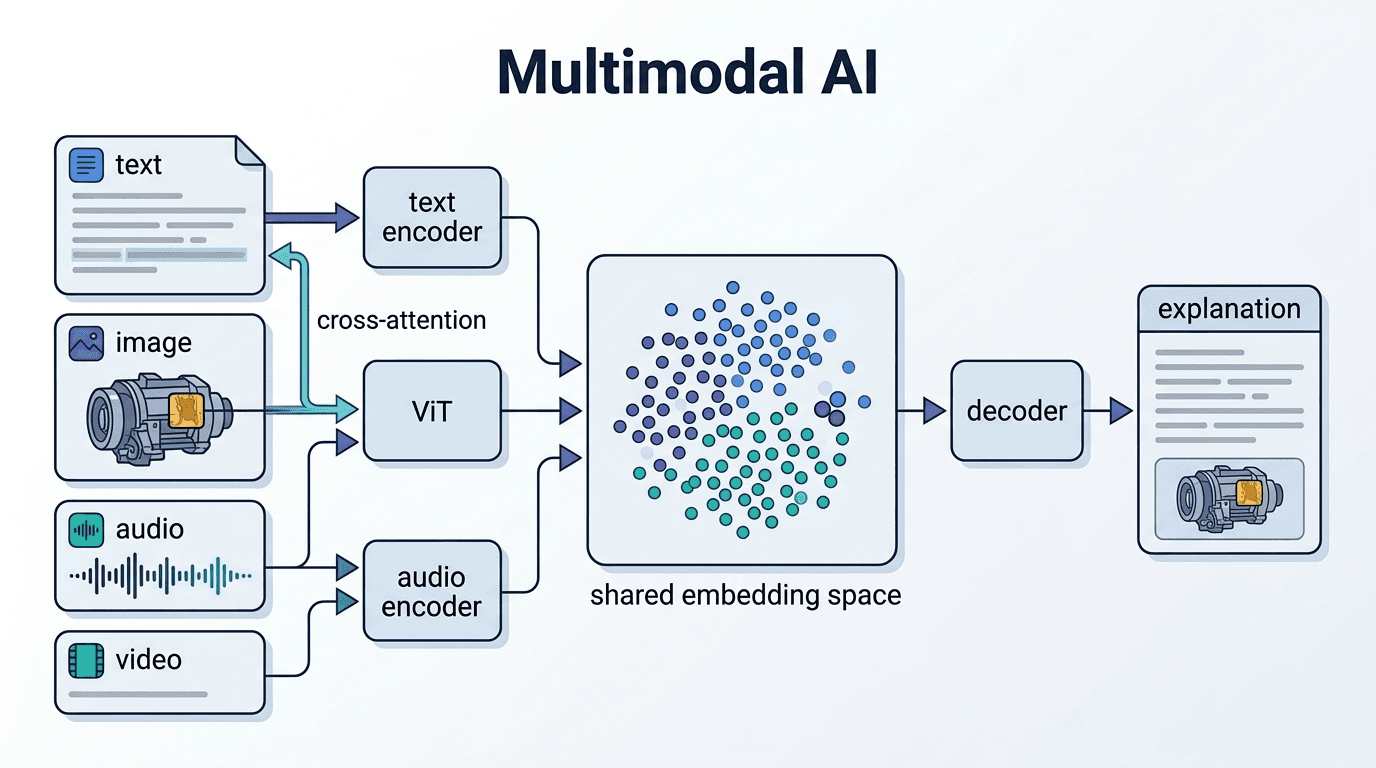
Multimodal AI คือระบบ AI ที่สามารถประมวลผล ทำความเข้าใจ และสร้างข้อมูลจากรูปแบบข้อมูลที่แตกต่างกันหลายประเภท เช่น ข้อความ รูปภาพ เสียง และวิดีโอ ได้อย่างบูรณาการ
Multimodal AI (AI หลายรูปแบบ) คือระบบ AI ที่ประมวลผล ทำความเข้าใจ และสร้างข้อมูลหลายรูปแบบ เช่น ข้อความ ภาพ เสียง และวิดีโอ ได้แบบบูรณาการ
ขณะที่ LLM (Large Language Model) แบบเดิมจัดการได้เฉพาะข้อความ Multimodal AI คือความพยายามจำลองกระบวนการรับรู้แบบผสมผสานที่มนุษย์ทำในชีวิตประจำวัน อย่าง "มอง ฟัง อ่าน และเข้าใจ" แนวทางนี้ได้รับความสนใจอย่างรวดเร็วในช่วงไม่กี่ปีมานี้ ในฐานะเทคโนโลยีพื้นฐานที่ทำให้ AI เข้าไปมีส่วนร่วมกับงานในโลกจริงได้ลึกขึ้น
ทำไมจึงต้องเป็น "Multimodal"
ข้อมูลในโลกจริงไม่ได้อยู่ในรูปแบบเดียว การวินิจฉัยทางการแพทย์มีทั้งภาพและข้อความผลการตรวจ หน้างานการผลิตมีทั้งภาพวิดีโอและข้อมูลเซนเซอร์ งานบริการลูกค้ามีทั้งเสียงและข้อความพร้อมกัน โมเดลที่ประมวลผลได้แค่ข้อความจึงมีข้อจำกัดโดยพื้นฐานในการจับบริบทที่ซับซ้อนเช่นนี้
โจทย์ที่ Multimodal AI พยายามแก้คือการรวมความหมายข้ามโมดาลิตี (รูปแบบของข้อมูล) เช่น คำขอ "ช่วยอธิบายความผิดปกติของชิ้นส่วนในภาพนี้" ต้องใช้ทั้งการเข้าใจภาพและการสร้างข้อความพร้อมกัน การประมวลผลแบบนี้เชื่อมโยงอย่างใกล้ชิดกับวิวัฒนาการของ Generative AI และมาถึงระดับที่ใช้งานได้จริงพร้อมกับการขยายขนาดของโมเดลพื้นฐาน (Foundation Model)
กลไกทางเทคนิค
หัวใจของ Multimodal AI คือกลไกที่แปลงข้อมูลต่างโมดาลิตีให้อยู่ในพื้นที่การแทนค่าร่วมกัน (พื้นที่ Embedding)
- การแยกและรวม Encoder: ใช้ Encoder ที่ปรับให้เหมาะกับแต่ละโมดาลิตี เช่น Vision Transformer (ViT) สำหรับภาพ และ Text Encoder แบบ Transformer สำหรับข้อความ (ในขั้นเตรียมข้อมูลใช้ BPE Tokenizer (Byte-Pair Encoding Tokenizer) เป็นต้น ในการแบ่งโทเค็น)
- กลไก Cross-Attention: อ้างอิง Feature ของโมดาลิตีต่าง ๆ ซึ่งกันและกัน เพื่อเรียนรู้ความสัมพันธ์ว่า "บริเวณนี้ของภาพตรงกับส่วนนี้ของข้อความ"
- Decoder แบบบูรณาการ: สร้างผลลัพธ์ เช่น ข้อความหรือภาพ จากการแทนค่าที่รวมกันแล้ว
แนวคิด Context Window ก็ขยายไปสู่ Multimodal ด้วย โมเดลรุ่นใหม่สามารถรับไฟล์ภาพ วิดีโอ และเสียงเป็นบริบทได้โดยตรง โมเดลหลักอย่าง Gemini, GPT และ Claude ต่างก็รองรับ Multimodal มากขึ้น และเมื่อใช้ร่วมกับการเรียกใช้เครื่องมือ (Function Calling) ก็ทำงานที่ซับซ้อนขึ้นได้
กรณีการใช้งานหลัก
Multimodal AI ถูกนำไปใช้อย่างกว้างขวางในหลายอุตสาหกรรม
- การแพทย์และสุขภาพ: วิเคราะห์ภาพเอกซเรย์และ MRI พร้อมสร้างข้อความช่วยวินิจฉัยโดยอัตโนมัติ
- การผลิตและการควบคุมคุณภาพ: ตรวจจับความผิดปกติจากภาพกล้อง และประยุกต์ใช้กับการบำรุงรักษาเชิงคาดการณ์ (Predictive Maintenance)
- ค้าปลีกและอีคอมเมิร์ซ: สร้างคำอธิบายสินค้าจากภาพสินค้าโดยอัตโนมัติ และการค้นหาด้วยภาพ (ค้นหาสินค้าจากรูปภาพ)
- การผลิตคอนเทนต์: สร้างข้อมูลสังเคราะห์ (Synthetic Data) ที่ผสมเสียง วิดีโอ และข้อความ
- โรงงานอัจฉริยะ (Smart Factory): วินิจฉัยความผิดปกติโดยรวมข้อมูลเซนเซอร์ ภาพวิดีโอ และบันทึกข้อความเข้าด้วยกัน
การใช้ร่วมกับ Edge AI ก็ก้าวหน้าขึ้น มีกรณีที่อนุมานแบบ Multimodal แบบเรียลไทม์บนอุปกรณ์ที่มีกล้องหรือไมโครโฟนเพิ่มมากขึ้น
ข้อควรระวังในการนำมาใช้และการดูแลระบบ
เมื่อนำ Multimodal AI มาใช้ในงานจริง ต้องตระหนักถึงความท้าทายหลายประการ ประการแรก คุณภาพและปริมาณข้อมูลสำหรับเทรนแตกต่างกันมากในแต่ละโมดาลิตี ข้อมูลข้อความมีอยู่มากมาย แต่ข้อมูลภาพและเสียงคุณภาพสูงที่ทำ Annotation แล้วมีต้นทุนการรวบรวมสูง
นอกจากนี้ ความเสี่ยงของ Hallucination ก็ยังมีอยู่ใน Multimodal มีรายงานกรณีที่โมเดลสร้างข้อความจากการตีความภาพผิด หรือรายงานว่า "เห็น" ลักษณะทางภาพที่ไม่มีอยู่จริง การใช้เทคนิค Grounding และการออกแบบกระบวนการตรวจสอบโดยมนุษย์ด้วย HITL (Human-in-the-Loop) คือกุญแจสำคัญในการสร้างความน่าเชื่อถือ
ยิ่งไปกว่านั้น ความเสี่ยงจากการนำไปใช้ในทางที่ผิด เช่น Deepfake ก็มองข้ามไม่ได้ ยิ่งความสามารถในการสร้างแบบ Multimodal สูงขึ้น การสร้างข้อมูลเท็จก็ยิ่งง่ายขึ้น จึงต้องมีมาตรการจากมุมมองของ AI Governance
Multimodal AI เป็นเทคโนโลยีที่มีบทบาทสำคัญในการพัฒนา AI จาก "เครื่องมือประมวลผลข้อความ" ไปสู่ "ระบบที่เข้าใจโลกจริง" และเมื่อผสานกับ Agentic AI และ AI Agent ความเป็นไปได้ก็จะยิ่งขยายกว้างขึ้น
บทความที่กล่าวถึงคำศัพท์นี้
- วิธีที่ธุรกิจร้านอาหารในไทยจะเริ่มใช้ AI เพื่อพยากรณ์ความต้องการ จัดตารางงาน และลดขยะอาหารเรียนรู้วิธีที่ร้านอาหารในไทยใช้ AI พยากรณ์ยอดขาย จัดตารางพนักงาน ลดขยะอาหาร และจัดการออเดอร์/เดลิเวอรี่ พร้อมขั้นตอนการใช้งานและกรณีศึกษาจริงที่นำไปใช้ได้ทันที
- AI Native UI คืออะไร? แนวคิดการออกแบบที่ให้ Generative AI สร้างหน้าจอแบบไดนามิกอธิบายแนวคิด AI-native UI ที่ตัดฟอร์มและเมนูออก โดย AI จะสร้างอินเทอร์เฟซแบบไดนามิกตามงานที่ทำ พร้อมตัวอย่างการออกแบบและกรณีศึกษาการใช้งานจริง
- Edge AI คืออะไร? ทำความรู้จัก On-device LLM และวิธีเลือกใช้งานในธุรกิจเรียนรู้พื้นฐาน Edge AI และ On-device LLM พร้อมวิธีออกแบบระบบสำหรับงานที่ต้องการความหน่วงต่ำ ข้อมูลห้ามรั่วไหล และพื้นที่ที่สัญญาณไม่เสถียร
- ตัวชี้วัดและวิธีการประเมินคุณภาพผลลัพธ์ของ Generative AI แบบอัตโนมัติเจาะลึกการวัดคุณภาพ Generative AI หลังใช้งานจริงด้วยตัวชี้วัดอัตโนมัติอย่าง BLEU, ROUGE, BERTScore พร้อมวิธีติดตั้งระบบตรวจสอบและตรวจจับคุณภาพที่ลดลง


คำศัพท์ที่เกี่ยวข้อง
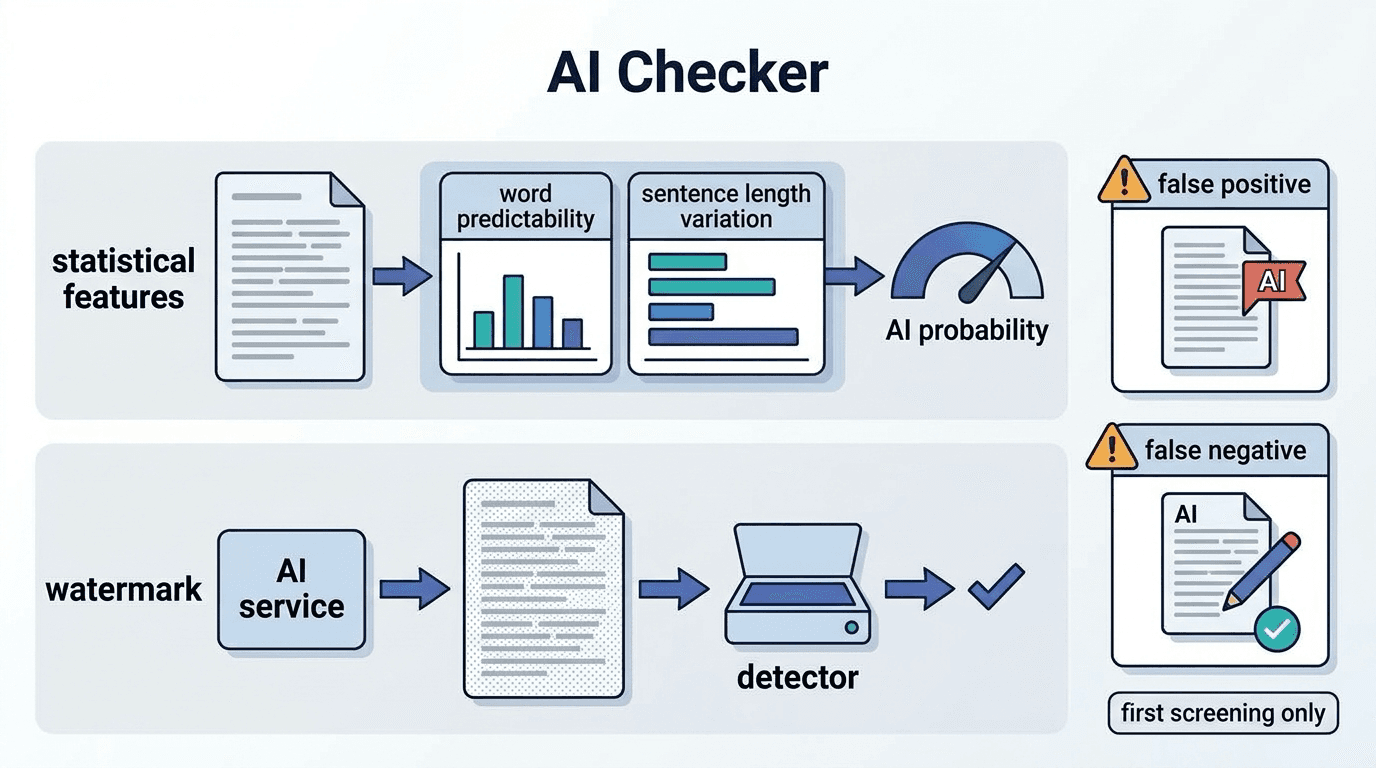
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
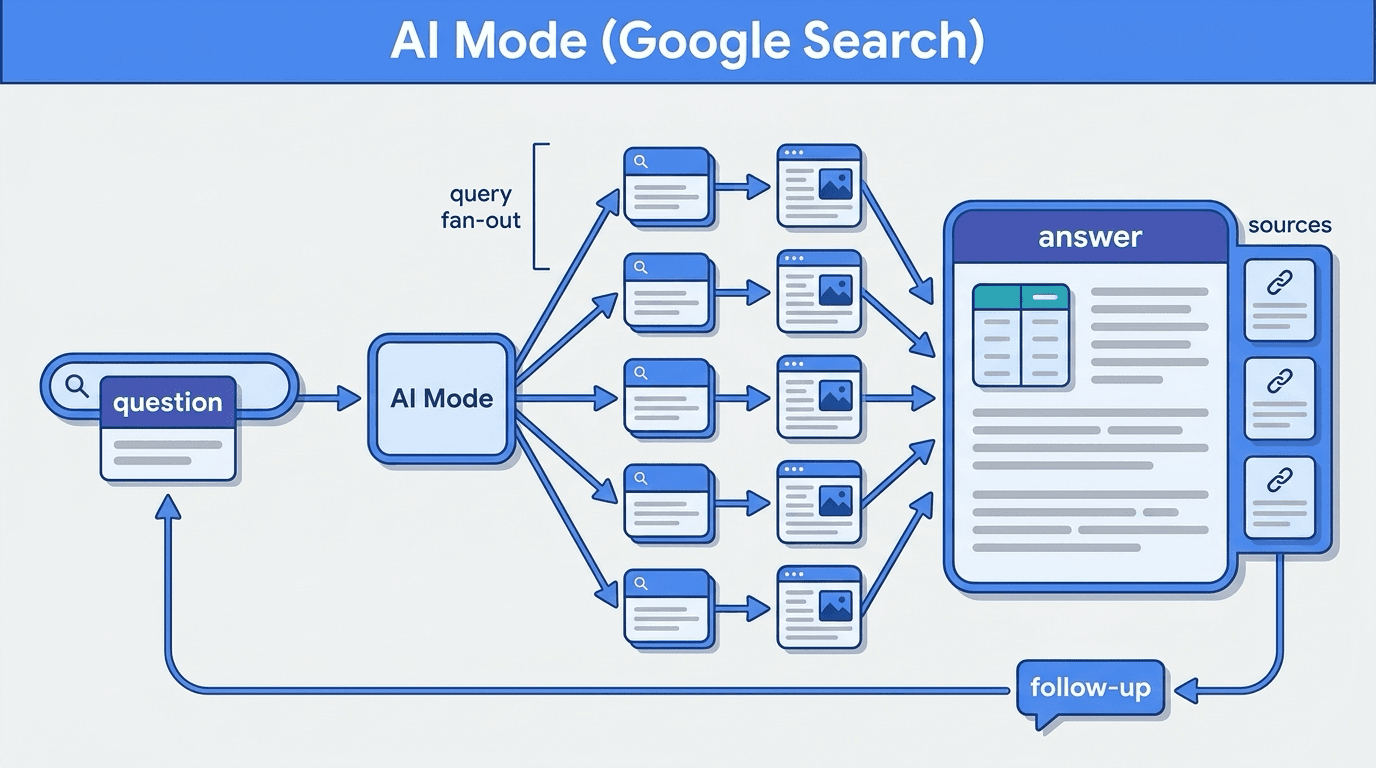
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
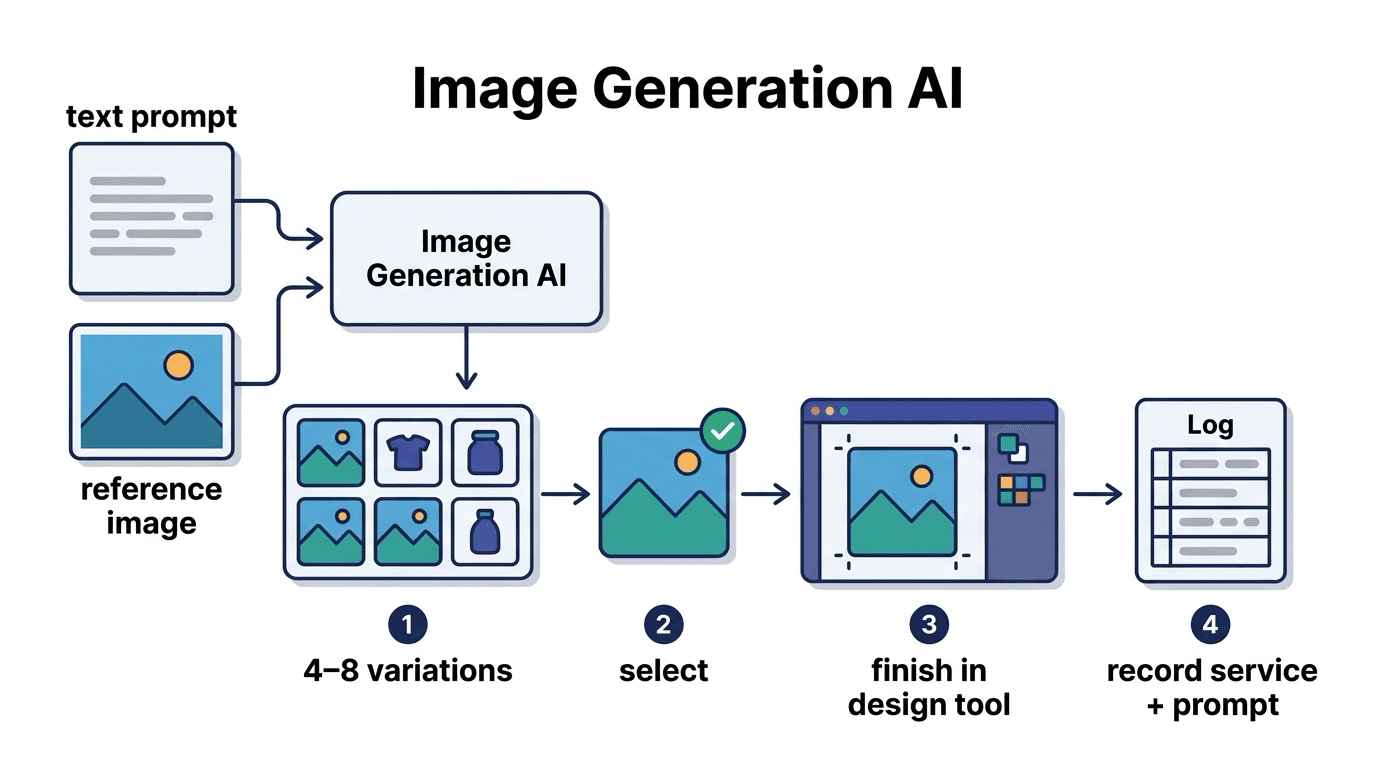
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
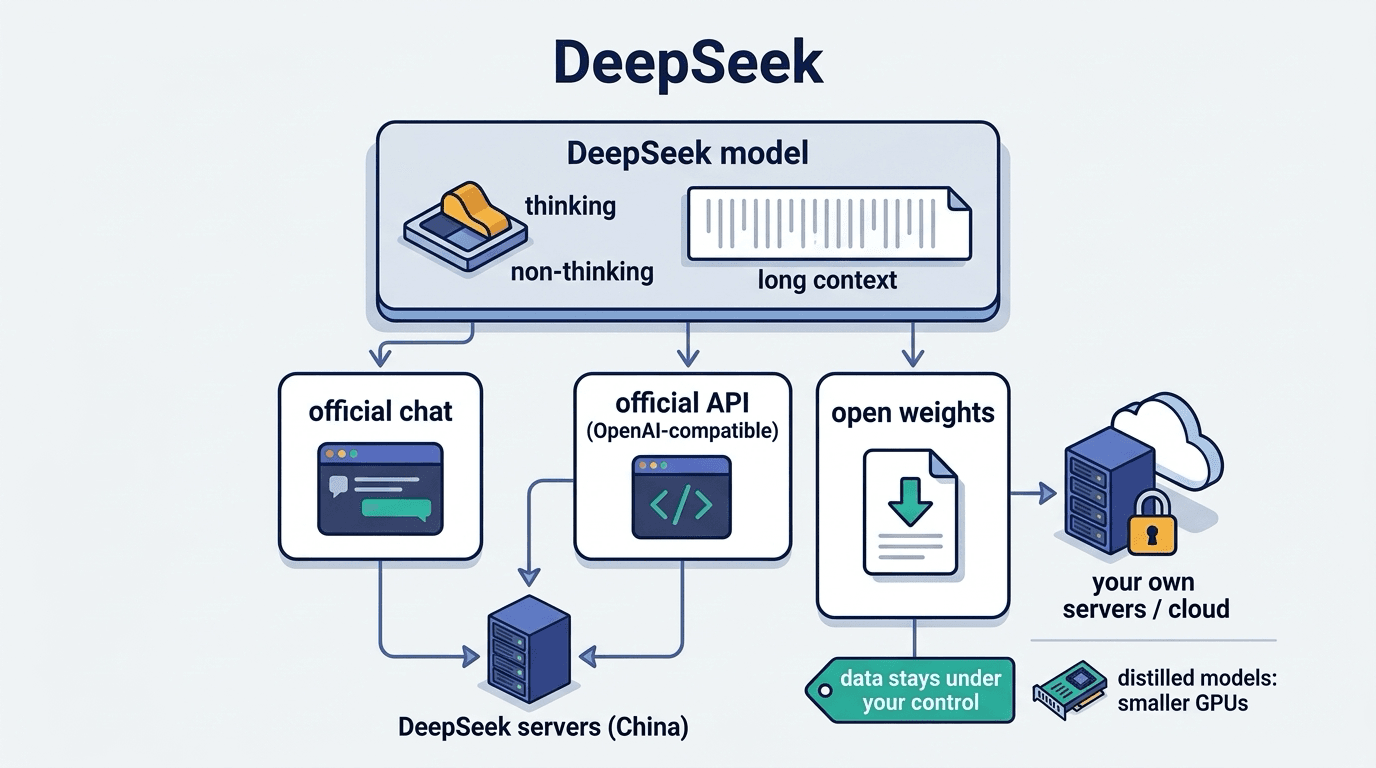
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ