หน้าต่างบริบท (Context Window)

Context Window คือขีดจำกัดจำนวนโทเค็นสูงสุดที่ LLM สามารถประมวลผลได้ในคราวเดียว โดยครอบคลุมทั้งความยาวของ Prompt ที่ป้อนเข้าและผลลัพธ์ที่ได้ ซึ่งส่งผลโดยตรงต่อคุณภาพในการประมวลผลเอกสารขนาดยาวและการสนทนาแบบหลายรอบ (Multi-turn conversation)
Context Window (หน้าต่างบริบท) คือขีดจำกัดจำนวนโทเค็นที่ LLM ประมวลผลได้ในการอนุมานหนึ่งครั้ง โดยนับรวมทั้ง Prompt ที่ป้อนเข้าและผลลัพธ์ที่สร้างออกมา ข้อความที่เกินขีดจำกัดนี้จะอยู่ในสภาพที่โมเดล "มองไม่เห็น" จึงเป็นพารามิเตอร์สำคัญที่ส่งผลโดยตรงต่อความแม่นยำในการประมวลผลเอกสารขนาดยาวและคุณภาพของการสนทนาแบบหลายรอบ
ทำไม Context Window จึงสำคัญ
LLM (Large Language Model) ประมวลผลข้อความโดยแบ่งออกเป็นหน่วยที่เรียกว่าโทเค็น (Token) Context Window เปรียบเสมือน "ภาชนะ" ที่บรรจุโทเค็นเหล่านี้ หากภาชนะเล็กก็อ่านเอกสารยาวในครั้งเดียวไม่ได้ หากภาชนะใหญ่ก็อนุมานโดยอ้างอิงข้อมูลได้กว้างขึ้น
ผลกระทบในการใช้งานจริงสรุปได้ 2 ข้อ
- ประมวลผลข้อความยาวได้หรือไม่: กำหนดว่าจะป้อนเอกสารที่ยาวหลายหมื่นถึงหลายแสนโทเค็น เช่น เอกสารกฎหมาย รายงานการเงิน หรือซอร์สโค้ดทั้ง Repository ได้ในครั้งเดียวหรือไม่
- ความต่อเนื่องของการสนทนา: แชทบอทหรือ AI Agent จะ "จำ" ประวัติการสนทนาได้มากเพียงใด ขึ้นอยู่กับขนาดของ Context Window
โมเดลรุ่นใหม่บางตัวมี Context Window ขนาดหลายแสนถึงหนึ่งล้านโทเค็น และโมเดลหลักอย่าง GPT, Claude และ Gemini ต่างกำหนดขีดจำกัดไว้แตกต่างกัน
กลไกทางเทคนิคและข้อจำกัด
ขนาดของ Context Window เกี่ยวข้องโดยตรงกับสถาปัตยกรรมของโมเดล โดยเฉพาะการออกแบบกลไก Attention เนื่องจาก Transformer คำนวณ Self-Attention กับอินพุตทั้งหมด เมื่อจำนวนโทเค็นเพิ่มขึ้น ปริมาณการคำนวณและการใช้หน่วยความจำของ GPU (Graphics Processing Unit) จะเพิ่มขึ้นอย่างรวดเร็ว นี่คือเหตุผลพื้นฐานที่ขยาย Context Window ได้ไม่จำกัด
นอกจากนี้ งานวิจัยยังชี้ว่าแม้ Context Window จะใหญ่ แต่โมเดลมักมองข้ามข้อมูลที่อยู่ช่วงกลางของบริบท ข้อมูลช่วงต้นและช่วงท้ายของบริบทยาวจะถูกจดจำได้ดี แต่ช่วงกลางได้รับความสนใจน้อยลง ปัญหานี้เรียกว่า "Lost in the Middle" การตัดสินคุณภาพจากตัวเลขขนาด Context Window เพียงอย่างเดียวจึงอันตราย และควรประเมินควบคู่กับความเสี่ยงของ Hallucination
ความสัมพันธ์กับ RAG และ AI Agent
แนวทางหลักที่ใช้ชดเชยข้อจำกัดของ Context Window คือ RAG (Retrieval-Augmented Generation) แทนที่จะใส่เอกสารทั้งหมดลงใน Context Window จะค้นหาเฉพาะข้อมูลที่จำเป็นแล้วแทรกเข้าไปแบบไดนามิก ทำให้ขยายขอบเขตการอ้างอิงได้ในทางปฏิบัติ ในบริบทนี้ การออกแบบขนาดชังก์ (Chunk Size) สำคัญเป็นพิเศษ หากชังก์ใหญ่เกินไปจะกินพื้นที่ Context Window หากเล็กเกินไปบริบทจะขาดตอน
ใน AI Agent และระบบ Multi-Agent การออกแบบให้หลาย Agent แบ่งงานกันเพื่อประมวลผลงานขนาดใหญ่เกินขีดจำกัดของโมเดลเดียวก็แพร่หลายมากขึ้น แนวคิด Context Engineering ก็ได้รับความสนใจเช่นกัน และกำลังพัฒนาเป็นศาสตร์ที่ออกแบบอย่างมีกลยุทธ์ว่าจะใส่อะไร และเรียงลำดับอย่างไรใน Context Window ที่มีจำกัด
ข้อควรระวังในการใช้งาน
ประเด็นที่มักถูกมองข้ามคือ อินพุตและเอาต์พุตถูกนับรวมกัน เช่น หากโมเดลมี Context Window 128,000 โทเค็น และป้อน Prompt ไป 120,000 โทเค็น จะสร้างผลลัพธ์ได้อีกเพียง 8,000 โทเค็น ในงานที่ต้องการผลลัพธ์ยาว เช่นการให้เหตุผลหลายขั้นตอนด้วยโมเดลการให้เหตุผล (Reasoning Model) หรืองานสร้างโค้ดอย่าง Claude Code การเผื่อพื้นที่สำหรับโทเค็นขาออกจะเป็นตัวกำหนดคุณภาพ
Context Window ไม่ใช่ตัวชี้วัดง่าย ๆ ที่ "ยิ่งใหญ่ยิ่งดี" การใช้งานอย่างเหมาะสมโดยคำนึงถึงความสมดุลระหว่างต้นทุน ความหน่วง (Latency) และความแม่นยำ คือการตัดสินใจเชิงออกแบบที่สำคัญในการนำ LLM ไปใช้งานจริง
บทความที่กล่าวถึงคำศัพท์นี้
- โมเดลเศรษฐศาสตร์และการออกแบบต้นทุนการดำเนินงานของ AI Agent — หลักการออกแบบเพื่อรองรับการใช้งานจริงในปี 2026การใช้งาน AI Agent ในระดับโปรดักชันต้องคำนึงถึงต้นทุนและโมเดลเศรษฐศาสตร์ตั้งแต่ระดับการออกแบบ ไม่ใช่แค่ลด Token พบกับหลักการออกแบบปี 2026 สำหรับ B2B
- การออกแบบงบประมาณความหน่วงสำหรับ AI Agent — วิธีควบคุมการแลกเปลี่ยนระหว่างเวลาคิดและเวลาตอบสนองอธิบายปัญหา "เวลาคิด" ใน Multi-step reasoning agent ที่ทำให้เกิดความล่าช้า พร้อมเปรียบเทียบการจัดสรร Latency budget และรูปแบบการใช้งานตามความซับซ้อนของงาน
- AI Agent คืออะไร? คู่มือการใช้ AI ยุคใหม่สำหรับธุรกิจไทยที่ต้องการระบบอัตโนมัติแบบอิสระอธิบายกลไก AI Agent และวิธีนำไปใช้ในองค์กรไทย พร้อมเปรียบเทียบกับ Chatbot แบบเดิม ขั้นตอนการติดตั้ง และกรณีศึกษาจริง
- Context Engineering คืออะไร? กระบวนทัศน์ใหม่ของการพัฒนา LLM และวิวัฒนาการจาก Prompt EngineeringContext Engineering คือเทคนิคการออกแบบเพื่อจัดเตรียมข้อมูลที่เหมาะสมที่สุดให้กับ LLM เรียนรู้ความแตกต่างจาก Prompt Engineering และรูปแบบการใช้งาน RAG/Agent


คำศัพท์ที่เกี่ยวข้อง
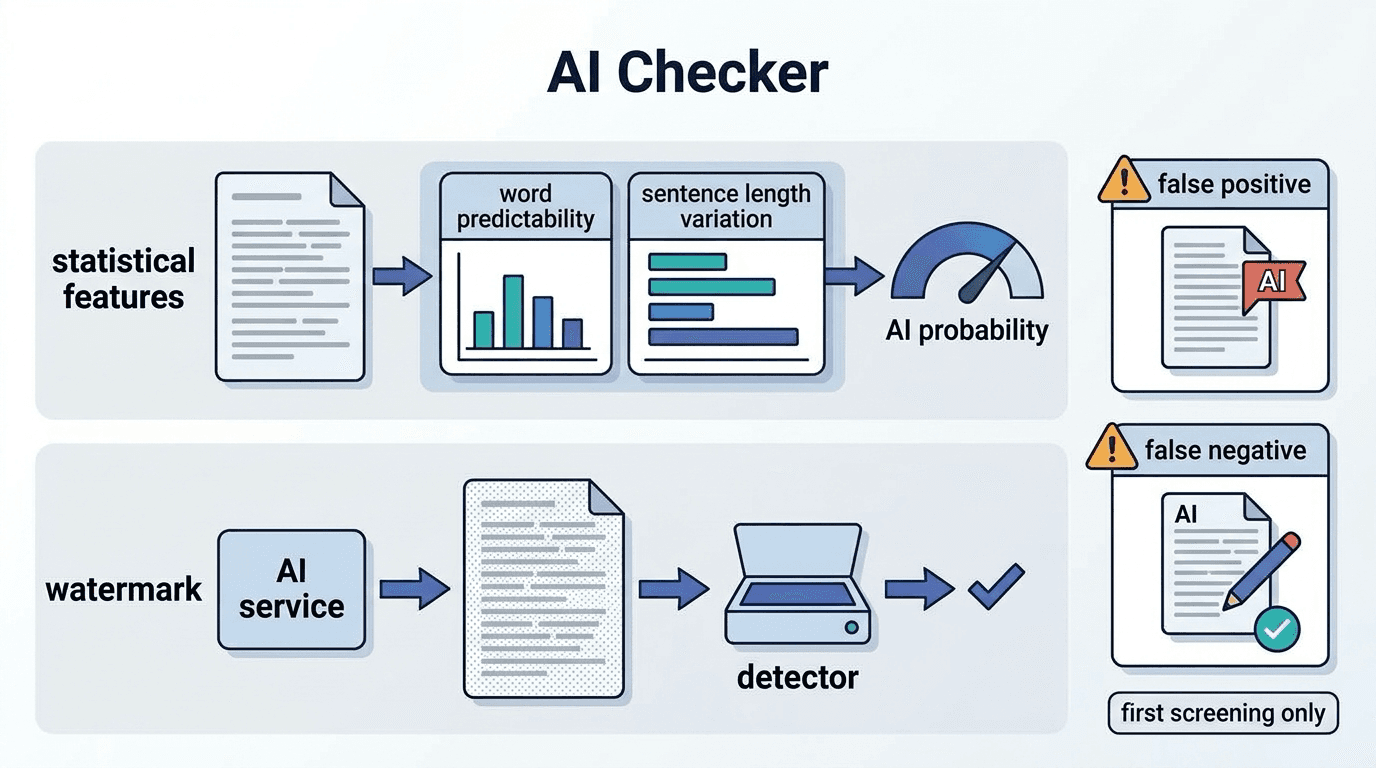
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
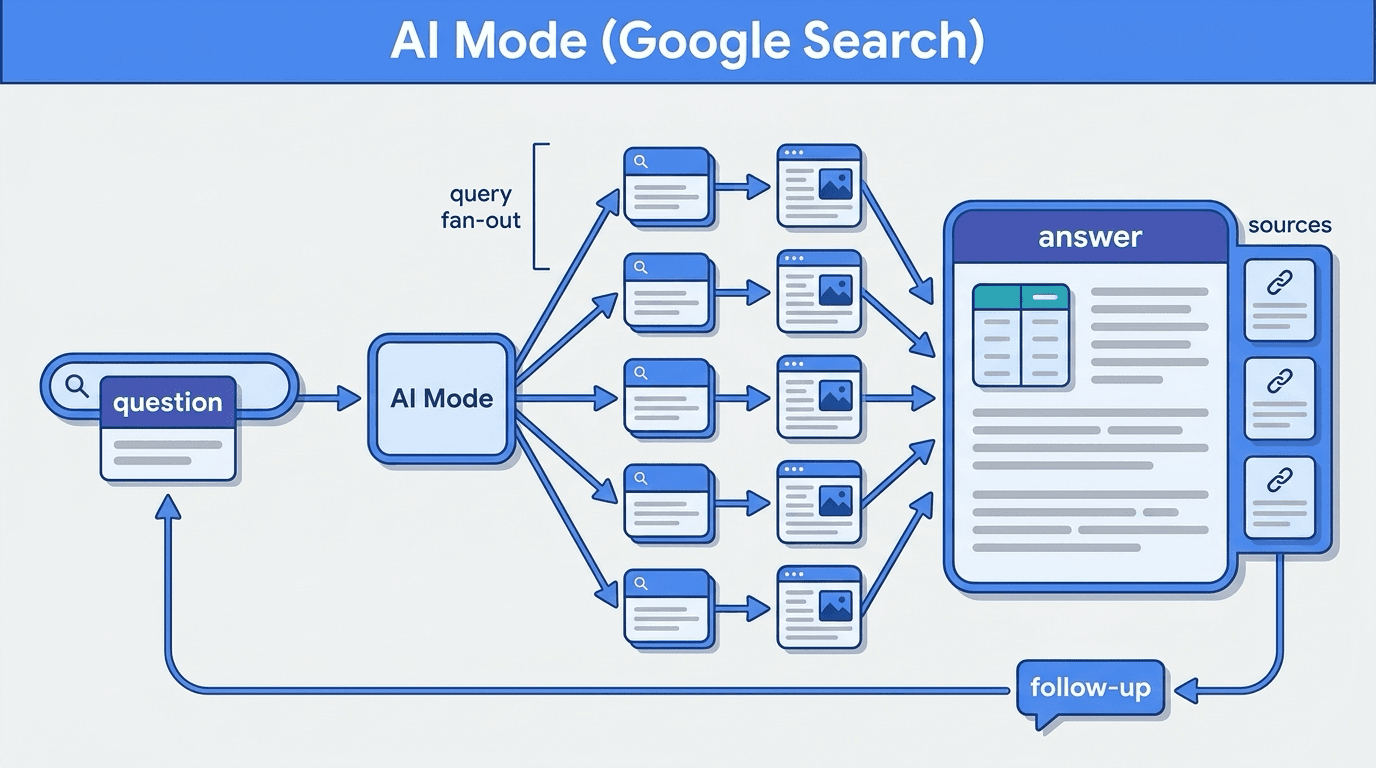
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
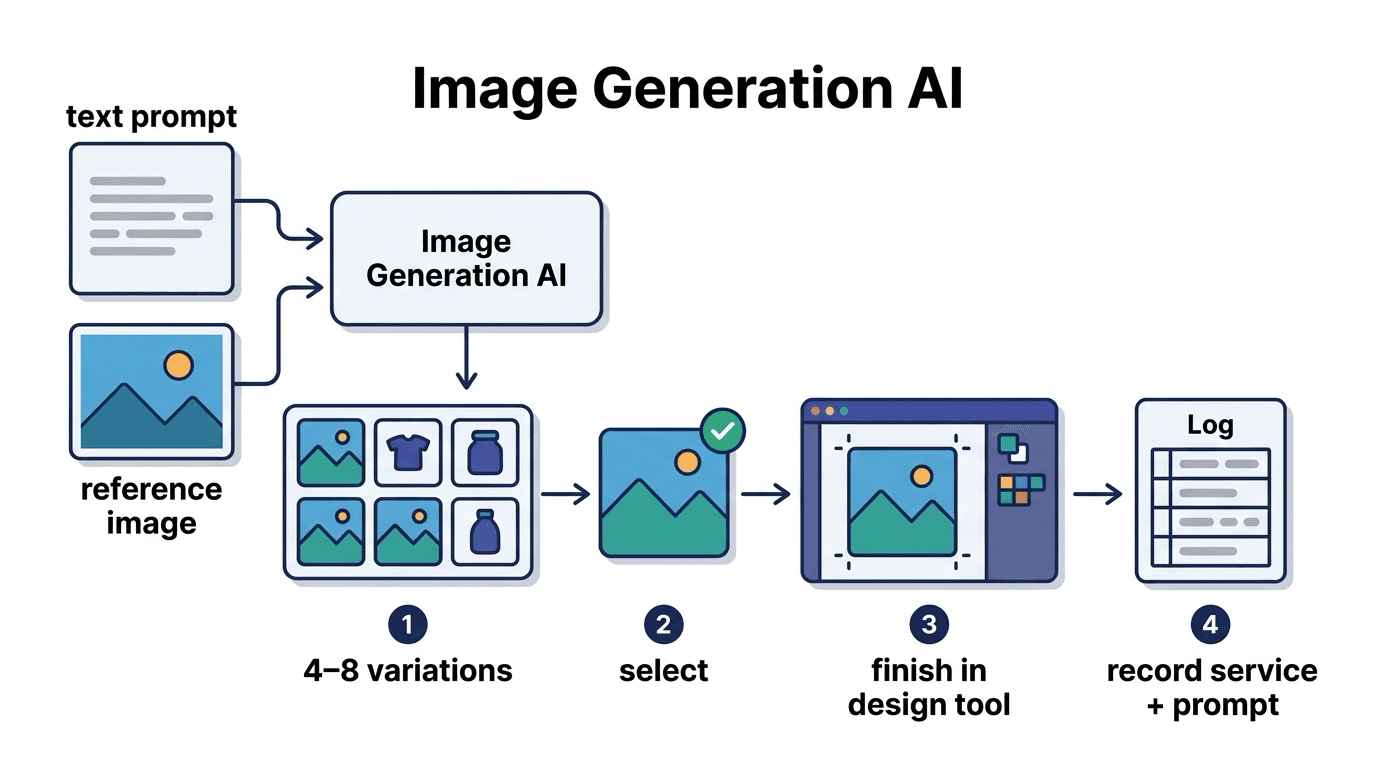
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
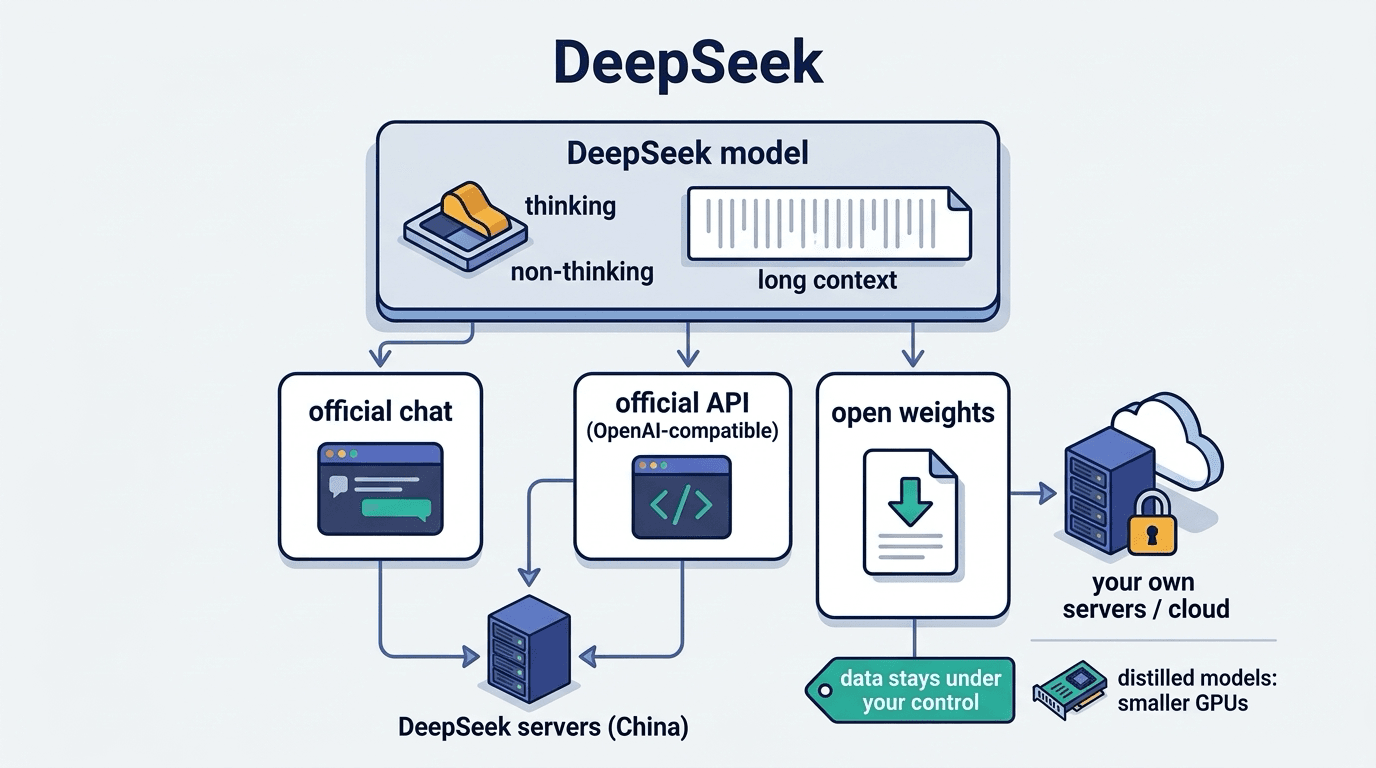
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ