โมเดลการอนุมาน (Reasoning Model)

โมเดลภาษาขนาดใหญ่ประเภทหนึ่งที่สร้างห่วงโซ่การคิดอย่างชัดเจนก่อนตอบคำถาม เพื่อแก้ปัญหาที่ซับซ้อนแบบทีละขั้นตอน
Reasoning Model คืออะไร
Reasoning Model คือ LLM ประเภทหนึ่งที่สร้าง Chain of Thought (ลำดับความคิด) อย่างชัดเจนภายในก่อนที่จะแสดงคำตอบ เพื่อแก้ปัญหาที่ซับซ้อนอย่างเป็นขั้นตอน ไม่ว่าจะเป็นการพิสูจน์ทางคณิตศาสตร์หรือการสร้างโค้ด
ในขณะที่ LLM ทั่วไปทำนายโทเค็นถัดไปแบบ "อัตโนมัติ" Reasoning Model จะแยกย่อยปัญหา ตรวจสอบขั้นตอนกลางด้วยตัวเอง แล้วจึงไปถึงคำตอบสุดท้าย ถือได้ว่าเป็นการออกแบบที่สะท้อนแนวคิดของ Test-time Compute (การปรับขนาดในช่วงอนุมาน)
โมเดลที่เป็นตัวแทน
ได้แก่ o series ของ OpenAI, DeepSeek-R1 และโหมด extended thinking ของ Anthropic Claude เป็นต้น โมเดลเหล่านี้มีแนวโน้มที่ความแม่นยำจะเพิ่มขึ้นตามระยะเวลาที่ใช้ "คิด" และจุดเด่นคือผู้ใช้สามารถควบคุม Trade-off ระหว่างจำนวน Reasoning Token กับความแม่นยำได้
การพิจารณาว่าควรใช้เมื่อใด
Reasoning Model ไม่ใช่สิ่งที่ใช้ได้กับทุกสถานการณ์ สำหรับงานที่ต้องการคำตอบทันที เช่น การสรุปหรือการแปลที่ไม่ซับซ้อน LLM ทั่วไปจะได้เปรียบกว่าทั้งในด้านต้นทุนและความเร็ว จากประสบการณ์ของผู้เขียน การแบ่งการใช้งานโดยใช้โมเดลทั่วไปสำหรับ Q&A ความรู้ภายในองค์กร และใช้ Reasoning Model สำหรับการวิเคราะห์ความเสี่ยงในสัญญา มักจะคุ้มค่ากว่า
การจัดระเบียบล่วงหน้าว่างานใดบ้างที่ต้องการ "เวลาในการคิด" คือก้าวแรกของการนำ Reasoning Model มาใช้งาน
บทความที่กล่าวถึงคำศัพท์นี้
- Token Trap คืออะไร? วิธีจัดการการใช้งานเพื่อป้องกันค่าใช้จ่ายพุ่งสูงใน AI Agentทำความเข้าใจกลไก "Token Trap" ที่ทำให้ค่าใช้จ่ายพุ่งสูงจาก Agent Loop พร้อมวิธีป้องกันด้วยการตั้งงบประมาณ, Throttling และการออกแบบ Loop ให้มีประสิทธิภาพ
- LLM-as-a-Judge คืออะไร? วิธีประเมินผลลัพธ์ AI ด้วย AI และการตรวจจับ HallucinationLLM-as-a-Judge คือวิธีประเมินผลลัพธ์ LLM ด้วย LLM เอง ครอบคลุมการเปรียบเทียบวิธีต่างๆ การแก้ Bias, 4 ขั้นตอนการใช้งาน และการผสานกับ Observability และ Guardrails
- การออกแบบงบประมาณความหน่วงสำหรับ AI Agent — วิธีควบคุมการแลกเปลี่ยนระหว่างเวลาคิดและเวลาตอบสนองอธิบายปัญหา "เวลาคิด" ใน Multi-step reasoning agent ที่ทำให้เกิดความล่าช้า พร้อมเปรียบเทียบการจัดสรร Latency budget และรูปแบบการใช้งานตามความซับซ้อนของงาน
- คู่มือการเพิ่มประสิทธิภาพต้นทุน LLM — การลดโทเค็น การเลือกโมเดล และการทำแคชคู่มือลดต้นทุนการใช้งาน LLM ในระดับโปรดักชัน ด้วย 4 กลยุทธ์: การปรับแต่ง Token, การเลือก Model, Prompt Cache และ RAG เพื่อลดค่าใช้จ่ายรายเดือนลงครึ่งหนึ่งโดยยังคงความแม่นยำไว้ได้


คำศัพท์ที่เกี่ยวข้อง
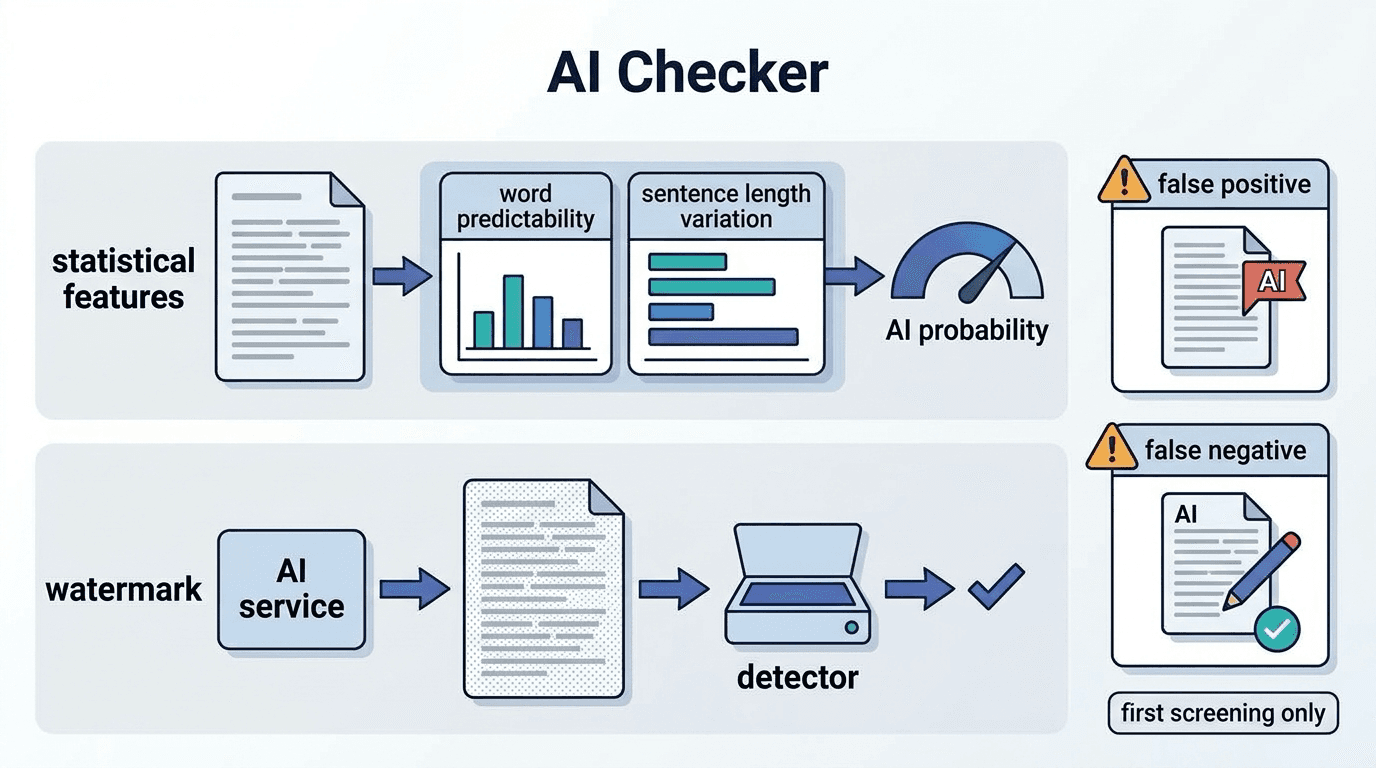
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
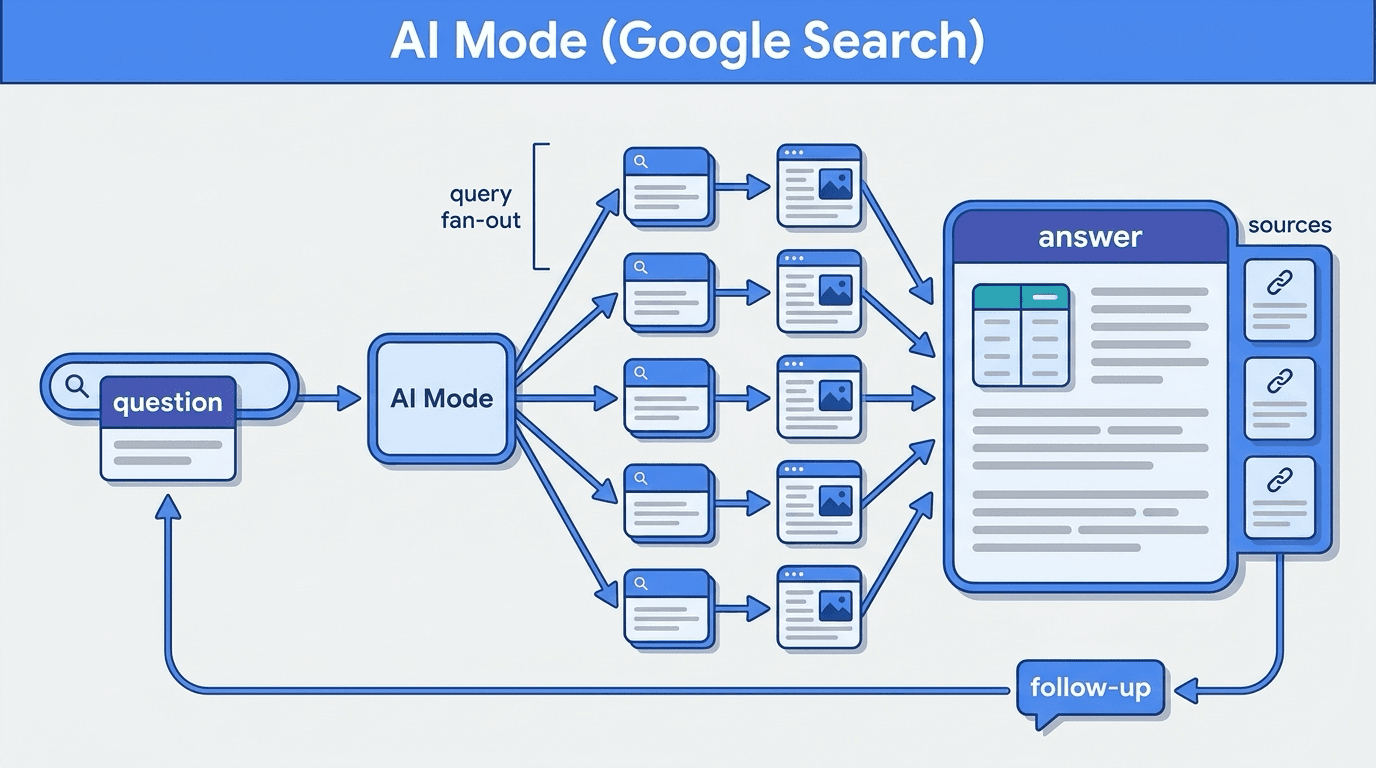
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
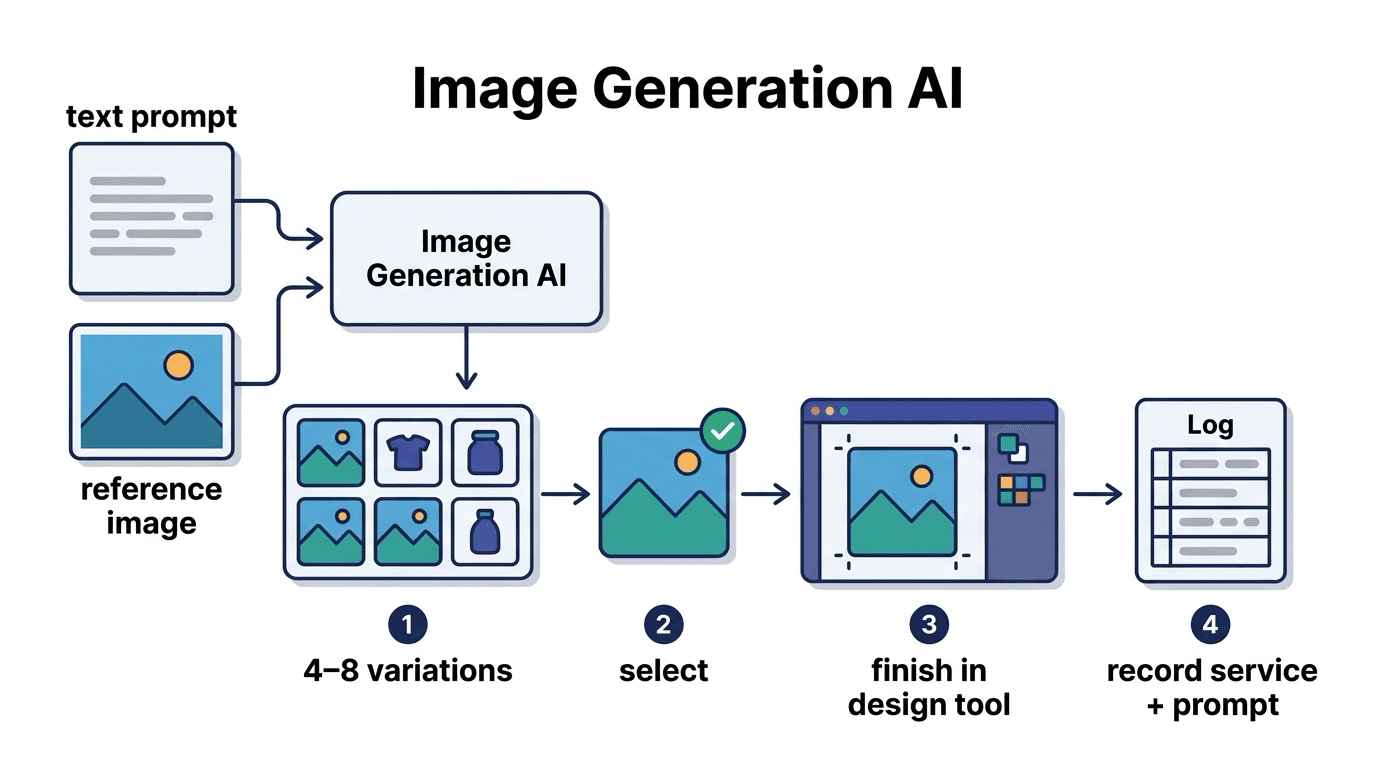
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
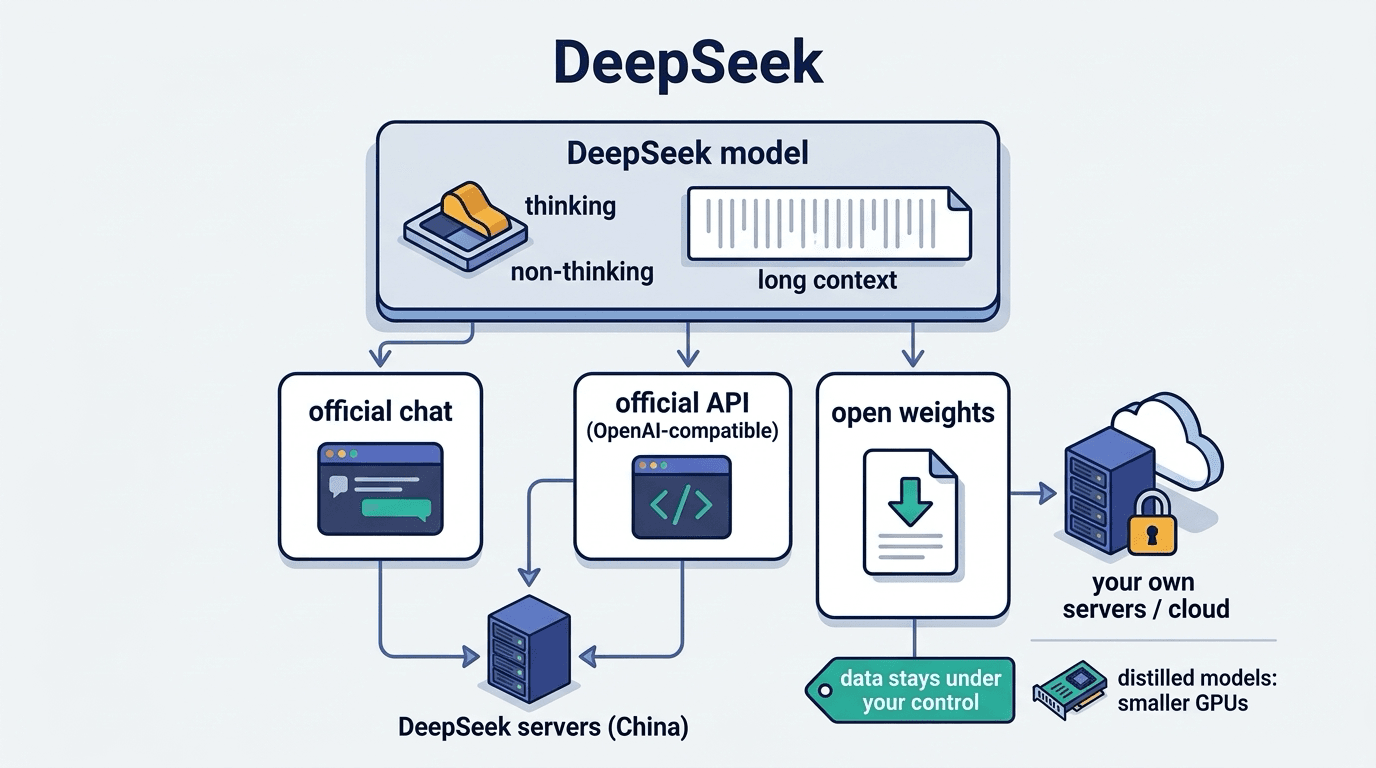
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ