โทเค็น (Token)
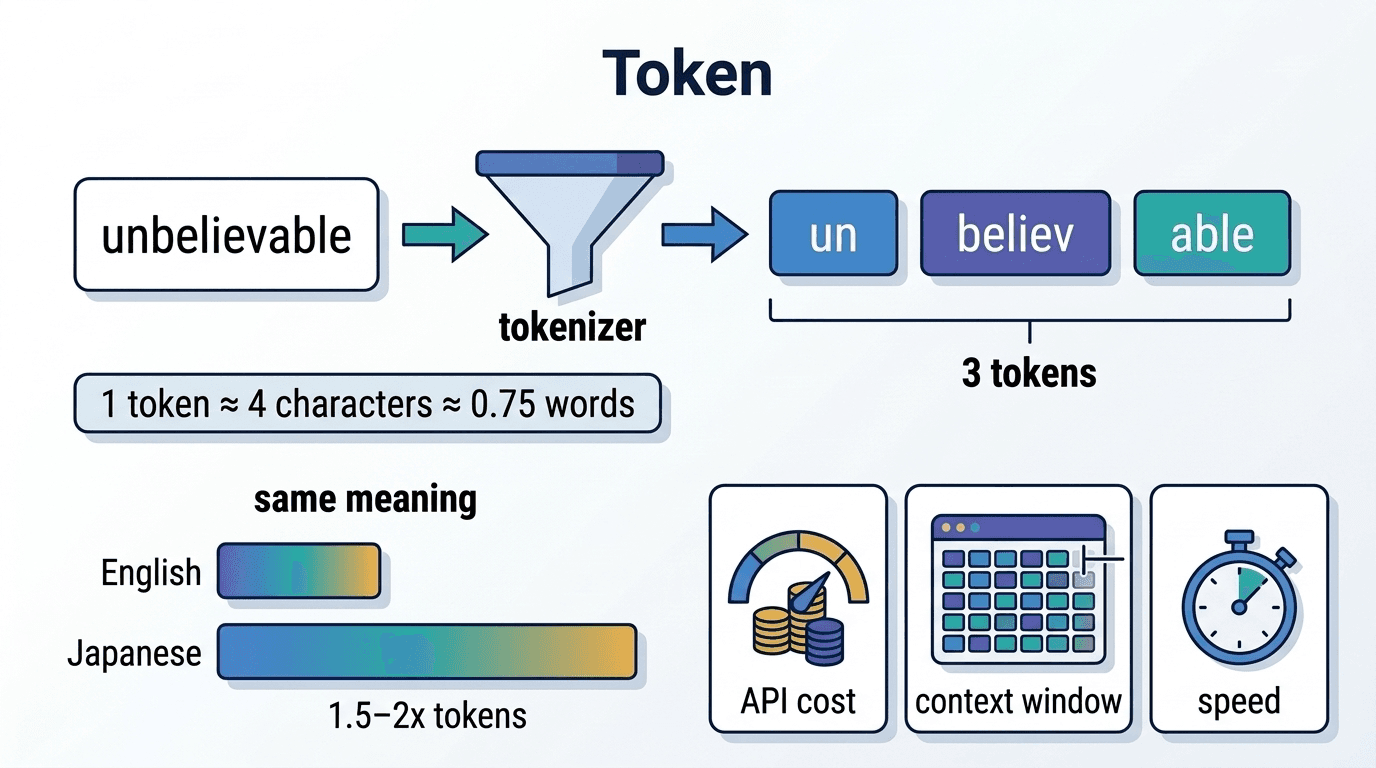
Token คือหน่วยที่เล็กที่สุดที่ LLM ใช้ในการประมวลผลข้อความ โดยไม่ได้หมายถึงคำทั้งคำเสมอไป แต่ยังรวมถึงส่วนหนึ่งของคำ สัญลักษณ์ หรือช่องว่าง ซึ่งเป็นผลจากการแบ่งข้อความตามคลังคำศัพท์ (Vocabulary) ของโมเดล
ต่างจากคำศัพท์ทั่วไป
เมื่อได้ยินคำว่า "โทเค็น" หลายคนมักนึกถึงคำศัพท์ แต่ในความเป็นจริงแล้วมีความละเอียดกว่านั้น คำในภาษาอังกฤษอย่าง "unbelievable" อาจถูกแบ่งออกเป็น 3 โทเค็น ได้แก่ "un", "believ" และ "able" สำหรับภาษาญี่ปุ่นนั้นซับซ้อนยิ่งกว่า เนื่องจากอักษรฮิรางานะหนึ่งตัวอาจเป็น 1 โทเค็น ในขณะที่อักษรคันจิหนึ่งตัวอาจใช้ถึง 2–3 โทเค็น
กระบวนการแบ่งนี้เรียกว่า Tokenization และแต่ละโมเดลจะใช้อัลกอริทึมที่แตกต่างกัน เช่น BPE หรือ SentencePiece นี่คือเหตุผลที่ประโยคเดียวกันอาจมีจำนวนโทเค็นต่างกันไปตามแต่ละโมเดล
เหตุใดจำนวนโทเค็นจึงสำคัญ
ต้นทุนและประสิทธิภาพของ LLM นั้นขึ้นอยู่กับจำนวนโทเค็นเป็นหลัก ค่าบริการ API โดยทั่วไปจะคิดตามจำนวนโทเค็นของ Input และ Output และ Context Window (ปริมาณข้อความที่โมเดลสามารถประมวลผลได้ในครั้งเดียว) ก็ถูกกำหนดด้วยจำนวนโทเค็นเช่นกัน
จำนวนโทเค็นยังส่งผลโดยตรงต่อความเร็วในการ Inference ด้วย ใน Dense Model พารามิเตอร์ทั้งหมดจะมีส่วนร่วมในการประมวลผลแต่ละโทเค็น ดังนั้นเมื่อจำนวนโทเค็นเพิ่มขึ้น ปริมาณการคำนวณก็จะเพิ่มขึ้นตามสัดส่วน ข้อจำกัดนี้เองที่ทำให้งานสรุปข้อความยาวต้องมีเทคนิคในการบีบอัด Input
การประมาณการในงานจริง
สำหรับภาษาอังกฤษ มักใช้ค่าประมาณว่า "1 โทเค็น ≈ 4 ตัวอักษร ≈ 0.75 คำ" ส่วนภาษาญี่ปุ่นมีประสิทธิภาพของโทเค็นต่ำกว่า โดยมีแนวโน้มใช้โทเค็นมากกว่าภาษาอังกฤษถึง 1.5–2 เท่าสำหรับเนื้อหาที่มีความหมายเดียวกัน ในการออกแบบระบบที่รองรับหลายภาษา จำเป็นต้องนำความแตกต่างนี้มาคำนวณรวมในการประมาณต้นทุนด้วย
บทความที่กล่าวถึงคำศัพท์นี้
- คู่มือการเพิ่มประสิทธิภาพต้นทุน LLM — การลดโทเค็น การเลือกโมเดล และการทำแคชคู่มือลดต้นทุนการใช้งาน LLM ในระดับโปรดักชัน ด้วย 4 กลยุทธ์: การปรับแต่ง Token, การเลือก Model, Prompt Cache และ RAG เพื่อลดค่าใช้จ่ายรายเดือนลงครึ่งหนึ่งโดยยังคงความแม่นยำไว้ได้
- Token Trap คืออะไร? วิธีจัดการการใช้งานเพื่อป้องกันค่าใช้จ่ายพุ่งสูงใน AI Agentทำความเข้าใจกลไก "Token Trap" ที่ทำให้ค่าใช้จ่ายพุ่งสูงจาก Agent Loop พร้อมวิธีป้องกันด้วยการตั้งงบประมาณ, Throttling และการออกแบบ Loop ให้มีประสิทธิภาพ
- การเปรียบเทียบการติดตั้ง LLM / SLM แบบโลคอล — การใช้ AI โดยไม่พึ่งพา Cloud APIเปรียบเทียบ Open-weight Model เช่น GPT OSS, Phi-4, Llama 4 Scout กับ Cloud API ใน 3 มิติ: GPU, ความแม่นยำ และ TCO พร้อมคู่มือ Local AI เพื่อ Data Sovereignty และลดต้นทุน
- วิธีเลือกใช้ Fine-tuning และ RAG: คู่มือเปรียบเทียบตามต้นทุน ความแม่นยำ และการใช้งานจริงเลือกใช้ Fine-tuning หรือ RAG ดี? เปรียบเทียบ 4 ปัจจัยหลัก (ต้นทุน, ความแม่นยำ, การอัปเดต, ความปลอดภัย) พร้อมเกณฑ์การเลือกที่เหมาะสมกับธุรกิจคุณ


คำศัพท์ที่เกี่ยวข้อง
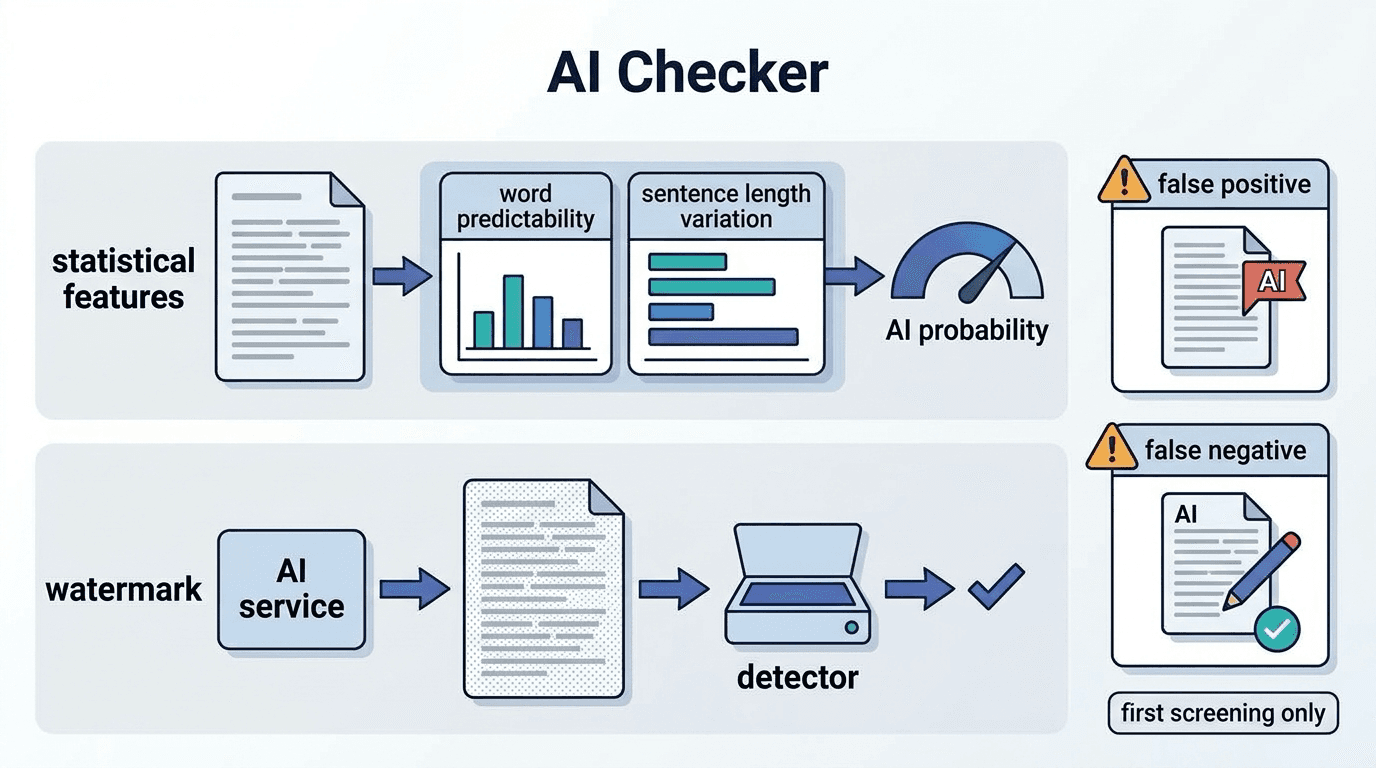
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
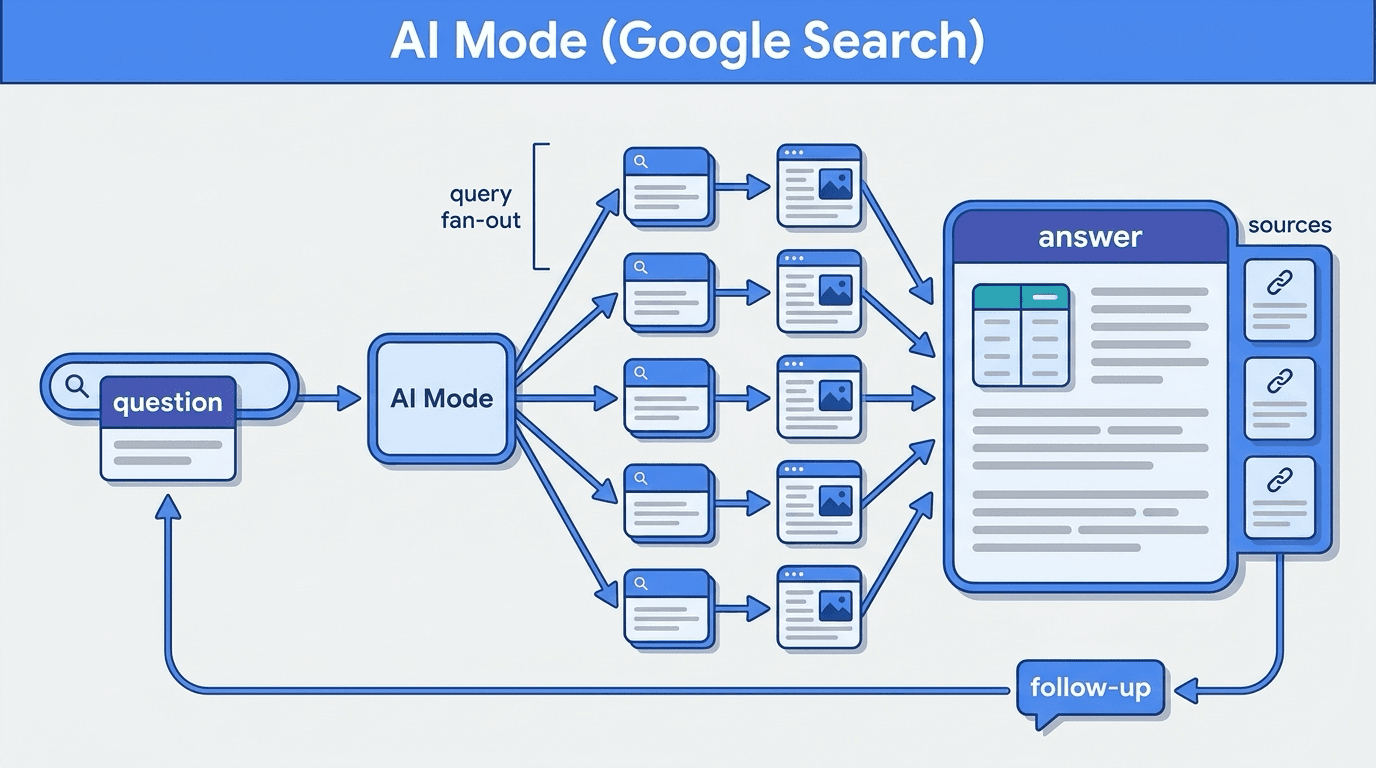
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
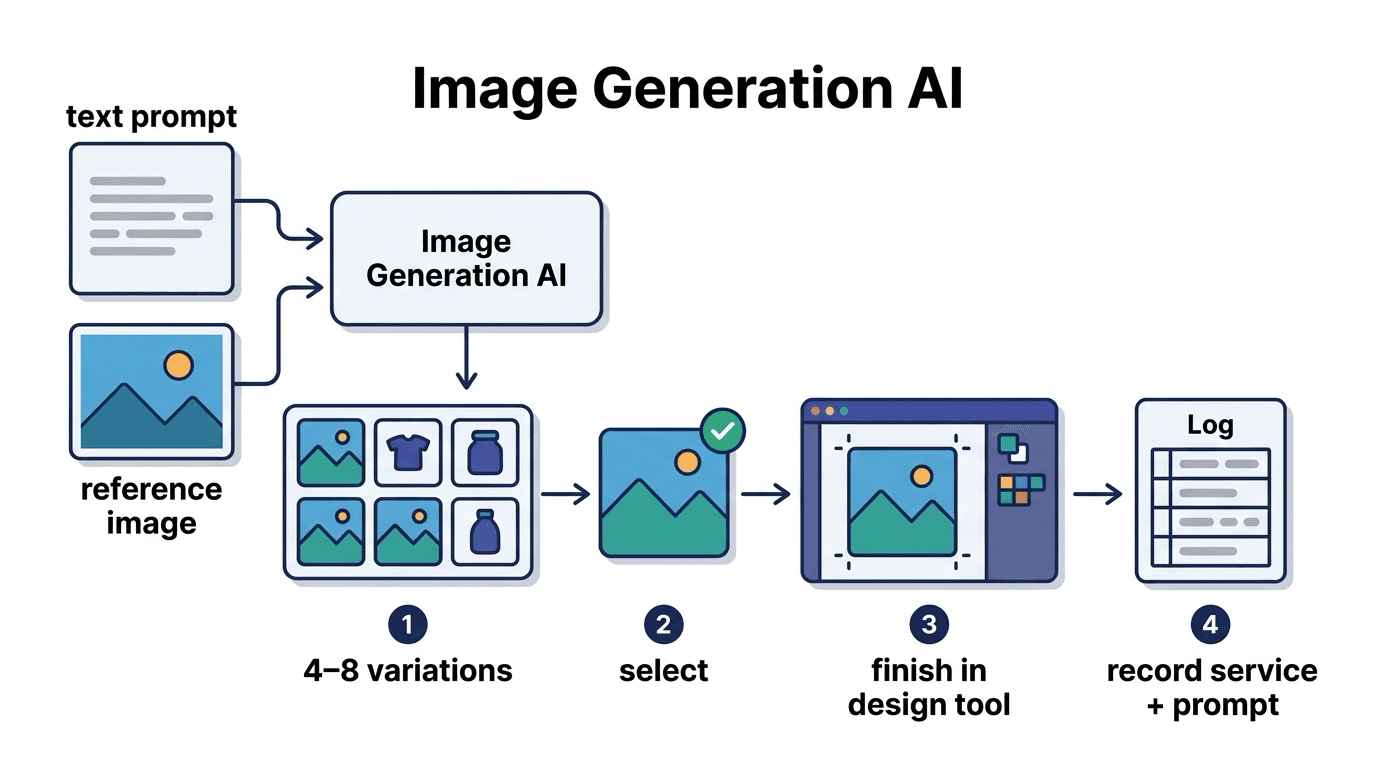
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
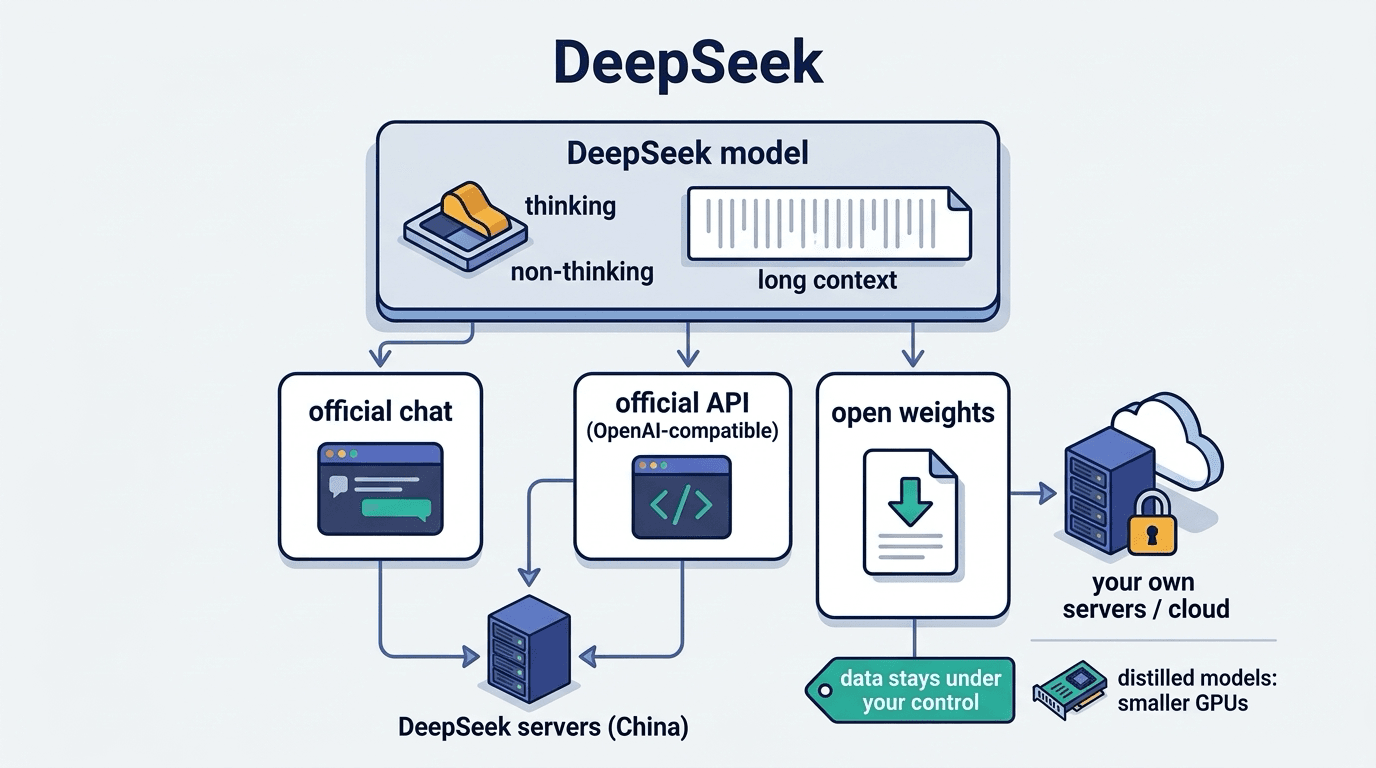
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ