Google AI Studio
グーグルエーアイスタジオ
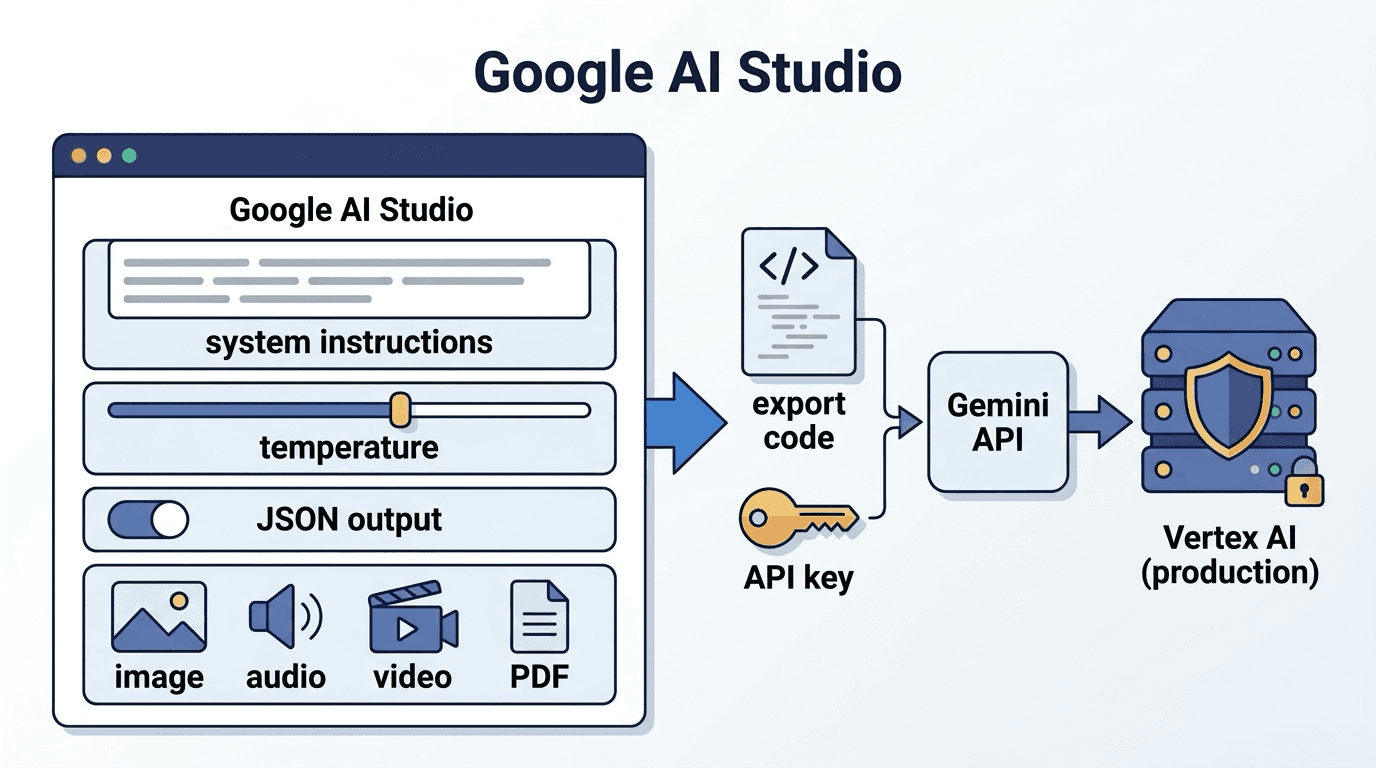
Google AI Studio とは、Google の生成 AI モデル Gemini をブラウザ上で試し、プロンプトの検証や API キーの発行ができる開発者向けの無料ツールである。
Google AI Studio は、Google の生成 AI モデル「Gemini」をブラウザ上で試し、プロンプトの検証・パラメータ調整・API キーの発行までを行える開発者向けのツールである。一般の利用者向けのチャットである Gemini アプリに対し、AI Studio はアプリやシステムに組み込む前の「実験室」にあたる。
できること
- プロンプトの試作: システム指示、温度などのパラメータ、出力形式(JSON など)を変えながら結果を比べる
- マルチモーダル入力: 画像・音声・動画・PDF を読み込ませる
- ツールの検証: Google 検索によるグラウンディング、コード実行、関数呼び出し
- コードの書き出しと API キーの発行: 試したプロンプトを Python や JavaScript のコードとして出力し、そのまま Gemini API から呼べる
- アプリの試作: 作りたいアプリを文章で説明すると動く Web アプリを生成し、Google Cloud への公開まで進められる
無料枠と有料枠の違い
AI Studio 自体は無料で使える。Gemini API にも無料枠があり、回数やトークン数の上限付きで主なモデルを呼び出せる。一方、動画・画像の生成など一部のモデルは有料枠でしか使えない。
見落とされやすいのがデータの扱いである。公式の料金ページには、無料枠で送った内容は Google の製品改善に使われ、有料枠では使われないと明記されている。顧客情報や社内資料を使う検証は、有料枠か Google Cloud の Vertex AI で行いたい。
試作から本番への進め方
- 役割と制約をシステム指示に書き、評価用の入力を数十件用意して試す
- モデル・温度・最大出力トークンを変えて結果を比べ、採用する設定を決める
- コードを書き出し、プロンプトもコード管理に入れて変更の履歴を追えるようにする
- 認証・監査・リージョン指定・SLA が要る本番は Vertex AI に移す
モデルは頻繁に更新され、同じプロンプトでも結果が変わることがある。評価セットを持ち、更新のたびに回帰確認をする運用が欠かせない。プロンプトの書き方はプロンプトエンジニアリングとシステムプロンプトを参照してほしい。PoC の設計手順は AI 導入の PoC 設計ガイドにまとめており、PoC から本番化までの設計は AI・DX サービスで支援している。
この用語を扱う記事
- Harness AI とは?DevOps に AI を組み込む仕組みと導入手順を解説Harness AI は DevOps プラットフォーム Harness が提供する AI エージェント群です。5 つのエージェントの役割、対応モデル、導入前の確認ポイント、PoC からの進め方、HITL 設計まで実務目線で解説します。
- LLMコスト最適化ガイド — トークン削減・モデル選定・キャッシュ実装LLM の本番運用で膨らむコストを削減する実践ガイド。トークン最適化・モデル選定・プロンプトキャッシュ・RAG 設計の4つの柱で、精度を保ちつつ月額コストを半減させる実装パターンを解説する。
- タイの中小企業が生成AIでマーケティングコストを削減する方法タイの中小企業が生成AIでSNS・ECのコンテンツ制作コストを削減する方法を解説。LINE・TikTok向けの画像・動画・文章生成の実践手順を紹介。
- オフショア開発チームのAI技術格差:スキル習得ロードマップと研修体制オフショア開発チームのAI技術格差を解決する研修体制とスキル習得ロードマップ。技術トレンド追従の仕組み、効果的なナレッジ共有、段階的な習得プログラムを実装方法とともに解説。


関連用語
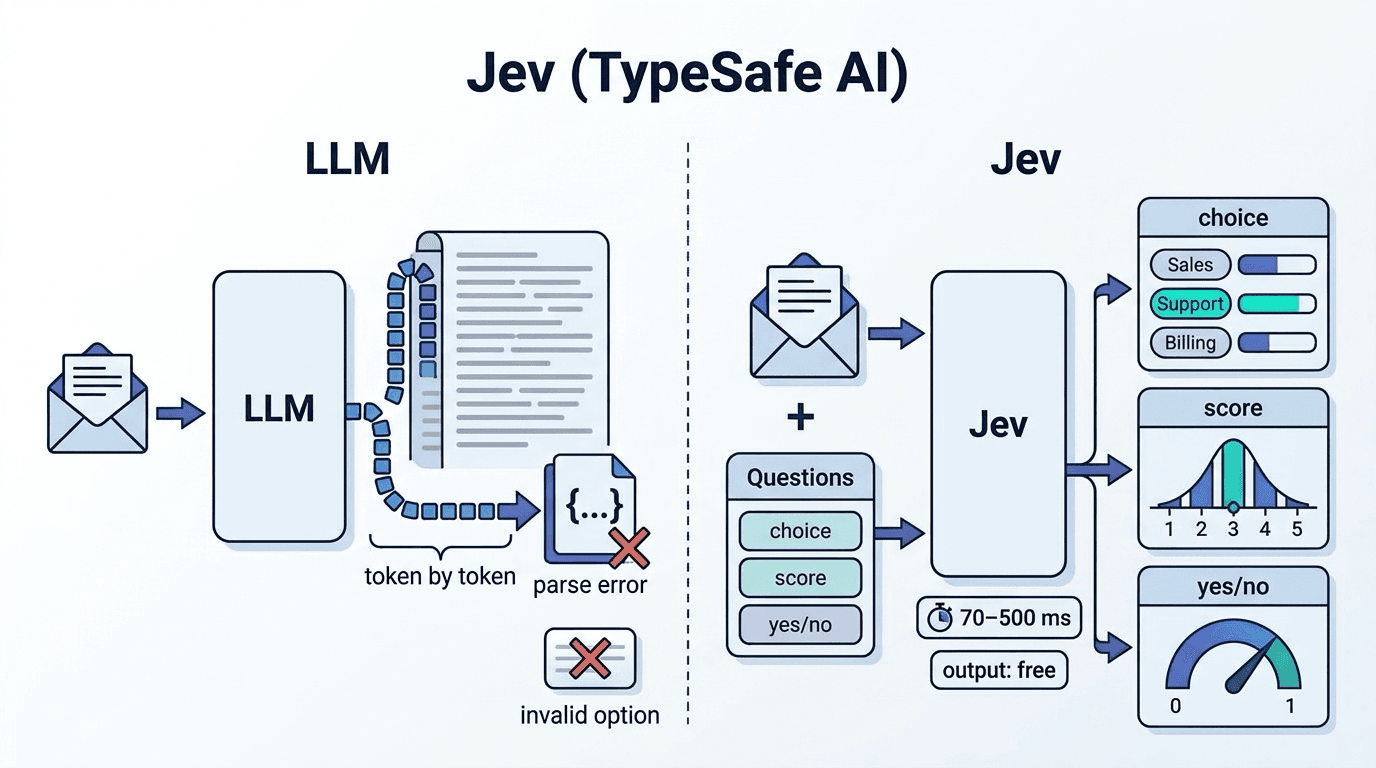
Jev(TypeSafe AI)
Jev とは、TypeSafe AI が開発した判断専用の AI モデルで、文章を生成せず、あらかじめ決めた選択・段階評価・真偽の判断を確率付きで返す「System One モデル」である。

PEFT
PEFT(Parameter-Efficient Fine-Tuning)とは、大規模言語モデルの全パラメータではなく一部のみを更新することで、少ない計算資源とデータでモデルを特定タスクに適応させるフ
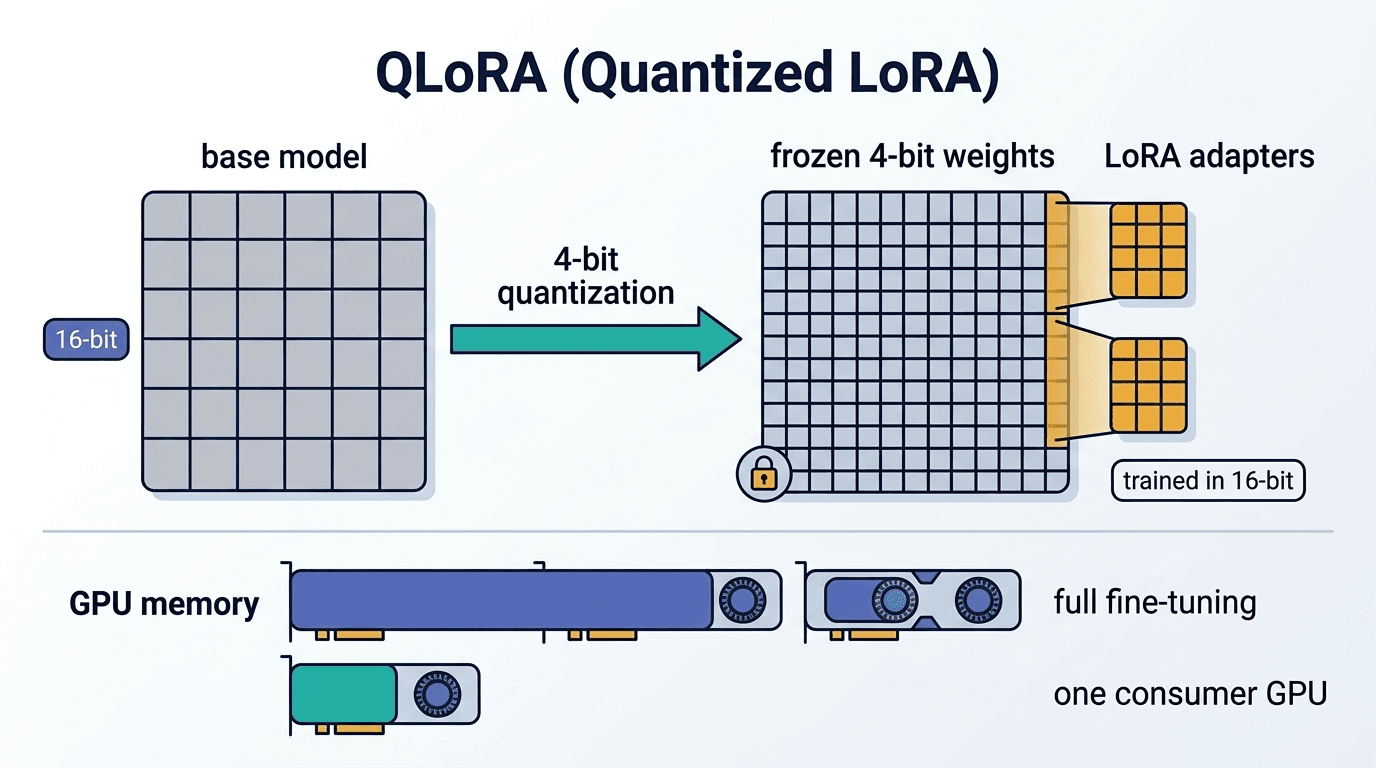
QLoRA
QLoRA(Quantized LoRA)とは、LoRA に 4bit 量子化を組み合わせることで、コンシューマ向け GPU でも大規模言語モデルのファインチューニングを可能にした手法である。
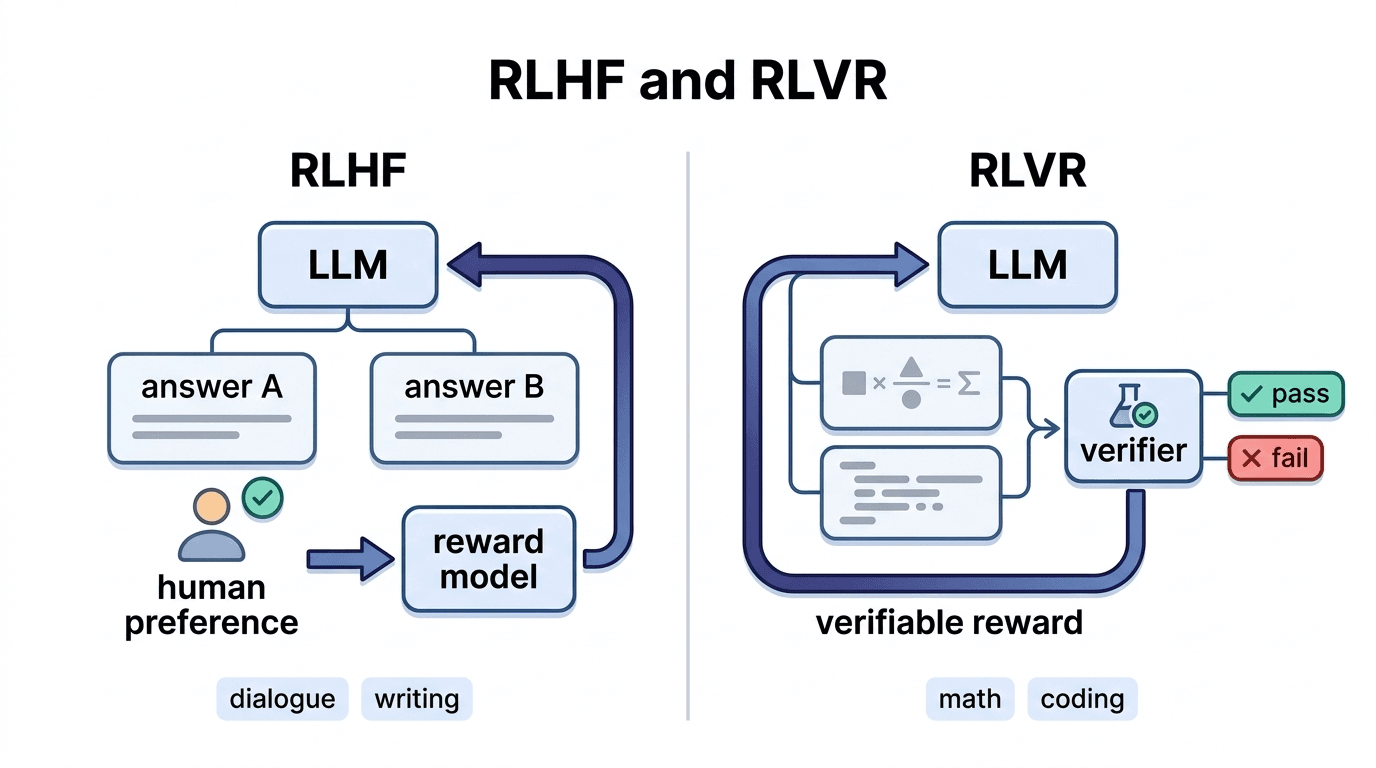
RLHF
RLHFとは人間のフィードバックを報酬として使う強化学習手法、RLVRとは検証可能な正解を報酬として使う強化学習手法であり、いずれもLLMの出力を人間の期待に沿うよう調整するために用いられる。