Jev(TypeSafe AI)
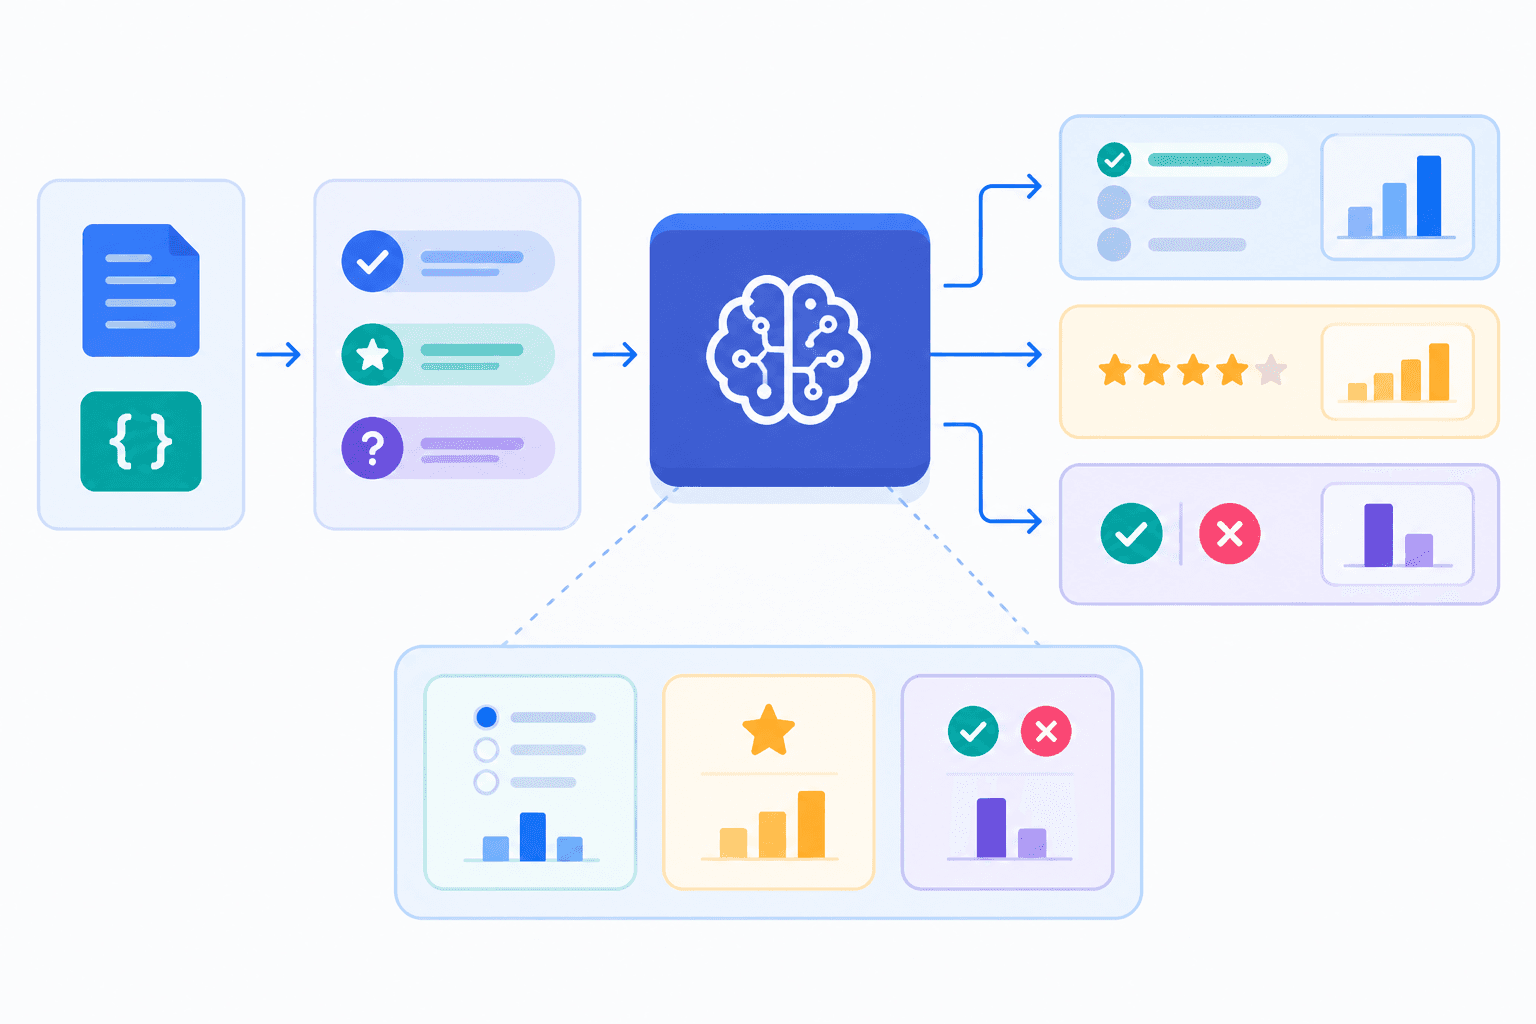
Jev とは、TypeSafe AI が開発した判断専用の AI モデルで、文章を生成せず、あらかじめ決めた選択・段階評価・真偽の判断を確率付きで返す「System One モデル」である。
Jev は、TypeSafe AI が早期アクセスとして公開した AI モデルである。一般的な大規模言語モデル(LLM)が文章を 1 トークンずつ生成するのに対し、Jev は文章を生成しない。入力された状態(テキストや JSON)と「問い」を受け取り、あらかじめ決めた型の答えを確率付きで返す。TypeSafe AI はこれを「System One モデル」と呼んでいる。人の速く直感的な判断(システム 1)になぞらえた名前だ。
返せる判断は 3 種類
| 種類 | 問いの例 | 返ってくるもの |
|---|---|---|
| choice(選択) | この問い合わせの担当部署はどれか | 選んだ選択肢と、選択肢ごとの確率 |
| score(段階評価) | このクレームの緊急度は 1〜5 のどれか | 期待値としてのスコアと、各段階の確率 |
| noul(真偽) | この文面に個人情報が含まれるか | 「はい」である確率(0〜1) |
1 回の呼び出しに複数の問いを混ぜられ、それぞれが独立に並列で評価される。出力は必ず決めた型に収まるため、LLM の出力を JSON として読み取れずに失敗する、存在しない選択肢を答える、といった問題が起きない。
LLM と何が違うのか
大きいのは速さと価格である。公式発表では、応答時間はエンドツーエンドで 70〜500 ミリ秒、料金は入力 100 万トークンあたり 0.042 ドルで、出力は無料とされている。同じ種類の判断を LLM で行う場合と比べて 40〜200 倍速いというのが TypeSafe AI の主張だ。
確率が実際に当たる割合と一致するように学習させている(キャリブレーション)とされ、確率をしきい値にして「自信が低いときだけ人に回す」設計が組みやすい。人が判断に加わる HITL の仕組みと相性がよい。
その代わり、文章は一切書けない。要約・回答文の作成・翻訳は従来どおり LLM の仕事で、Jev は分類、振り分け、採点、条件分岐といった「判断だけ」を担う。
向いている使い方と注意点
問い合わせメールの振り分け、チケットの優先度付け、AI エージェントが次に取る行動の選択、生成物の自動チェック(AI ガードレール)など、1 日に何千回も走る判断に向く。
注意したいのは言語である。公式ドキュメントでは英語が主な対象で、日本語を含むほかの言語は扱えるものの精度は同等ではないとされている。入力はテキストのみで、画像や音声は扱えない。日本語の業務に使うなら、自社の過去データで正解率を測ってから本番に組み込みたい。早期アクセスの段階なので、仕様や料金が変わる可能性もある。
同じ考え方のモデルを重み公開(Apache 2.0 ライセンス)で提供する Laya(Convai Innovations)もあり、データを外に出せない場合の選択肢になる(オープンウェイトモデル)。判断を担う AI を業務フローにどう組み込むかは、AI・DX サービスで相談を受けている。
関連用語

PEFT
PEFT(Parameter-Efficient Fine-Tuning)とは、大規模言語モデルの全パラメータではなく一部のみを更新することで、少ない計算資源とデータでモデルを特定タスクに適応させるフ

QLoRA
QLoRA(Quantized LoRA)とは、LoRA に 4bit 量子化を組み合わせることで、コンシューマ向け GPU でも大規模言語モデルのファインチューニングを可能にした手法である。

RLHF
RLHFとは人間のフィードバックを報酬として使う強化学習手法、RLVRとは検証可能な正解を報酬として使う強化学習手法であり、いずれもLLMの出力を人間の期待に沿うよう調整するために用いられる。
AI チェッカー(AI 生成文章判定ツール)
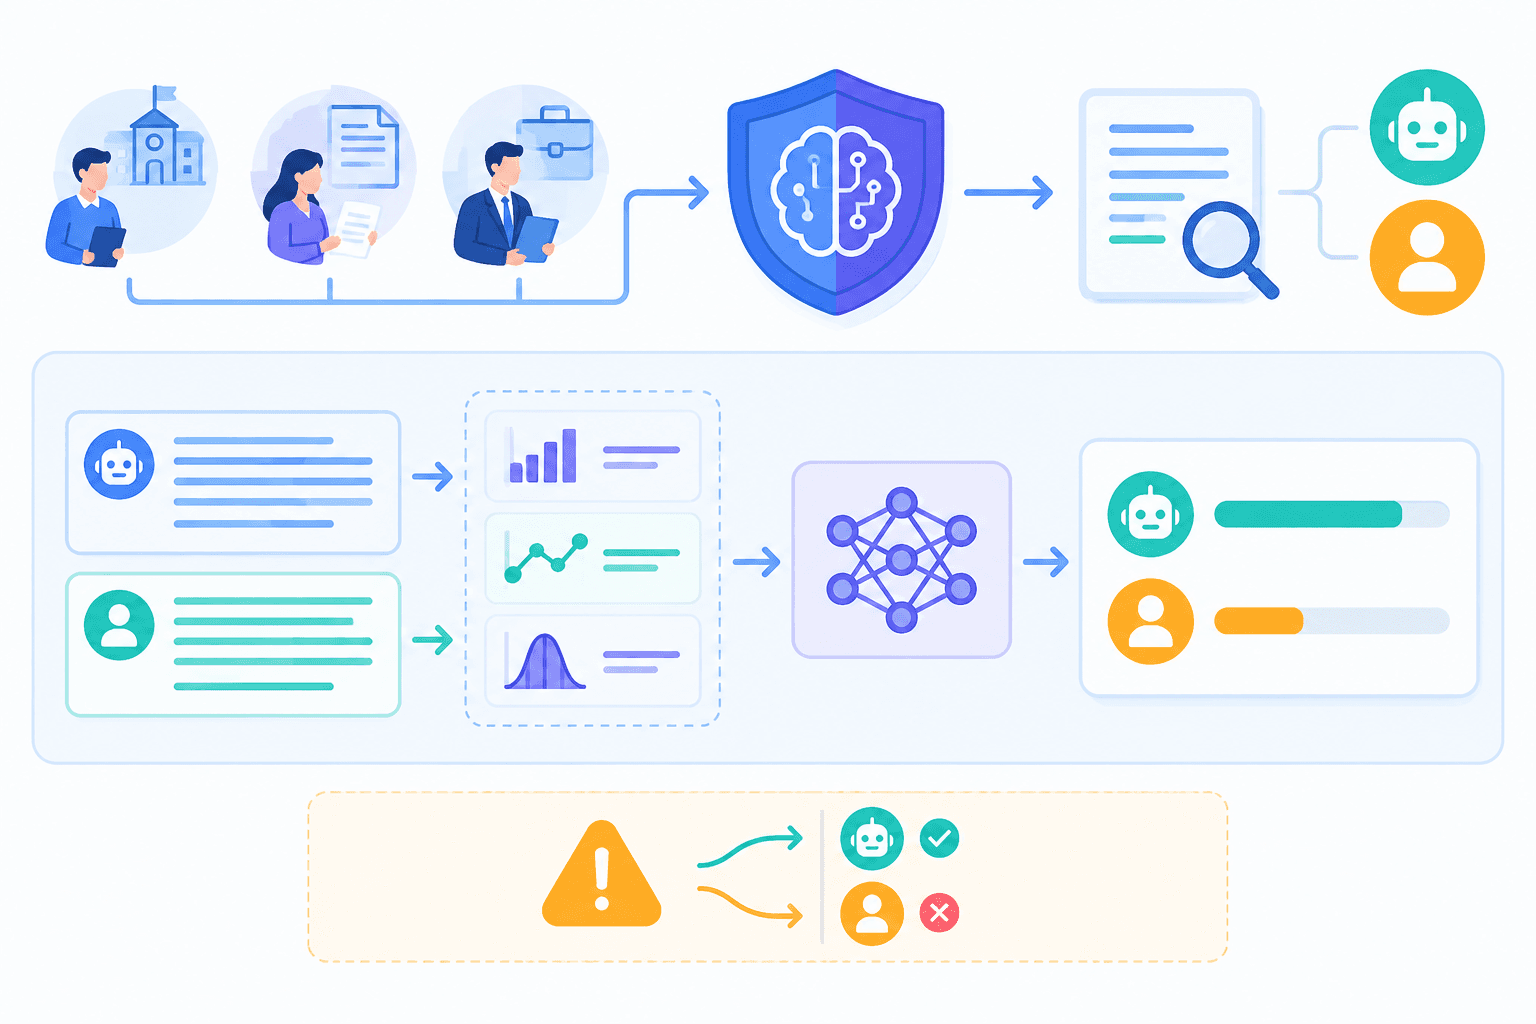
AI チェッカーとは、文章が AI によって生成されたかどうかを統計的な特徴などから推定するツールの総称で、判定には誤りが含まれるため単独の根拠にしない運用が前提になる。