QLoRA
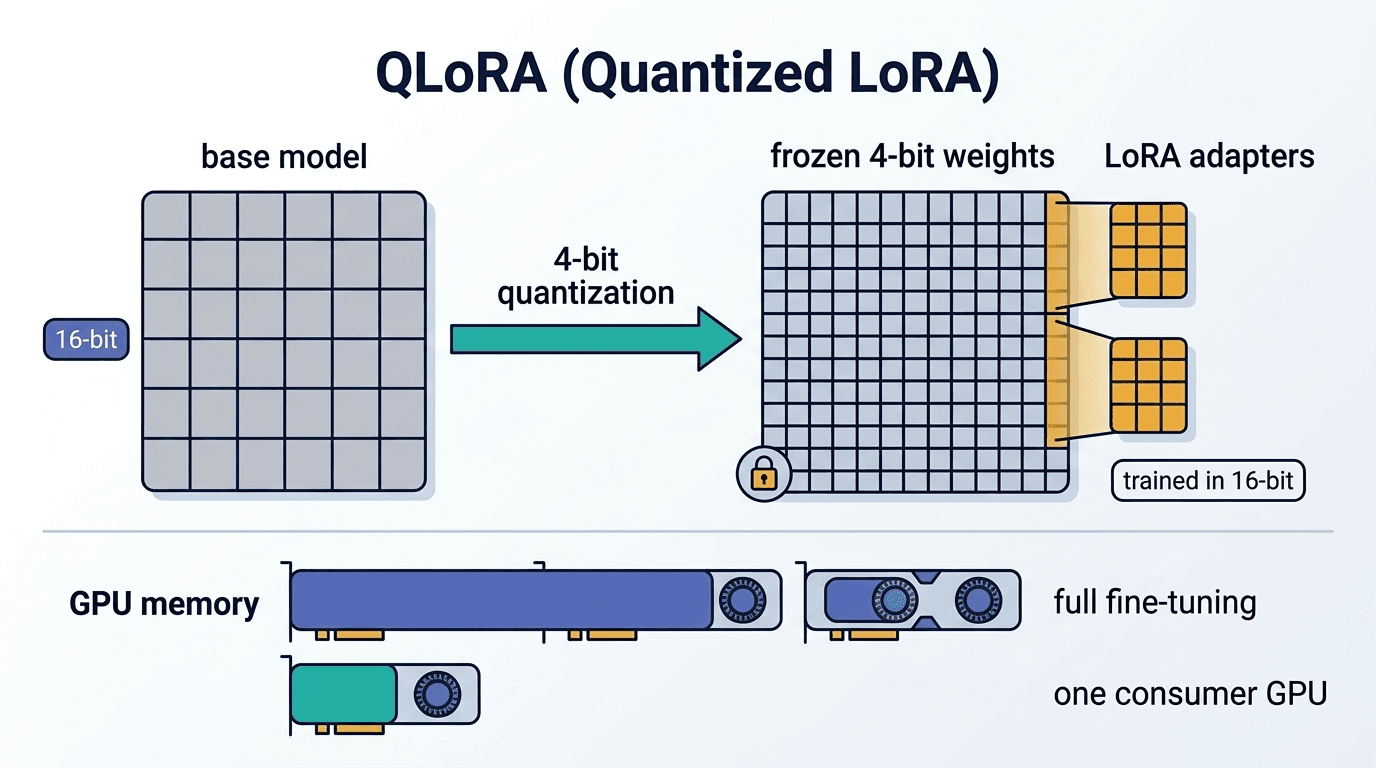
QLoRA(Quantized LoRA)とは、LoRA に 4bit 量子化を組み合わせることで、コンシューマ向け GPU でも大規模言語モデルのファインチューニングを可能にした手法である。
2023 年に発表された QLoRA は、「GPU が足りない」という現場の切実な声に対する直接的な回答だった。
核心はシンプルで、ベースモデルの重みを 4bit に量子化して GPU メモリの消費を劇的に減らし、その上で LoRA アダプタだけを 16bit で学習させる。つまり「読み込みは軽く、学習は精密に」という二段構えの設計になっている。
数字で言うと、65B パラメータのモデルをフル精度で載せるには A100 80GB が複数枚必要だが、QLoRA なら 1 枚に収まる。7B モデルに至っては RTX 3090(24GB)や RTX 4090 でも学習が回る。クラウドで GPU インスタンスを借りる費用も、フル FT の 1/10 以下に抑えられるケースが多い。
ただし注意点もある。4bit 量子化による精度劣化はゼロではない。筆者が試した限りでは、単純な分類タスクや要約タスクではフル精度 LoRA との差がほぼ出なかったが、数学的推論や長文の論理展開が求められるタスクでは 1〜3% 程度のスコア低下が見られた。「とりあえず QLoRA で試して、精度が足りなければフル精度 LoRA に切り替える」という順序が実務では合理的だと感じている。
この用語を扱う記事
- PEFT(パラメータ効率型ファインチューニング)とは?AI モデルカスタマイズのコストを 90% 削減する技術PEFT(Parameter-Efficient Fine-Tuning)の仕組みと主要手法(LoRA・QLoRA・Adapter)を意思決定者向けに解説。自社 GPU 環境での実践事例と投資判断のポイントも紹介。
- ファインチューニング入門 — B2B企業が独自LLMを作る前に知るべき基礎と判断基準ファインチューニングの仕組みを基礎から解説。PEFT/LoRA との関係、RAG との使い分け、コスト試算、B2B 企業が独自モデル開発を判断するためのチェックリストまでをまとめます。
- ローカル LLM / SLM 導入比較 — クラウド API に依存しない AI 活用GPT OSS・Phi-4・Llama 4 Scout 等のオープンウェイトモデルを GPU 要件・タスク別精度・TCO の 3 軸でクラウド API と比較。データ主権とコスト最適化を両立するローカル AI 導入ガイド。
- ファインチューニングとRAGの選び方:コスト・精度・用途で比較する実践ガイドファインチューニングとRAGはどちらを選ぶべきか。コスト・精度・更新頻度・セキュリティの4軸で比較し、業務ユースケース別に最適な選択基準を解説します。


関連用語
Jev(TypeSafe AI)
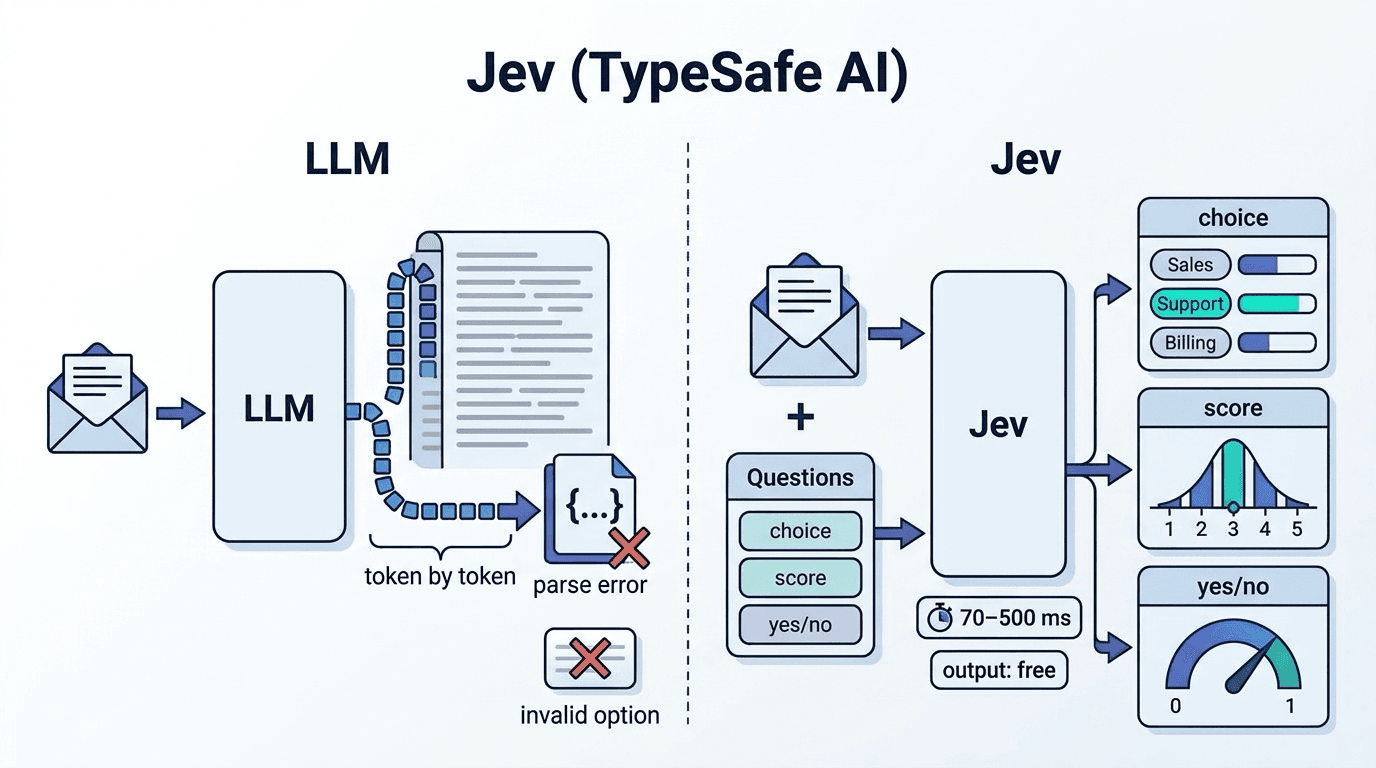
Jev とは、TypeSafe AI が開発した判断専用の AI モデルで、文章を生成せず、あらかじめ決めた選択・段階評価・真偽の判断を確率付きで返す「System One モデル」である。

PEFT
PEFT(Parameter-Efficient Fine-Tuning)とは、大規模言語モデルの全パラメータではなく一部のみを更新することで、少ない計算資源とデータでモデルを特定タスクに適応させるフ
RLHF
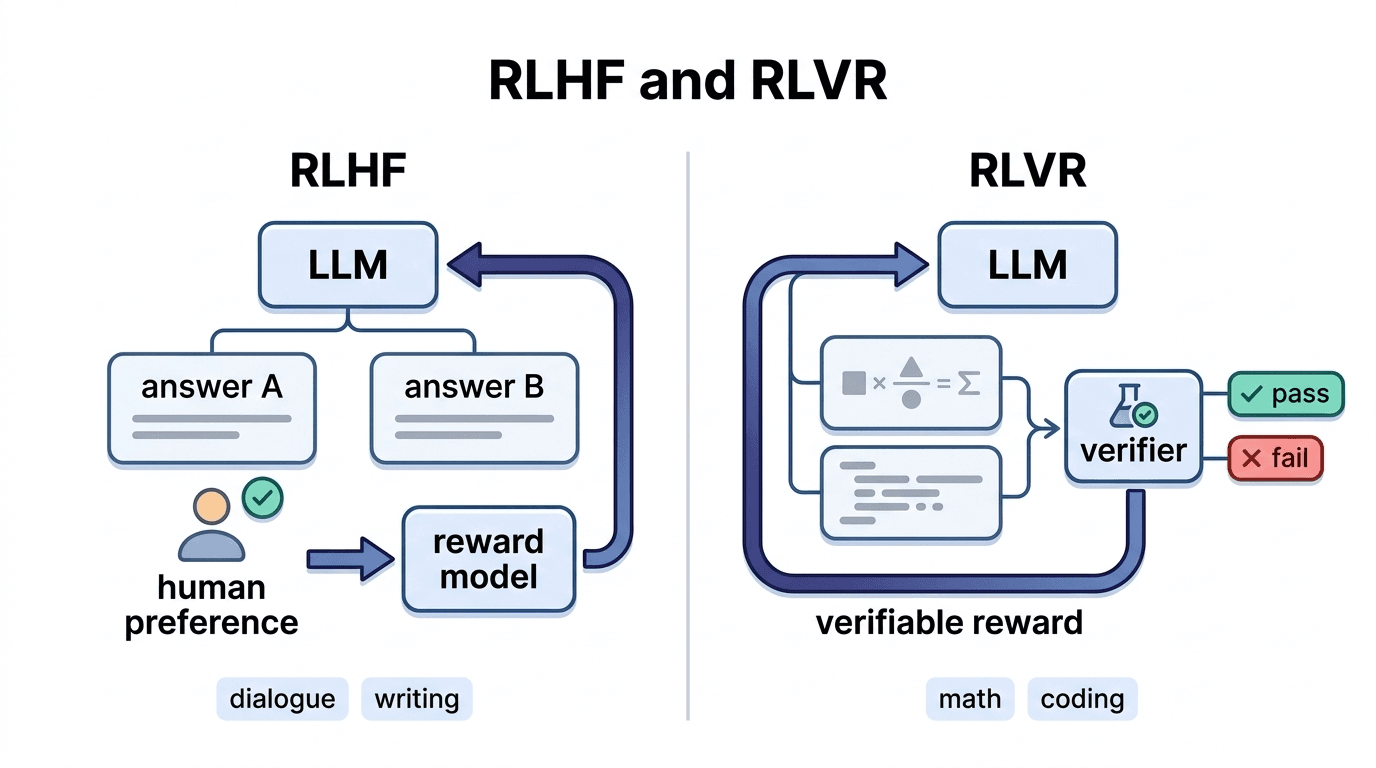
RLHFとは人間のフィードバックを報酬として使う強化学習手法、RLVRとは検証可能な正解を報酬として使う強化学習手法であり、いずれもLLMの出力を人間の期待に沿うよう調整するために用いられる。
AI チェッカー(AI 生成文章判定ツール)
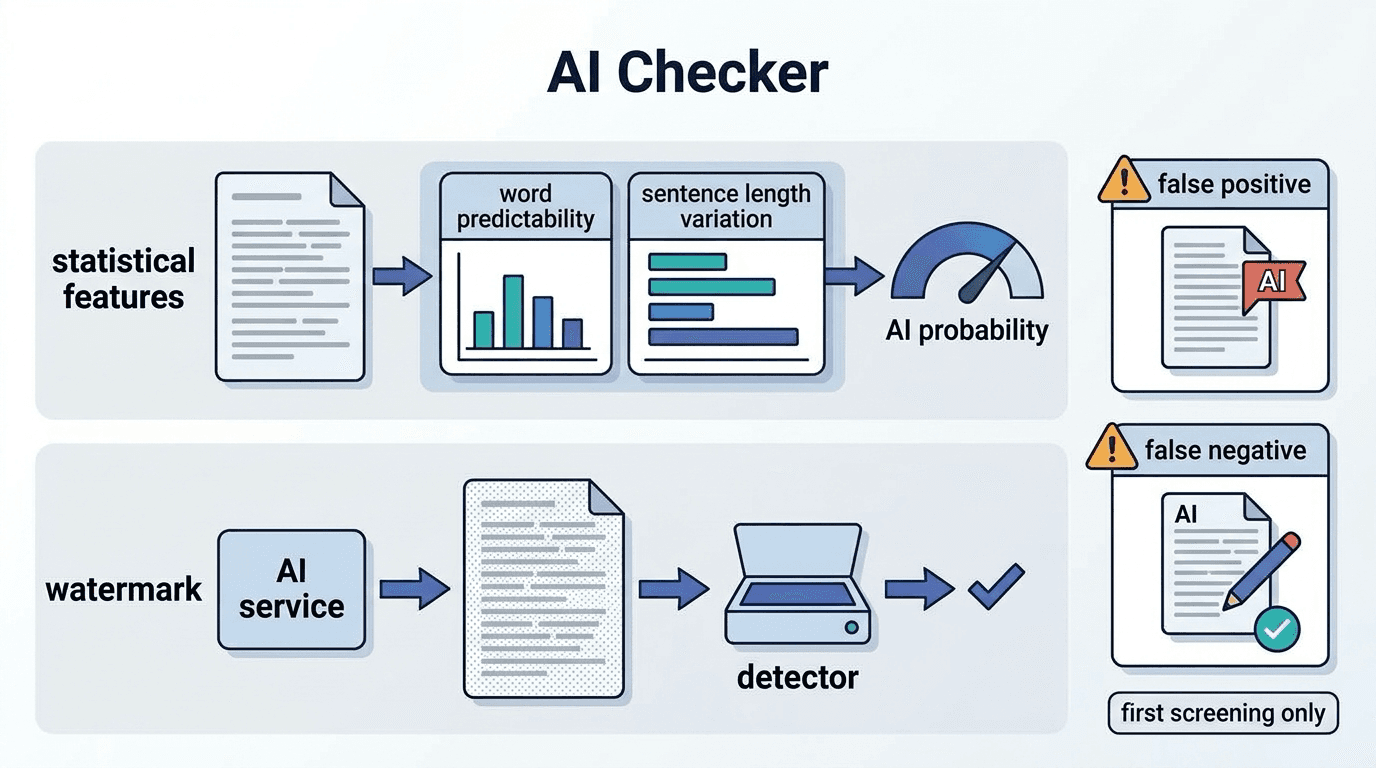
AI チェッカーとは、文章が AI によって生成されたかどうかを統計的な特徴などから推定するツールの総称で、判定には誤りが含まれるため単独の根拠にしない運用が前提になる。