AI基礎・モデル | AI・DX・セキュリティ用語集
「AI基礎・モデル」カテゴリの用語集。AI・DX・セキュリティに関する専門用語を、経営層・IT担当者向けに図解つきで解説します。
Grok(グロック)
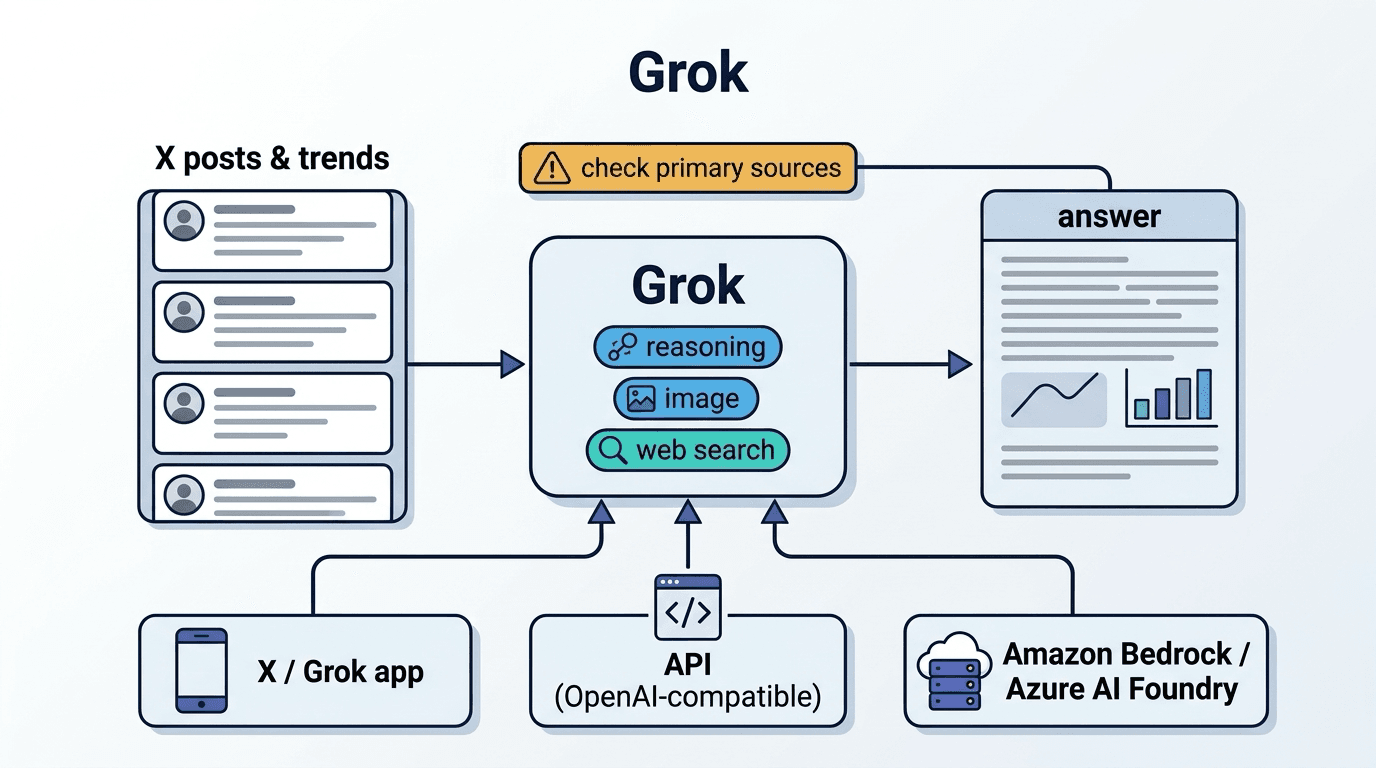
Grok とは、SpaceX 傘下の SpaceXAI(旧 xAI)が開発する大規模言語モデルと対話 AI サービスで、X の投稿を参照した回答ができる点が特徴である。

コンテキストウィンドウ(Context Window)
コンテキストウィンドウとは、LLMが一度に処理できるトークン数の上限のことで、入力プロンプトと出力を合わせた最大長を指す。長いドキュメントの処理やマルチターン会話の品質に直接影響する。

推論時スケーリング(Test-time Compute)
推論時スケーリングとは、モデルの推論フェーズで使う計算量を動的に増減させることで、難しい問題にはより多くの「思考ステップ」を費やし、簡単な問題には即答する手法である。

推論モデル(Reasoning Model)
回答前に明示的な思考連鎖を生成し、複雑な問題を段階的に解く大規模言語モデルの一種。
Sparse Model(スパースモデル)
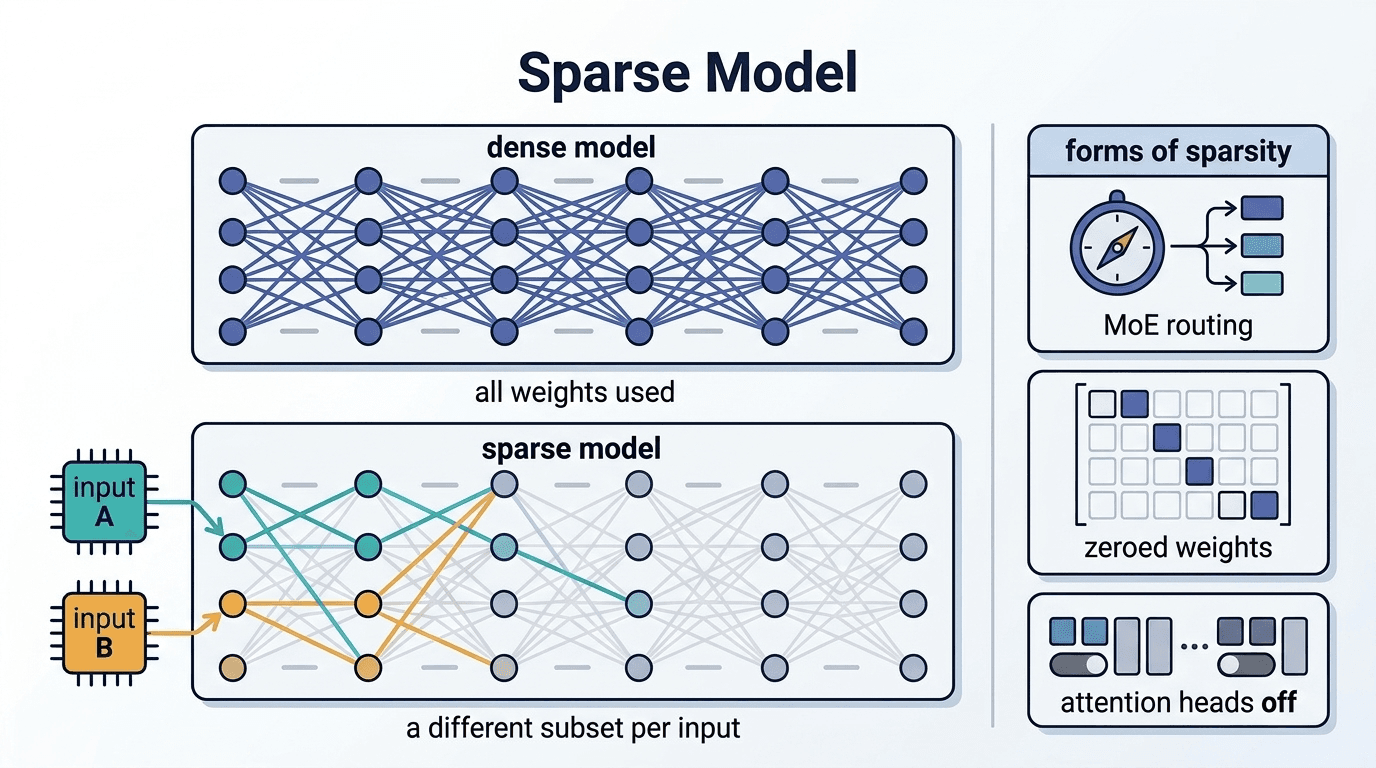
Sparse Model(スパースモデル)とは、推論時にモデルの全パラメータではなく一部のみを活性化させるニューラルネットワークアーキテクチャの総称である。代表例として MoE(Mixture of
Sora(OpenAI)
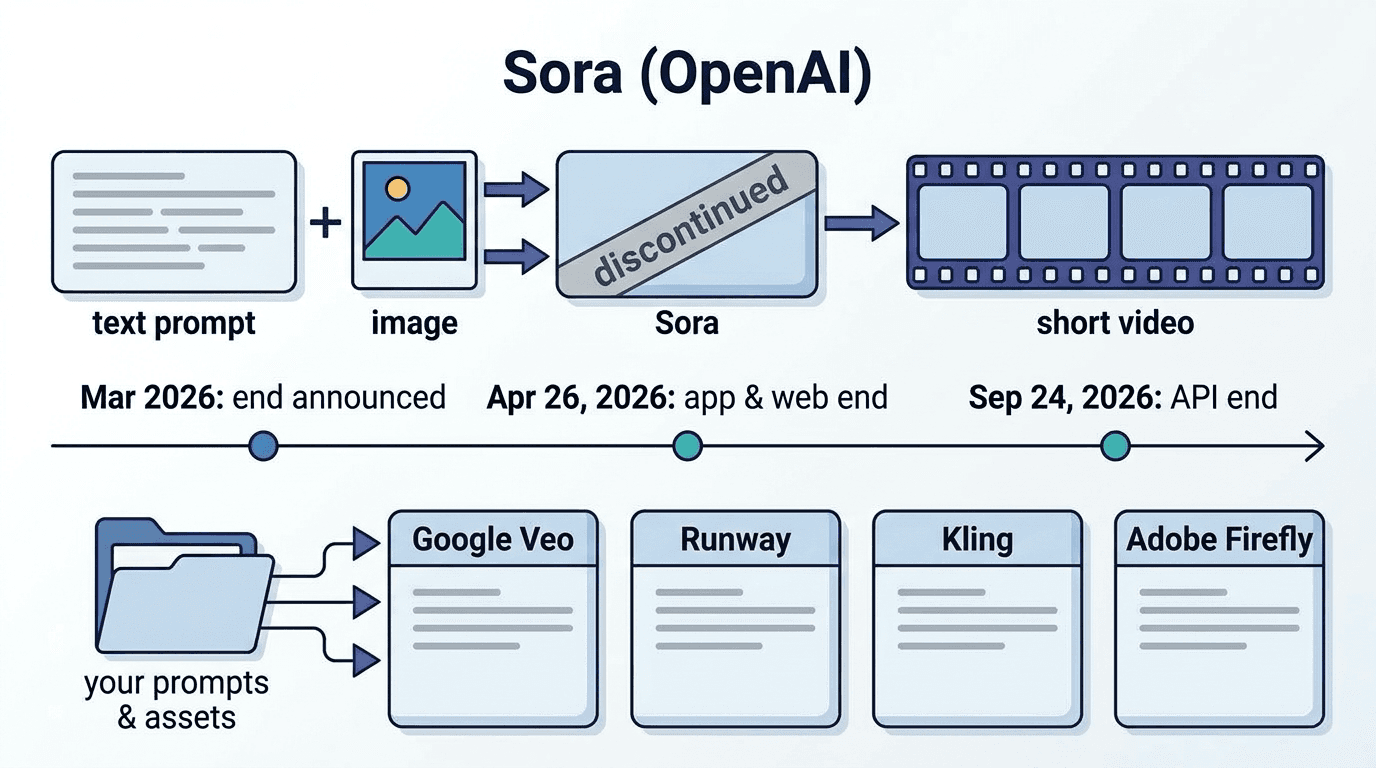
Sora とは、OpenAI が提供していたテキストや画像から動画を生成する AI である。アプリと Web は 2026 年 4 月に、API は 2026 年 9 月に提供を終了した。
TurboQuant
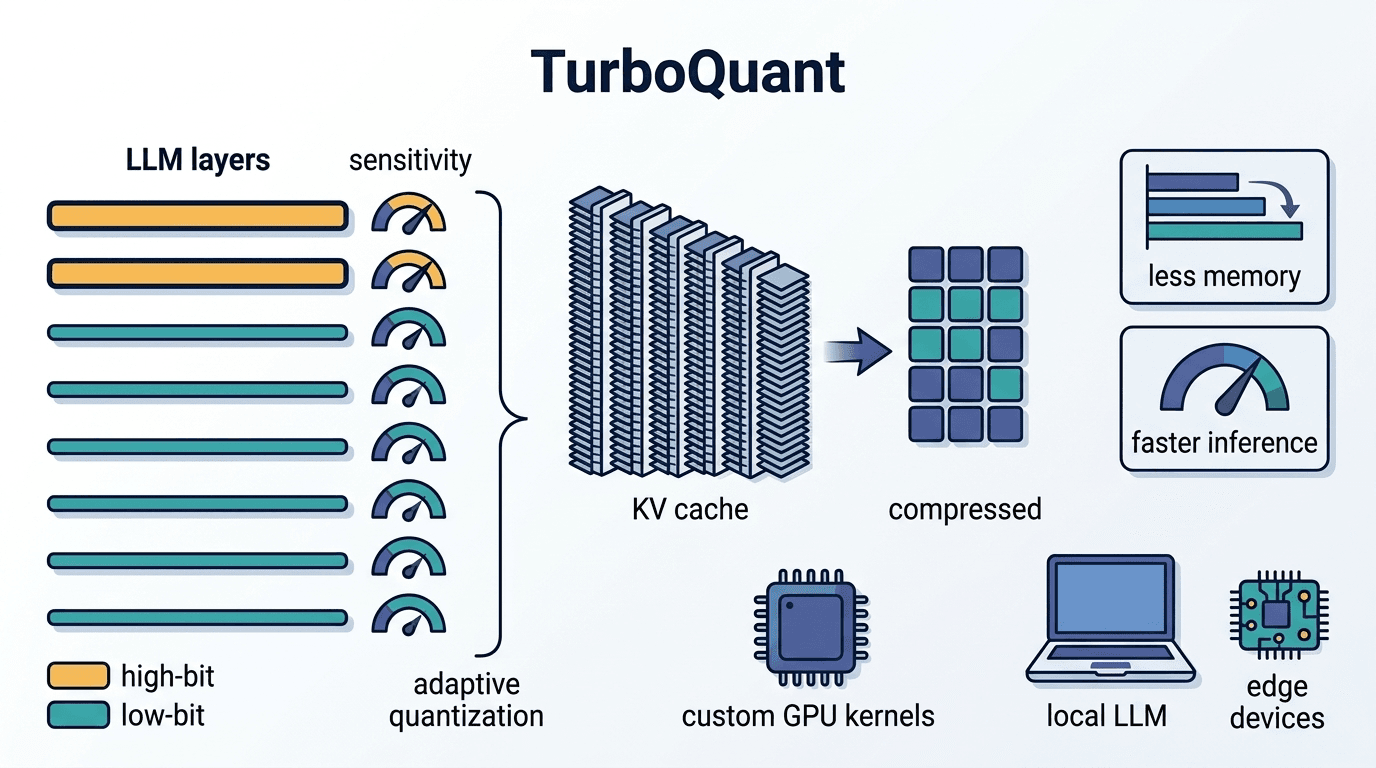
Google が開発した LLM 向けメモリ圧縮技術。量子化によりメモリ消費量を最大 1/6 に削減し、推論速度を最大 8 倍に高速化する。

知識蒸留(Knowledge Distillation)
大規模な教師モデルの知識を小規模な生徒モデルに転移させ、軽量かつ高精度なモデルを作成する手法。
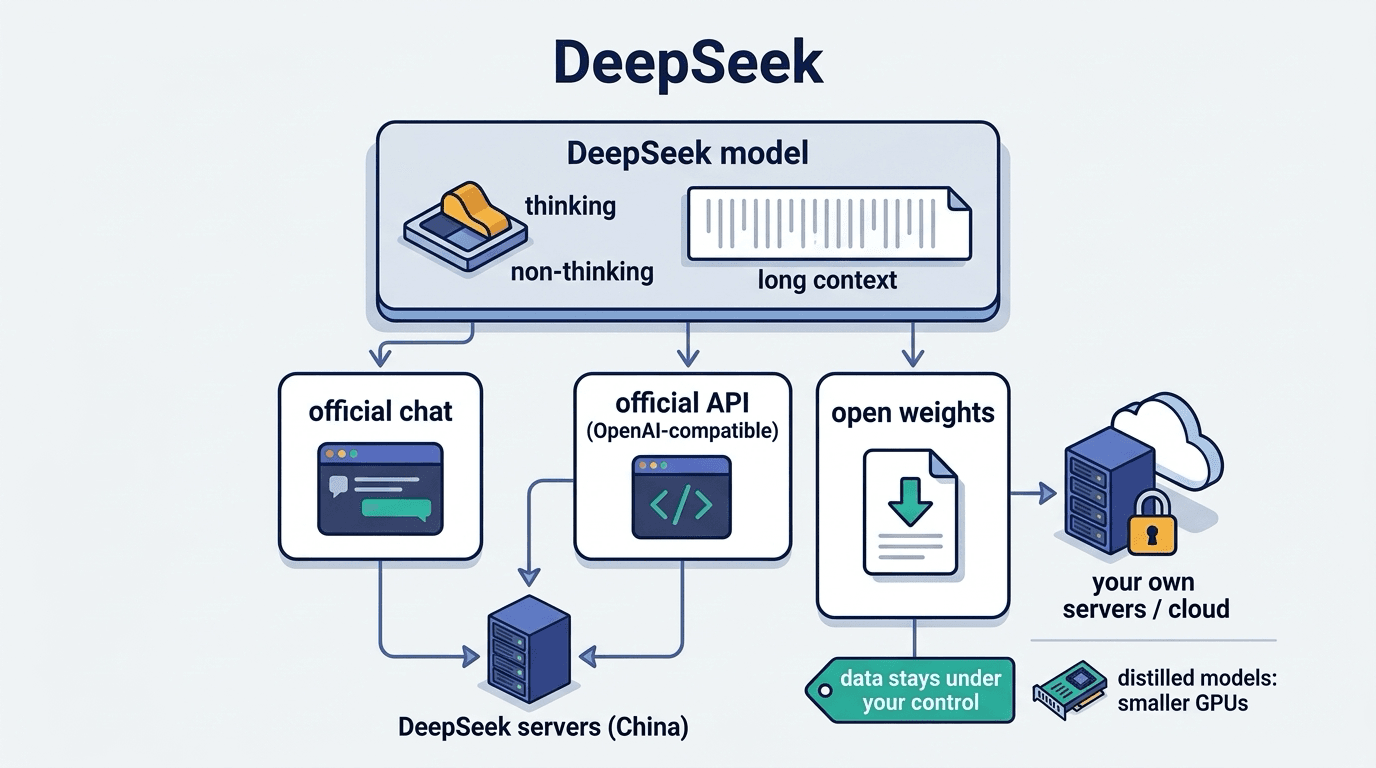
DeepSeek(ディープシーク)
DeepSeek とは、中国の DeepSeek 社が開発する大規模言語モデルとチャットサービスで、重みを公開するオープンウェイト方式と低い推論単価が特徴である。

Dense Model(密結合モデル)
Dense Model(密結合モデル)とは、推論時にモデルの全パラメータを使って計算を行うニューラルネットワークアーキテクチャのことである。MoE(Mixture of Experts)がエキスパート
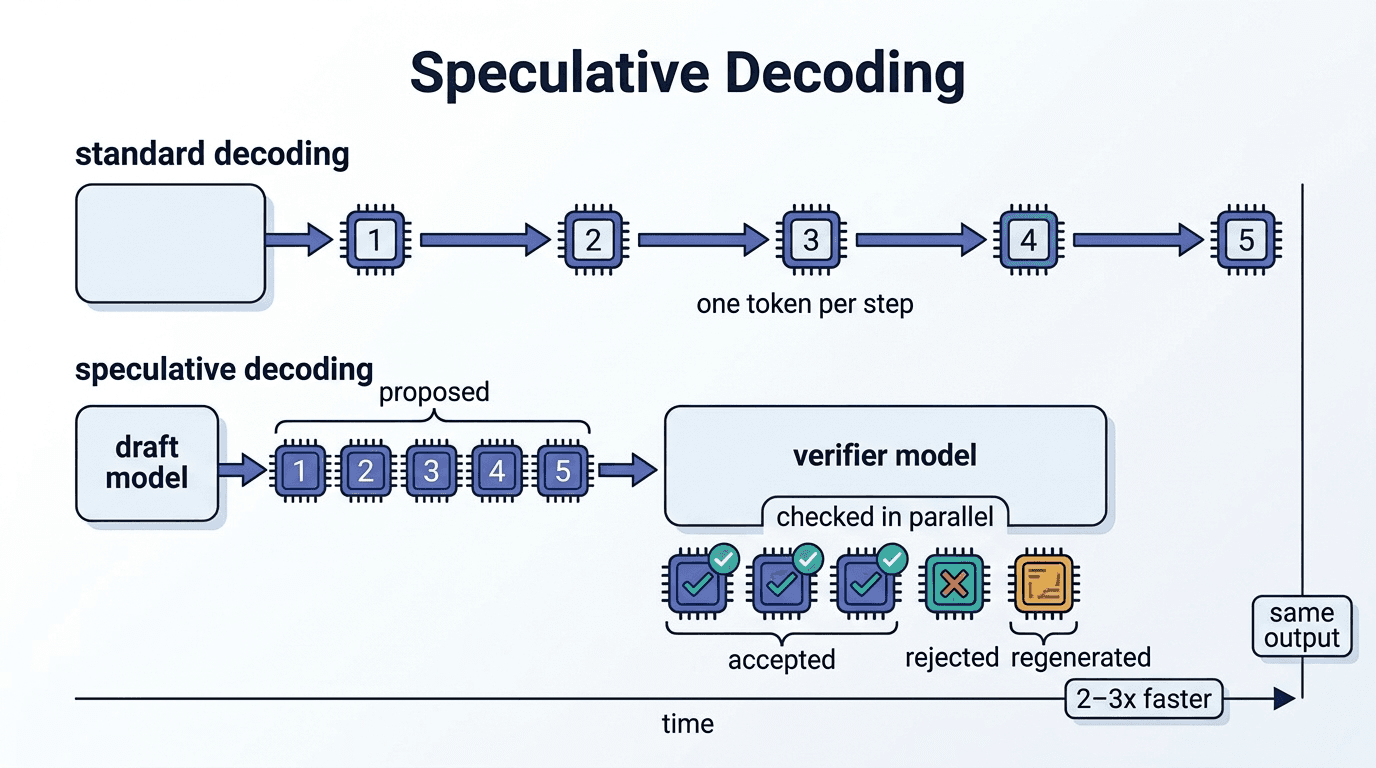
投機的デコーディング(Speculative Decoding)
小型のドラフトモデルが複数トークンを先行提案し、大型モデルが並列検証する推論高速化技術。
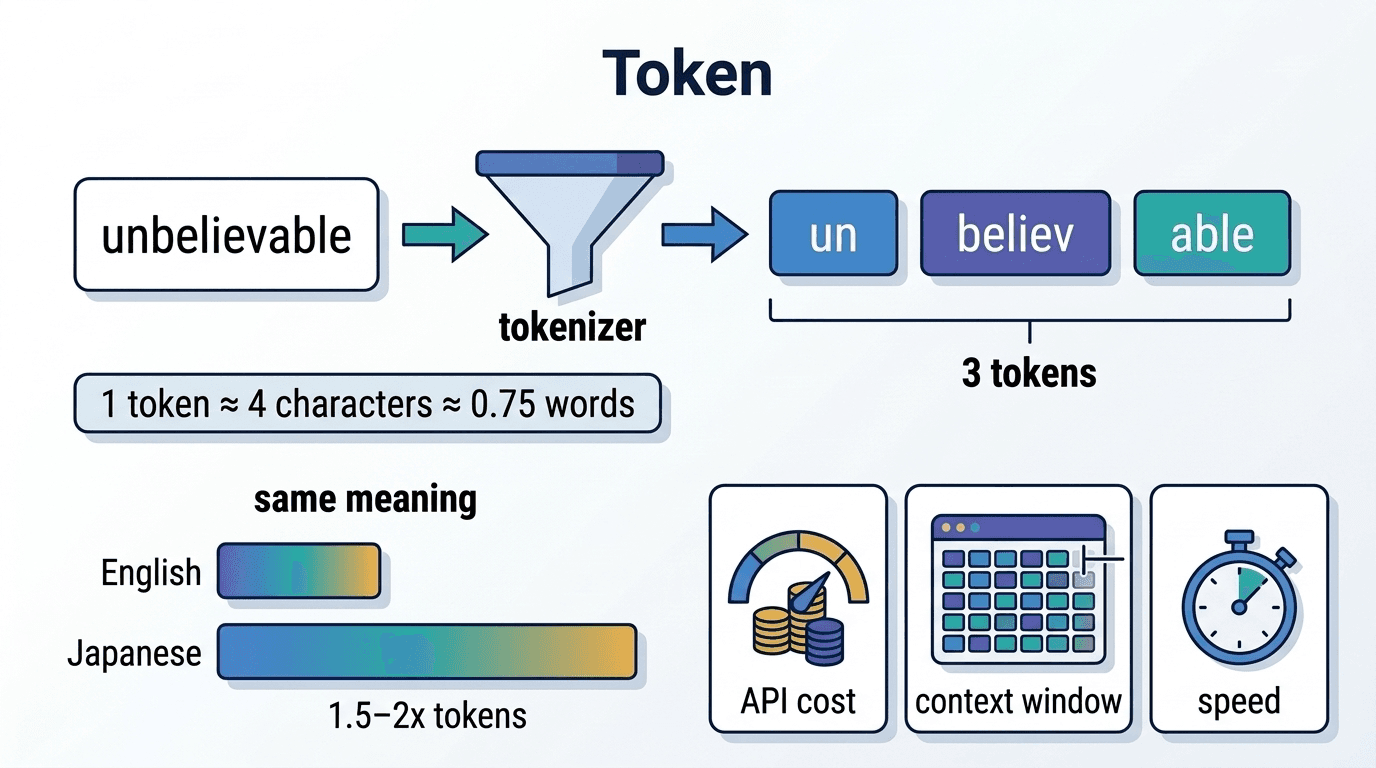
トークン(Token)
トークン(Token)とは、LLM がテキストを処理する際の最小単位である。単語そのものではなく、単語の一部や記号、空白なども含まれ、モデルの語彙(ボキャブラリー)に基づいてテキストを分割した結果の断
33件 / 2/3