ทดสอบ AI Pentest ด้วย ARTEX: ผลลัพธ์และข้อจำกัดที่พบใน Juice Shop

AI เพนเทสต์ (AI Pentest) คือกลไกที่ AI จะคิดขั้นตอนการตรวจสอบ ส่งคำขอผ่านเครื่องมือ และตรวจสอบจุดอ่อนของเว็บแอปพลิเคชันโดยอ้างอิงจากผลลัพธ์ที่ตอบกลับมา ในบริษัทของเรา เราได้ติดตั้ง ARTEX รุ่นที่ 1 ไว้ในเครื่อง (Local) และดำเนินการตรวจสอบโดยใช้แอปพลิเคชันสำหรับการเรียนรู้ด้านความปลอดภัยที่ชื่อว่า "OWASP Juice Shop"
โจทย์ของ OWASP Juice Shop จะแสดงระดับความยากด้วยจำนวนดาว โดยมีทั้งหมด 6 ระดับ ตั้งแต่ ★1 ซึ่งง่ายที่สุด ไปจนถึง ★6 ซึ่งยากที่สุด ในการตรวจสอบครั้งนี้ แม้ว่าจะสามารถแก้โจทย์ระดับความยาก ★1 ถึง ★3 ได้อย่างราบรื่น แต่สำหรับโจทย์ที่ยากขึ้น การตั้งเป้าหมายของงานส่งผลต่อความคืบหน้าอย่างมาก ในการดำเนินการที่กำหนดเป้าหมายไว้อย่างชัดเจน เราได้รับผลลัพธ์ที่ประสบความสำเร็จในโจทย์ที่เกี่ยวข้องกับ NoSQL ภายในเวลาประมาณ 10-15 นาที และในโจทย์ระดับความยากสูงสุด ★6 อย่าง "Multiple Likes" ภายในเวลาประมาณ 40 นาที
ในบทความนี้ เราจะแนะนำผลลัพธ์แยกตามโจทย์และวิธีการปรับแต่งการตั้งเป้าหมาย พร้อมทั้งสรุปบทเรียนด้านการออกแบบที่ได้รับจากการจัดการข้อมูลอินพุตและปัญหาการอัปเดตพร้อมกัน เราจะแยกแยะระหว่างตัวอย่างจริงที่สามารถรับมือกับโจทย์ระดับสูงได้และขอบเขตที่ยังอยู่ระหว่างการตรวจสอบ เพื่อพิจารณาว่าควรประเมิน AI เพนเทสต์ในการทำงานจริงอย่างไร
สิ่งที่ตรวจสอบและเงื่อนไขในการตรวจสอบ

เราได้ติดตั้ง ARTEX รุ่นที่ 1 ในสภาพแวดล้อมแบบโลคัล และใช้ GLM-5.3 เป็นโมเดลสำหรับการอนุมาน (Inference) โดยเป้าหมายคือ Juice Shop ในสภาพแวดล้อมการทดสอบที่บริษัทของเราจัดเตรียมไว้ ทั้งนี้ การติดตั้งแบบโลคัลในที่นี้หมายถึงการจัดวาง ARTEX เท่านั้น ไม่ได้หมายถึงการอนุมาน LLM ในเครื่องแบบโลคัลแต่อย่างใด
งานที่มอบหมายให้ ARTEX และสิ่งที่มนุษย์ต้องตัดสินใจ
ARTEX คือแพลตฟอร์มสำหรับการทดสอบการเจาะระบบ (Penetration Testing) ที่ใช้เอเจนต์หลายตัวซึ่งขับเคลื่อนด้วย LLM มาช่วยแบ่งงานกันทำ โดยการทดสอบการเจาะระบบหมายถึงการตรวจสอบจุดอ่อนด้วยการจำลองการโจมตีเพื่อยืนยันผลกระทบที่อาจเกิดขึ้น จุดเด่นของระบบนี้ไม่ใช่แค่การที่ AI เสนอแนวทางแก้ไขเป็นข้อความเท่านั้น แต่ยังรวมถึงการใช้งานเครื่องมือจริงและการตรวจสอบผลลัพธ์ซ้ำๆ อีกด้วย
ในการทดสอบครั้งนี้ เราได้ให้เอเจนต์ดำเนินการสำรวจเป้าหมาย การส่งคำขอ (Request) โดยเปลี่ยนเงื่อนไขการป้อนข้อมูลและการส่ง รวมถึงการเปรียบเทียบผลลัพธ์ โดยมีมนุษย์คอยติดตามความคืบหน้าเพื่อกำหนดเป้าหมายของงานให้แคบลง และระบุฟังก์ชันหรือช่องโหว่ที่ต้องการตรวจสอบให้ชัดเจน นี่ไม่ใช่การทดสอบที่ AI แก้ไขปัญหาทั้งหมดได้เองโดยอัตโนมัติจากเป้าหมายกว้างๆ ในตอนแรก แต่เป็นกรณีตัวอย่างการใช้งานที่รวมถึงการกำหนดเป้าหมายโดยมนุษย์ด้วย
การระบุเป้าหมายการทดสอบ การเตรียมสภาพแวดล้อมในการรันงาน และการตัดสินใจว่าจะจัดการกับผลลัพธ์ที่ได้ว่าเป็นช่องโหว่หรือไม่นั้น เป็นขอบเขตความรับผิดชอบของมนุษย์ นอกจากนี้ การทดสอบครั้งนี้ยังเป็นการกำหนดค่าสำหรับการทดสอบที่ใช้ ARTEX เป็นฐาน ไม่ใช่การทดสอบเพื่อวัดประสิทธิภาพหรือความปลอดภัยของเวอร์ชันที่แจกจ่ายมาตรฐานเพียงอย่างเดียว ผลลัพธ์ที่ได้จึงถือเป็นผลลัพธ์ที่เกิดจากการผสมผสานระหว่างการกำหนดค่านี้ โมเดลนี้ และการตั้งเป้าหมายนี้เข้าด้วยกัน
อย่าสรุปผลจาก Juice Shop ไปใช้กับบริการจริงโดยทั่วไป
OWASP Juice Shop คือเว็บแอปพลิเคชันที่ถูกออกแบบมาให้มีช่องโหว่โดยเจตนา เพื่อใช้สำหรับการเรียนรู้เรื่องช่องโหว่และการทดสอบเครื่องมือด้านความปลอดภัย ถือเป็นสื่อการสอนที่เหมาะสมสำหรับการตรวจสอบการใช้งานที่มีปัญหา และเชื่อมโยงพฤติกรรมที่เกิดขึ้นเข้ากับสาเหตุของปัญหา
อย่างไรก็ตาม จำนวนโจทย์ที่แก้ไขได้ไม่สามารถนำมาคำนวณเป็นอัตราการตรวจพบช่องโหว่ในบริการจริงได้ เนื่องจากวิธีแก้โจทย์ต่างๆ มีเผยแพร่อยู่ทั่วไป และมีความเป็นไปได้ที่ AI จะใช้ความรู้ที่มีอยู่เดิมในการแก้ปัญหา ดังนั้นจึงจำเป็นต้องแยกการประเมินผลระหว่างความสามารถในการค้นหาช่องโหว่ที่ไม่รู้จัก กับความสามารถในการทำความเข้าใจข้อกำหนดทางธุรกิจที่ซับซ้อนออกจากกัน
นอกจากนี้ การที่สื่อการสอนสามารถเข้าถึงได้ทั่วไป ไม่ได้หมายความว่าเราสามารถทดสอบกับเป้าหมายใดก็ได้บนอินเทอร์เน็ต หากต้องการทดสอบ ควรใช้สภาพแวดล้อมที่เตรียมขึ้นเองหรือเป้าหมายที่ได้รับอนุญาตและกำหนดขอบเขตไว้อย่างชัดเจน ผลลัพธ์ที่กล่าวถึงในบทความนี้ก็เป็นผลลัพธ์ที่ได้จากสภาพแวดล้อมที่ตรงตามเงื่อนไขดังกล่าวเช่นกัน
สิ่งที่ได้เรียนรู้จากผลลัพธ์ในครั้งนี้

นอกเหนือจากโจทย์ระดับความยาก ★1 ถึง ★3 แล้ว เรายังประสบความสำเร็จในโจทย์ระดับสูงที่เกี่ยวข้องกับ NoSQL และโจทย์ระดับสูงสุด ★6 อย่าง Multiple Likes อีกด้วย สำหรับโจทย์ระดับสูงนั้น จุดเปลี่ยนสำคัญคือการจำกัดเป้าหมายของงานให้แคบลงเพื่อดำเนินการตรวจสอบ แทนที่จะปล่อยให้ค้นหาข้อมูลในวงกว้าง
ในส่วนของระดับความยาก ★1 ถึง ★3 โจทย์ในขอบเขตที่เราได้ดำเนินการไปนั้นประสบความสำเร็จเป็นอย่างดี อย่างไรก็ตาม นี่ไม่ได้หมายความว่าเราได้ทำโจทย์ครบทุกข้อในแต่ละระดับความยาก โดยผลลัพธ์ของโจทย์ระดับสูงจะแสดงไว้พร้อมกับระดับความยากตามคู่มือทางการฉบับปัจจุบันดังนี้
| โจทย์ | ระดับความยากตามคู่มือทางการ | ผลลัพธ์และระยะเวลาที่ใช้ในครั้งนี้ |
|---|---|---|
| NoSQL Exfiltration (การดึงข้อมูลคำสั่งซื้อ) | ★5 | สำเร็จ ใช้เวลาประมาณ 10-15 นาที โดยเน้นเป้าหมายที่ชัดเจน |
| NoSQL Manipulation (การแก้ไขรีวิวหลายรายการ) | ★4 | สำเร็จ ใช้เวลาประมาณ 10-15 นาที โดยเน้นเป้าหมายที่ชัดเจน |
| Multiple Likes (การกดไลก์ซ้ำ) | ★6 | สำเร็จ ใช้เวลาประมาณ 40 นาที |
| Successful RCE DoS (การปฏิเสธการให้บริการผ่านการรันโค้ด) | ★6 | ยังไม่เสร็จสิ้น อยู่ระหว่างการปรับสภาพแวดล้อม Docker |
จำนวนดาวอ้างอิงตามการระบุใน รายการโจทย์ NoSQL ทางการ, Multiple Likes และ รายการโจทย์ RCE DoS ทั้งนี้ จำเป็นต้องตรวจสอบเงื่อนไขการใช้งานโจทย์ตามเวอร์ชันและการตั้งค่าที่ใช้ในการทดสอบ โดยเฉพาะอย่างยิ่ง Successful RCE DoS ซึ่งคู่มือทางการระบุว่าไม่สามารถใช้งานได้ในสภาพแวดล้อม Docker ดังนั้นเราจึงยังไม่นับรวมการปรับสภาพแวดล้อมในปัจจุบันเข้าเป็นผลงานที่สำเร็จ
ระยะเวลาเหล่านี้เป็นเพียงการประมาณการจากการดำเนินการในครั้งนี้เท่านั้น ไม่ใช่ตัวเลขที่รับประกันว่าในสภาพแวดล้อมอื่นจะใช้เวลาเท่ากันหรือสามารถแก้โจทย์ทุกข้อในระดับความยากเดียวกันได้ หากต้องการเปรียบเทียบ จำเป็นต้องกำหนดจุดเริ่มต้นของการวัดผล การส่งต่อข้อมูลจากการตรวจสอบเบื้องต้น และการจัดการสภาพแวดล้อมให้เป็นมาตรฐานเดียวกัน
ทำไมจึงแยกข้อบกพร่องของรูปแบบอินพุตออกจากการทำ NoSQL Injection และการเจาะระบบยืนยันตัวตน

การที่สามารถส่งอาร์เรย์ (Array) หรือออบเจกต์ (Object) ไปยังช่องที่คาดหวังว่าเป็น "สตริง" (String) ได้นั้น ถือเป็นเหตุผลที่ควรกลับมาทบทวนการตรวจสอบข้อมูลขาเข้า (Input Validation) อย่างไรก็ตาม การตัดสินว่าคำสั่งฐานข้อมูลมีการเปลี่ยนแปลงไปหรือไม่ หรือมีการหลีกเลี่ยงเงื่อนไขการตรวจสอบสิทธิ์หรือไม่นั้น จะต้องพิจารณาจากหลักฐานที่แยกจากกันในแต่ละกรณี
การล็อกอินสำเร็จด้วยรหัสผ่านที่ถูกต้องไม่ใช่หลักฐานของการเจาะระบบยืนยันตัวตน
ในการตรวจสอบการเข้าสู่ระบบครั้งนี้ การใช้ข้อมูลยืนยันตัวตนที่ถูกต้องตามปกติจะทำได้สำเร็จ และการใช้ข้อมูลที่ไม่ถูกต้องจะล้มเหลว ในทางกลับกัน แม้จะส่งที่อยู่อีเมลในรูปแบบอาร์เรย์ที่มีสมาชิก 1 ตัว แต่หากใช้ควบคู่กับรหัสผ่านที่ถูกต้องก็สามารถเข้าสู่ระบบได้ สิ่งที่สรุปได้จากจุดนี้คือ อินพุตที่ควรจะเป็นสตริงนั้นไม่ได้ถูกปฏิเสธเมื่อเป็นอาร์เรย์ ซึ่งไม่ได้หมายความว่าผู้ใช้ที่ไม่ทราบรหัสผ่านจะสามารถเข้าสู่ระบบได้
ใน JavaScript การแปลงเป็นสตริงอาจทำให้ผลลัพธ์ของอาร์เรย์ที่มีสมาชิก 1 ตัวกลายเป็นสตริงเดียวกับสมาชิกนั้น ตัวอย่างเช่น ผลลัพธ์ของ String(["user@example.test"]) คือ "user@example.test" หากอินพุตถูกแปลงเป็นสตริงในระหว่างกระบวนการ ก็ไม่ใช่เรื่องแปลกที่ผลลัพธ์การตรวจสอบจะตรงกับที่อยู่อีเมลปกติ
เราไม่สามารถสรุปได้เพียงแค่พฤติกรรมนี้ว่า ORM ได้แปลงอาร์เรย์เป็นตัวดำเนินการ IN, มีการตีความตัวดำเนินการของ NoSQL หรือมีการเจาะระบบยืนยันตัวตนของผู้ดูแลระบบ หากจะอ้างว่ามีการเจาะระบบยืนยันตัวตน จำเป็นต้องยืนยันให้ได้ว่ามีการเข้าถึงฟังก์ชันหรือข้อมูลที่ได้รับการป้องกันด้วยอินพุตที่ไม่ผ่านเงื่อนไขการยืนยันตัวตน การไม่สับสนระหว่างความบกพร่องของรูปแบบอินพุตกับการละเมิดสิทธิ์การเข้าถึง คือจุดตรวจสอบแรกในการอ่านรายงานฉบับนี้
การเกิด 500 Error เพียงอย่างเดียวไม่สามารถระบุได้ว่าเกิด Injection
การที่ได้รับข้อผิดพลาด 500 สำหรับอินพุตในรูปแบบออบเจกต์นั้น เป็นผลลัพธ์ที่ควรตีความอย่างระมัดระวัง ตัวอย่างเช่น หากเรียกใช้เมธอดสำหรับสตริงกับค่าที่ไม่ใช่สตริงจะทำให้เกิดข้อยกเว้น (Exception) หากการประมวลผลล้มเหลวก่อนที่จะไปถึงฐานข้อมูล นั่นไม่ใช่หลักฐานว่าความหมายของคิวรี (Query) ได้เปลี่ยนไป
ในความเป็นจริง ในซอร์สโค้ดสาธารณะของ Juice Shop ทั้ง กระบวนการล็อกอิน และ กระบวนการค้นหาสินค้า ต่างก็ใช้ SQL ในฝั่งของการค้นหายังมีกระบวนการที่จัดการคำค้นหาในฐานะสตริงอีกด้วย ดังนั้น การจัดประเภทผลลัพธ์ว่าเป็น NoSQL Injection เพียงเพราะส่งอินพุตในรูปแบบที่มักใช้กับ NoSQL จึงถือว่าไม่เหมาะสม
ในทางกลับกัน "NoSQL Exfiltration" ที่ประสบความสำเร็จในครั้งนี้ เป็นโจทย์อย่างเป็นทางการที่เกี่ยวข้องกับการดึงข้อมูลคำสั่งซื้อซึ่งรวมถึงข้อมูลของผู้ใช้รายอื่น ส่วน "NoSQL Manipulation" เกี่ยวข้องกับการอัปเดตบทวิจารณ์สินค้าหลายรายการพร้อมกัน เราจะแยกการจัดการผลลัพธ์เหล่านี้ออกจากกันกับการตรวจสอบประเภทอินพุตในการล็อกอินหรือการค้นหา การที่ประสบความสำเร็จในกรณีแรกไม่ได้หมายความว่าข้อผิดพลาด 500 ในกรณีหลังจะเป็นความสำเร็จของการทำ NoSQL Injection เช่นกัน
แม้ซอร์สโค้ดสาธารณะจะเป็นข้อมูลอ้างอิงที่ดีในการทำความเข้าใจกระบวนการทำงาน แต่ก็ไม่สามารถใช้แทนการระบุเวอร์ชันและการตั้งค่าของสภาพแวดล้อมที่ใช้ทดสอบได้ เมื่อต้องการยืนยันสาเหตุที่แน่ชัด ให้ตรวจสอบโดยการเปรียบเทียบการใช้งานจริงของสภาพแวดล้อมเป้าหมายเข้ากับบันทึกการสื่อสาร (Communication Log)
แยกการแก้ไขการตรวจสอบประเภทข้อมูล การสร้างคิวรีที่ปลอดภัย และการจัดการข้อผิดพลาดออกจากกัน
จุดเริ่มต้นของการรับมือคือการกำหนดประเภทของข้อมูลขาเข้าที่ยอมรับได้ที่ฝั่งเซิร์ฟเวอร์ หากต้องการข้อมูลประเภทสตริงสำหรับอีเมล รหัสผ่าน หรือคำค้นหา ให้ปฏิเสธข้อมูลประเภทอาร์เรย์ ออบเจกต์ หรือ null ก่อนที่จะส่งต่อไปยังกระบวนการทำงานทางธุรกิจ นอกจากประเภทข้อมูลแล้ว ควรระบุความยาว เงื่อนไขที่จำเป็น และรูปแบบที่อนุญาตสำหรับแต่ละรายการด้วย แม้ว่าจะมีการจำกัดไว้ที่ช่องป้อนข้อมูลบนหน้าจอแล้ว แต่ก็ไม่สามารถรับมือกับการส่งข้อมูลโดยตรงไปยัง API ได้
อย่างไรก็ตาม การจำกัดให้เป็นสตริงเพียงอย่างเดียวไม่ได้หมายความว่าการรับมือกับ SQL Injection จะเสร็จสิ้น การสร้างคิวรีควรใช้วิธีการส่งผ่านเป็นพารามิเตอร์แทนการฝังค่าด้วยการเชื่อมสตริง สำหรับ NoSQL ก็เช่นกัน อย่าใช้ออบเจกต์ที่ผู้ใช้ส่งมาเป็นเงื่อนไขการค้นหาโดยตรง แต่ให้ใช้เฉพาะรายการและตัวดำเนินการที่แอปพลิเคชันอนุญาตเท่านั้น แนวทางการตรวจสอบข้อมูลขาเข้าของ OWASP ก็ได้แยกแยะความแตกต่างระหว่างการตรวจสอบข้อมูลขาเข้ากับการป้องกันที่จำเป็นในจุดที่นำไปใช้งาน เช่น คิวรี
การจัดการข้อผิดพลาดก็เป็นหัวข้อที่ต้องแก้ไขแยกต่างหากเช่นกัน ข้อมูลขาเข้าที่มีประเภทไม่ถูกต้องควรส่งกลับเป็นข้อผิดพลาดที่มีการจัดการ โดยต้องไม่รวมรายละเอียดของข้อยกเว้นหรือเส้นทางภายในไว้ในคำตอบ ไม่ใช่เพียงแค่เปลี่ยนจาก 500 เป็น 400 เท่านั้น แต่ต้องตรวจสอบให้แน่ใจทั้งในเรื่องที่ว่ากระบวนการภายในจะไม่ทำงานหากได้รับข้อมูลที่ไม่ถูกต้อง และรายละเอียดจะไม่ถูกเปิดเผยแม้จะเกิดข้อยกเว้นที่ไม่คาดคิดก็ตาม
เหตุผลที่ข้อจำกัด "1 คน 1 ครั้ง" ถูกละเมิดเมื่อมีการร้องขอพร้อมกัน

ด้วย Multiple Likes ระดับ ★6 เราสามารถทะลุขีดจำกัด "หนึ่งคนหนึ่งครั้ง" ได้ภายในเวลาประมาณ 40 นาที แม้จะเป็นการดำเนินการแบบเดียวกัน แต่ความแตกต่างระหว่างการถูกปฏิเสธเมื่อส่งตามลำดับ กับการได้รับการยอมรับซ้ำกันเมื่อส่งพร้อมกัน ได้กลายเป็นเบาะแสสำคัญในการพิจารณาสาเหตุของปัญหานี้
นอกเหนือจากรหัสตอบกลับแล้ว ต้องเปรียบเทียบสถานะที่บันทึกไว้ด้วย
ในการตรวจสอบครั้งนี้ เมื่อกด "ถูกใจ" สองครั้งติดต่อกัน ครั้งแรกได้ผลลัพธ์เป็น HTTP 200 และครั้งที่สองเป็น HTTP 403 ส่วนกรณีที่ส่งคำขอพร้อมกัน 20 ครั้งไปยังรีวิวที่กด "ถูกใจ" ไปแล้วนั้น ทั้งหมดถูกปฏิเสธ ซึ่งแสดงให้เห็นว่ามีการตรวจสอบเพื่อป้องกันข้อมูลซ้ำอยู่จริง
อย่างไรก็ตาม เมื่อส่งคำขอพร้อมกัน 30 ครั้งไปยังรีวิวที่ยังไม่ได้กด "ถูกใจ" คำขอทั้งหมดกลับสำเร็จ และจำนวนการกด "ถูกใจ" เพิ่มขึ้นจาก 0 เป็น 30 จากบันทึกการตรวจสอบพบว่า ในอาร์เรย์ของผู้ใช้ที่กด "ถูกใจ" แล้ว มีข้อมูลของผู้ใช้คนเดียวกันซ้ำกันอยู่
ในกรณีนี้ สิ่งสำคัญคืออย่าเพิ่งด่วนสรุปเพียงเพราะได้รับ HTTP 200 กลับมา 30 ครั้ง เพราะ API สามารถออกแบบให้รับคำขอที่ซ้ำกันได้ แต่จำกัดผลลัพธ์การบันทึกให้เหลือเพียงครั้งเดียว แต่ในกรณีนี้ จำนวนครั้งที่เพิ่มขึ้นแม้ในสถานะการบันทึก แสดงให้เห็นว่าไม่ใช่แค่ความแตกต่างของการตอบกลับ แต่เป็นข้อจำกัดทางธุรกิจที่ว่า "1 คนต่อ 1 ครั้ง" ได้ถูกละเมิดไปแล้ว การพิจารณาทั้งผลลัพธ์ของ Response และผลลัพธ์ของการบันทึกข้อมูล จะช่วยให้เราแยกแยะปัญหาออกจากการแสดงผลหรือปัญหาด้านการสื่อสารทั่วไปได้
หากการตรวจสอบและการอัปเดตแยกจากกัน หลายกระบวนการอาจผ่านการตัดสินใจเดียวกันได้
กลไกนี้คล้ายกับสถานการณ์ที่บัตรคิวใบสุดท้ายถูกแจกออกไปโดยหลายเคาน์เตอร์พร้อมกัน หากแต่ละเคาน์เตอร์บันทึกการแจกหลังจากตรวจสอบแล้วว่า "ยังมีบัตรเหลืออยู่" ในขั้นตอนการตรวจสอบ ทุกคนก็จะสามารถผ่านไปได้
ซอร์สโค้ดการประมวลผลการกดถูกใจ ของ Juice Shop ก็มีการแยกขั้นตอนการตรวจสอบว่ากดถูกใจไปแล้วหรือยัง การเพิ่มจำนวน และการบันทึกข้อมูลผู้ใช้ ยิ่งไปกว่านั้น ในฐานะโจทย์สำหรับการเรียนรู้เรื่องภาวะการแข่งขัน (Race Condition) จึงมีการแทรกการหน่วงเวลาไว้โดยเจตนา ซึ่งโครงสร้างนี้สามารถอธิบายความแตกต่างระหว่างการประมวลผลตามลำดับกับการประมวลผลพร้อมกันได้
ปัญหาที่สถานะซึ่งตรวจสอบไว้ไม่คงอยู่จนถึงขั้นตอนการอัปเดต เรียกว่า TOCTOU (Time-of-Check to Time-of-Use) อย่างไรก็ตาม จากผลลัพธ์ 30 รายการในครั้งนี้ ไม่สามารถสรุปได้ว่า "ทุกกระบวนการอ่านอาร์เรย์ที่ว่างเปล่าในเสี้ยววินาทีเดียวกัน" จำเป็นต้องมีการบันทึกเพิ่มเติมเพื่อระบุลำดับการทำงานระหว่างนั้น นอกจากนี้ การที่สื่อการสอนถูกออกแบบมาให้เกิดภาวะการแข่งขันได้ง่าย ก็เป็นจุดที่ต้องนำมาพิจารณาเมื่อประเมินความสามารถของ AI ด้วยเช่นกัน
รับประกันเงื่อนไข "เพียงครั้งเดียว" ที่ฝั่งฐานข้อมูล
ในการแก้ไข เราจะรวมการตรวจสอบความซ้ำซ้อนและการบันทึกการกด "ถูกใจ" ให้เป็นกระบวนการที่ไม่ขัดแย้งกันแม้จะมีการทำงานพร้อมกัน วิธีการนำไปใช้งานจะแตกต่างกันไปตามฐานข้อมูลและโมเดลข้อมูลที่ใช้
ตัวอย่างเช่น หากออกแบบโดยบันทึกการกด "ถูกใจ" 1 ครั้งเป็นเรกคอร์ดแยกต่างหาก ให้กำหนด "Unique Constraint" (ข้อจำกัดความเป็นเอกลักษณ์) ให้กับคู่ของ "Review ID และ User ID" เพื่อให้ฐานข้อมูลปฏิเสธการบันทึกหากมีการเพิ่มคู่ข้อมูลเดียวกันเข้ามาพร้อมกัน หากมีการเก็บจำนวนยอดรวมแยกไว้ต่างหาก ก็ควรจัดการด้วย Transaction เพื่อให้การเพิ่มบันทึกและการอัปเดตจำนวนยอดรวมมีความสอดคล้องกัน
สำหรับการออกแบบที่บันทึกไว้ในเอกสารเดียว (Single Document) อาจใช้วิธีรวมการตรวจสอบเงื่อนไขและการเพิ่มข้อมูลไว้ในการอัปเดตแบบอะตอม (Atomic Update) เพียงครั้งเดียว อย่างไรก็ตาม ไม่สามารถนำ ข้อกำหนดด้านความเป็นอะตอมของ MongoDB ไปประยุกต์ใช้กับการใช้งานอื่นได้โดยตรง เนื่องจากการบันทึกรีวิวของ Juice Shop ไม่ได้ใช้ MongoDB โดยตรง แต่ใช้ MarsDB แทน
นอกจากนี้ แม้แต่ใน MongoDB การใช้ Unique Index กับอาร์เรย์เพียงอย่างเดียวก็ไม่สามารถป้องกันองค์ประกอบที่ซ้ำกันภายในเอกสารเดียวกันได้ จึงควรตรวจสอบ ขอบเขตการรับประกันความเป็นเอกลักษณ์ ก่อนเลือกวิธีการใช้งาน ทั้งนี้ การป้องกันการกดปุ่มรัวหรือการจำกัดอัตรา (Rate Limiting) เป็นเพียงมาตรการเสริมเท่านั้น ไม่สามารถใช้แทนการรับประกันความสอดคล้องของการอัปเดตพร้อมกันได้
การจำกัดเป้าหมายส่งผลต่อการจัดการปัญหาความยากสูงอย่างไร

ในการตรวจสอบครั้งนี้ การจำกัดเป้าหมายของงานให้แคบลงมีส่วนช่วยในการดำเนินการกับงานที่มีความยากสูง เมื่อประเมินประสิทธิภาพของ ARTEX จำเป็นต้องตรวจสอบไม่เพียงแค่ตัวโมเดลเท่านั้น แต่ยังรวมถึงขอบเขตของงานที่มอบหมายให้ทำในแต่ละงานด้วย
ในเป้าหมายที่กว้างเกินไป บางครั้งการรายงานผลการตรวจพบอาจล่าช้า
ในการทดสอบบนสภาพแวดล้อมแบบโลคัลครั้งนี้ เมื่อเรากำหนดเป้าหมายที่กว้างเกินไปให้กับ ARTEX ส่งผลให้ไม่ค่อยพบ "finding" ซึ่งเป็นผลลัพธ์จากการตรวจจับ และเกิดรอบการทำงานที่ว่างเปล่าโดยไม่มีความคืบหน้าที่ชัดเจน แม้ว่าการสำรวจจะยังคงดำเนินอยู่ แต่ก็ต้องใช้เวลานานกว่าที่ผลลัพธ์จะถูกสรุปออกมาเป็นรายงาน
จากการสังเกตเพียงเท่านี้ เรายังไม่สามารถระบุได้แน่ชัดว่าเป็นเพราะประสิทธิภาพการประมวลผลของ Mac หรือความสามารถในการอนุมานของโมเดล การแบ่งงาน ขอบเขตของการตรวจสอบ และการรอคอยระหว่างเอเจนต์ต่างก็ส่งผลต่อความคืบหน้าเช่นกัน เราจึงจำเป็นต้องตรวจสอบว่างานใดที่ติดขัดและมีสิ่งใดที่ยังไม่ได้รายงานออกมา แทนที่จะตัดสินขีดจำกัดของโมเดลโดยดูเพียงแค่เวลาที่ใช้ในการประมวลผลเท่านั้น
ด้วยเหตุนี้ เราจึงปรับเปลี่ยนโดยให้คนเป็นผู้กำหนดเป้าหมายของงานให้แคบลง และระบุฟังก์ชันหรือช่องโหว่ที่เป็นเป้าหมายให้ชัดเจนในการตรวจสอบ บทเรียนสำคัญที่ได้รับจากการดำเนินงานครั้งนี้คือ การเปลี่ยนการตั้งค่าเป้าหมายช่วยให้สามารถรับมือกับโจทย์ที่มีความยากสูงได้ อย่างไรก็ตาม เนื่องจากนี่ไม่ใช่การทดสอบแบบควบคุมที่เข้มงวด จึงไม่สามารถสรุปได้ว่าการจำกัดเป้าหมายเป็นสาเหตุเดียวที่ทำให้เกิดการปรับปรุงดังกล่าว
ระบุเป้าหมายและเงื่อนไขความสำเร็จให้ชัดเจน และตรวจสอบผลลัพธ์ทีละรายการ
การกำหนดเป้าหมายให้แคบลง ไม่ใช่เพียงแค่การให้เวลามากขึ้น แต่คือการแบ่งเป้าหมายอย่าง "ค้นหาปัญหาจากทั้งแอปพลิเคชัน" ให้เป็นหน่วยย่อยที่ระบุฟังก์ชันเป้าหมาย คุณสมบัติที่ต้องตรวจสอบ และเงื่อนไขที่ถือว่าเสร็จสมบูรณ์ได้ ตัวอย่างเช่น หากต้องการตรวจสอบว่าการจำกัดจำนวนครั้งของบางการดำเนินการยังคงทำงานถูกต้องแม้จะมีการประมวลผลแบบขนาน (Concurrent execution) หรือไม่ ให้กำหนดการดำเนินการเป้าหมาย รวมถึงสถานะการบันทึกข้อมูลก่อนและหลังที่ต้องตรวจสอบให้ชัดเจนก่อนเริ่มทำ
สำหรับโจทย์ที่เกี่ยวข้องกับ NoSQL ในครั้งนี้ สามารถหาตัวอย่างความสำเร็จได้ภายในเวลาประมาณ 10-15 นาที และสำหรับ Multiple Likes ใช้เวลาประมาณ 40 นาที การที่สามารถทำโจทย์ระดับ ★6 ได้สำเร็จหนึ่งข้อ ทำให้รู้สึกได้ว่าหากทำให้งานมีความเป็นรูปธรรมและกำหนดเงื่อนไขของแต่ละส่วนให้รัดกุมขึ้น ก็จะสามารถขยายขอบเขตการรับมือกับโจทย์ที่มีความยากสูงได้ ในทางกลับกัน Successful RCE DoS ยังอยู่ในระหว่างการปรับสภาพแวดล้อม Docker จึงยังไม่นับรวมอยู่ในโจทย์ที่ทำสำเร็จ
การจะตัดสินว่า "หากใช้เวลามากพอ ก็สามารถแก้โจทย์ระดับ ★6 ได้เกือบทั้งหมดโดยไม่มีปัญหา" นั้น จำเป็นต้องอาศัยความสำเร็จและการทำซ้ำได้ในโจทย์ข้ออื่นๆ ด้วย ระดับความยากที่เป็นดาวนั้นเป็นเพียงเกณฑ์อ้างอิงภายในสื่อการสอนเท่านั้น เทคโนโลยีและเงื่อนไขสภาพแวดล้อมที่จำเป็นจะแตกต่างกันไปในแต่ละโจทย์ ณ ขั้นตอนนี้ เราจึงแยกการประเมินระหว่างการมีตัวอย่างความสำเร็จในระดับความยากสูงสุด กับการสามารถรับมือกับโจทย์ระดับความยากสูงสุดได้อย่างเสถียรออกจากกัน
หากจะนำไปใช้ในการตรวจสอบของบริษัท ควรเก็บส่วนใดไว้บ้าง

การนำรายงานที่เขียนโดย AI ไปสู่ขั้นตอนการแก้ไข จำเป็นต้องมีเงื่อนไขการทำซ้ำ หลักฐาน และขอบเขตที่ยังไม่ได้ตรวจสอบ โดยให้กำหนดขอบเขตก่อนการดำเนินการ และออกแบบกระบวนการตั้งแต่ต้นจนถึงการตรวจสอบซ้ำหลังการแก้ไขให้เป็นขั้นตอนการตรวจสอบเดียวกัน
เชื่อมโยงขอบเขตการดำเนินการเข้ากับหลักฐาน
ขั้นแรก ให้กำหนด URL เป้าหมาย เวอร์ชันของแอปและการตั้งค่า สิทธิ์ที่ใช้ การดำเนินการที่อนุญาต รวมถึงขีดจำกัดของจำนวนการทำงานพร้อมกันและระยะเวลาในการทำงาน สำหรับการตรวจสอบที่มีการเขียนทับข้อมูล ให้เตรียมวิธีการย้อนกลับไปยังสถานะเริ่มต้นไว้ด้วย โปรดตรวจสอบทั้งขอบเขตเป้าหมายที่สั่งการไปยัง Agent และการตั้งค่าที่จำกัดปลายทางการสื่อสารจริง
การแบ่งสภาพแวดล้อมออกเป็นคอนเทนเนอร์เพียงอย่างเดียว ไม่สามารถตัดสินได้ว่าการสื่อสารนั้นถูกแยกออกจากกันแล้ว ให้ตรวจสอบการสื่อสารไปยังส่วนที่อยู่นอกเหนือเป้าหมาย สิทธิ์ในการเรียกใช้เครื่องมือ ไฟล์ที่เมาท์ไว้ และข้อมูลรับรอง (Credentials) หากเป็นโครงสร้างที่ใช้บริการ LLM ภายนอก การส่งข้อมูลที่มาพร้อมกับการอนุมาน (Inference) ก็ถือเป็นสิ่งที่ต้องจัดการเช่นกัน โดยให้แยกจัดการระหว่าง "การสื่อสารไปยังแอปเป้าหมาย" และ "การสื่อสารไปยังบริการอนุมาน"
ในส่วนของผลลัพธ์ ให้เชื่อมโยงการสื่อสารในช่วงเวลาปกติที่เป็นเกณฑ์มาตรฐาน การสื่อสารที่จำลองปัญหา และสถานะการบันทึกข้อมูลก่อนและหลังเหตุการณ์เข้าด้วยกัน ในครั้งนี้ก็ยังคงมีบางสถานการณ์ที่ไม่สามารถจับคู่ผลลัพธ์ของบันทึกการทำงาน (Execution Log) กับการสื่อสารที่เป็นหลักฐานโดยอัตโนมัติได้ การหลีกเลี่ยงสถานการณ์ที่เหลือเพียงสรุปจาก AI และการจัดทำบันทึกที่ผู้รับผิดชอบสามารถตรวจสอบย้อนกลับจากหลักฐานไปสู่ข้อสรุปได้นั้น ถือเป็นเงื่อนไขสำหรับการนำไปใช้งานจริงในธุรกิจ และเมื่อมีการแชร์ข้อมูล ให้ปกปิดโทเค็นและข้อมูลส่วนบุคคลด้วย
หลังการแก้ไข ต้องตรวจสอบทั้งการทำงานแบบขนานและการใช้งานปกติ
เงื่อนไขการเสร็จสิ้นของการแก้ไขไม่ใช่แค่การที่ข้อความแสดงข้อผิดพลาดเปลี่ยนไป หากเป็นปัญหาด้านการป้อนข้อมูล ต้องตรวจสอบให้แน่ใจว่าข้อมูลที่ผิดประเภทจะถูกปฏิเสธก่อนเข้าสู่กระบวนการทางธุรกิจ การป้อนข้อมูลตามปกติยังคงใช้งานได้ และรายละเอียดของข้อยกเว้นจะไม่ถูกเปิดเผยออกมาภายนอก หากจำเป็นต้องแก้ไขการสร้างคิวรี (Query) หรือการอนุญาต (Authorization) ก็ต้องตรวจสอบเงื่อนไขเหล่านั้นแยกต่างหากด้วย
ในกรณีของการกดไลก์ซ้ำ ต้องตรวจสอบโดยการจำลองสถานการณ์ที่มีการทำงานพร้อมกันซึ่งละเมิดข้อจำกัดก่อนการแก้ไข เพื่อให้มั่นใจว่าผลลัพธ์ที่บันทึกจะเกิดขึ้นเพียงครั้งเดียวเท่านั้น นอกจากนี้ยังต้องตรวจสอบว่าผู้ใช้รายอื่นยังคงใช้งานได้ตามปกติหรือไม่ และข้อมูลจะไม่ซ้ำซ้อนแม้ในกรณีที่การเชื่อมต่อขาดหายระหว่างทางแล้วมีการส่งข้อมูลซ้ำ ทั้งนี้เพื่อดูว่าการเพิ่มความเข้มงวดในการปฏิเสธข้อมูลนั้นไม่ได้ส่งผลกระทบต่อการใช้งานตามปกติ
แนวคิดเดียวกันนี้สามารถนำไปใช้กับการตรวจสอบการใช้คูปองหรือการตัดสต็อกสินค้าได้เช่นกัน อย่างไรก็ตาม ข้อจำกัดที่จำเป็นจะแตกต่างกันไปตามแต่ละฟังก์ชัน หากเป็นเรื่องของยอดคงเหลือ จำเป็นต้องป้องกันยอดเงินไม่เพียงพอและรักษาความสอดคล้องของบันทึกข้อมูลหลายรายการด้วย อย่าเพิ่งด่วนสรุปว่า "การใส่ข้อจำกัดความเป็นเอกลักษณ์ (Unique Constraint) จะแก้ปัญหาได้ทั้งหมด" แต่ให้ระบุเงื่อนไขทางธุรกิจที่ต้องปกป้องให้ชัดเจนก่อน แล้วจึงเลือกวิธีการแก้ไขที่เหมาะสม
คำถามที่พบบ่อย

เมื่อประเมิน AI Pentest จำเป็นต้องแยกพิจารณาระหว่างจำนวนภารกิจที่ทำสำเร็จกับความปลอดภัยของบริการจริงออกจากกัน
หากได้ผลลัพธ์ที่ดีใน Juice Shop ถือว่าเพียงพอสำหรับการทดสอบระบบจริงหรือไม่
ยังไม่สามารถตัดสินได้ว่าเพียงพอแล้ว Juice Shop มีช่องโหว่ที่ตั้งใจใส่ไว้และมีวิธีแก้ไขที่เปิดเผยต่อสาธารณะ ในการใช้งานจริง เงื่อนไขการตรวจสอบจะรวมถึงความเข้าใจในสิทธิ์การเข้าถึงและข้อกำหนดทางธุรกิจ ภาระงานที่ยอมรับได้ และการจัดการบันทึกข้อมูล เป็นต้น ก่อนอื่นควรประเมินในสภาพแวดล้อมการทดสอบที่ใกล้เคียงกับของบริษัทตนเอง โดยรวมถึงงานที่จำเป็นสำหรับการตรวจสอบผลบวกปลอม (False Positive) และการทบทวนรายงาน ผลลัพธ์ในครั้งนี้เป็นเพียงข้อมูลส่วนหนึ่งในการพิจารณาการออกแบบดังกล่าว
บทสรุป

ในการตรวจสอบครั้งนี้โดยใช้ ARTEX รุ่นที่ 1 เราได้รับผลลัพธ์ที่ประสบความสำเร็จในระดับความยาก ★1 ถึง ★3 รวมถึงโจทย์ระดับสูงที่เกี่ยวข้องกับ NoSQL และโจทย์ระดับสูงสุด ★6 อย่าง Multiple Likes โดยเวลาที่ใช้ในการดำเนินการแบบเจาะจงเป้าหมายนั้น โจทย์ที่เกี่ยวข้องกับ NoSQL ใช้เวลาประมาณ 10-15 นาที และ Multiple Likes ใช้เวลาประมาณ 40 นาที ส่วน Successful RCE DoS นั้นอยู่ในระหว่างการปรับสภาพแวดล้อม Docker
ความบกพร่องของรูปแบบอินพุต, การเปิดเผยข้อผิดพลาดโดยละเอียด, การเจาะระบบยืนยันตัวตน และการทำ Injection ไม่ได้มีความหมายเหมือนกัน ปัญหาเรื่องการทำงานพร้อมกัน (Concurrency) ก็ไม่ได้ตัดสินจากรหัสตอบกลับ (Response Code) เพียงอย่างเดียว แต่ตัดสินจากสถานะที่ถูกบันทึกไว้ด้วย ในฝั่งการพัฒนาควรแยกการป้องกันระหว่างอินพุตและการนำไปใช้งาน และออกแบบข้อจำกัดของข้อมูลที่ยังคงได้รับการปกป้องแม้จะเกิดการแข่งขันกันของข้อมูล
ในการดำเนินงานครั้งนี้ เมื่อเกิดความล่าช้าในเป้าหมายที่กว้างเกินไป การที่มนุษย์เข้ามาทำให้เป้าหมายและเงื่อนไขความสำเร็จมีความชัดเจนขึ้นนำไปสู่ผลลัพธ์ในขั้นถัดไป ดังนั้นเมื่อพิจารณาการนำ AI Pentest มาใช้ โปรดจำกัดขอบเขตที่มอบหมาย และประเมินว่าสามารถดำเนินการจนถึงขั้นตอนการแก้ไขและตรวจสอบซ้ำโดยอาศัยหลักฐานที่ทำซ้ำได้หรือไม่ นอกเหนือจากจำนวนที่ตรวจพบแล้ว คุณค่าในการปฏิบัติงานจริงยังอยู่ที่ผลลัพธ์ที่ทีมพัฒนาสามารถนำไปใช้ในการแก้ไขได้
เอกสารอ้างอิง (วันที่ตรวจสอบ: 21 ตุลาคม 2026)
- OWASP Juice Shop: การใช้งานและภาพรวมโครงการ
- คู่มือทางการ: การกำหนดโจทย์ เช่น NoSQL Manipulation
- คู่มือทางการ: การกำหนดโจทย์ Multiple Likes
- คู่มือทางการ: การกำหนดโจทย์ RCE DoS และข้อจำกัดของสภาพแวดล้อมการทำงาน
- OWASP: แนวทางการตรวจสอบอินพุต
- MongoDB: ความเป็นอะตอมของการอัปเดต, ขอบเขตการรับประกันของ Unique Index
แหล่งอ้างอิงสำหรับการนำไปใช้งานได้ระบุไว้ในลิงก์ภายในเนื้อหา เนื่องจากแหล่งข้อมูลสาธารณะมีการอัปเดตอยู่เสมอ โปรดตรวจสอบเวอร์ชันของโค้ดที่ใช้เมื่อทำการตรวจสอบซ้ำอีกครั้ง
ผู้เขียน・ผู้ตรวจสอบ

Yusuke Ishihara
เริ่มเขียนโปรแกรมตั้งแต่อายุ 13 ปี ด้วย MSX หลังจบการศึกษาจากมหาวิทยาลัย Musashi ได้ทำงานพัฒนาระบบขนาดใหญ่ รวมถึงระบบหลักของสายการบิน และโครงสร้าง Windows Server Hosting/VPS แห่งแรกของญี่ปุ่น ร่วมก่อตั้ง Site Engine Inc. ในปี 2008 ก่อตั้ง Unimon Inc. ในปี 2010 และ Enison Inc. ในปี 2025 นำทีมพัฒนาระบบธุรกิจ การประมวลผลภาษาธรรมชาติ และแพลตฟอร์ม ปัจจุบันมุ่งเน้นการพัฒนาผลิตภัณฑ์และการส่งเสริม AI/DX โดยใช้ generative AI และ Large Language Models (LLM)
บทความแนะนำ


คำศัพท์ที่เกี่ยวข้องกับบทความนี้

การทดสอบเจาะระบบ AI (AI Red Teaming)
วิธีการประเมินที่ทดสอบช่องโหว่ของระบบ AI อย่างเป็นระบบจากมุมมองของผู้โจมตี เพื่อระบุความเสี่ยงด้านคว
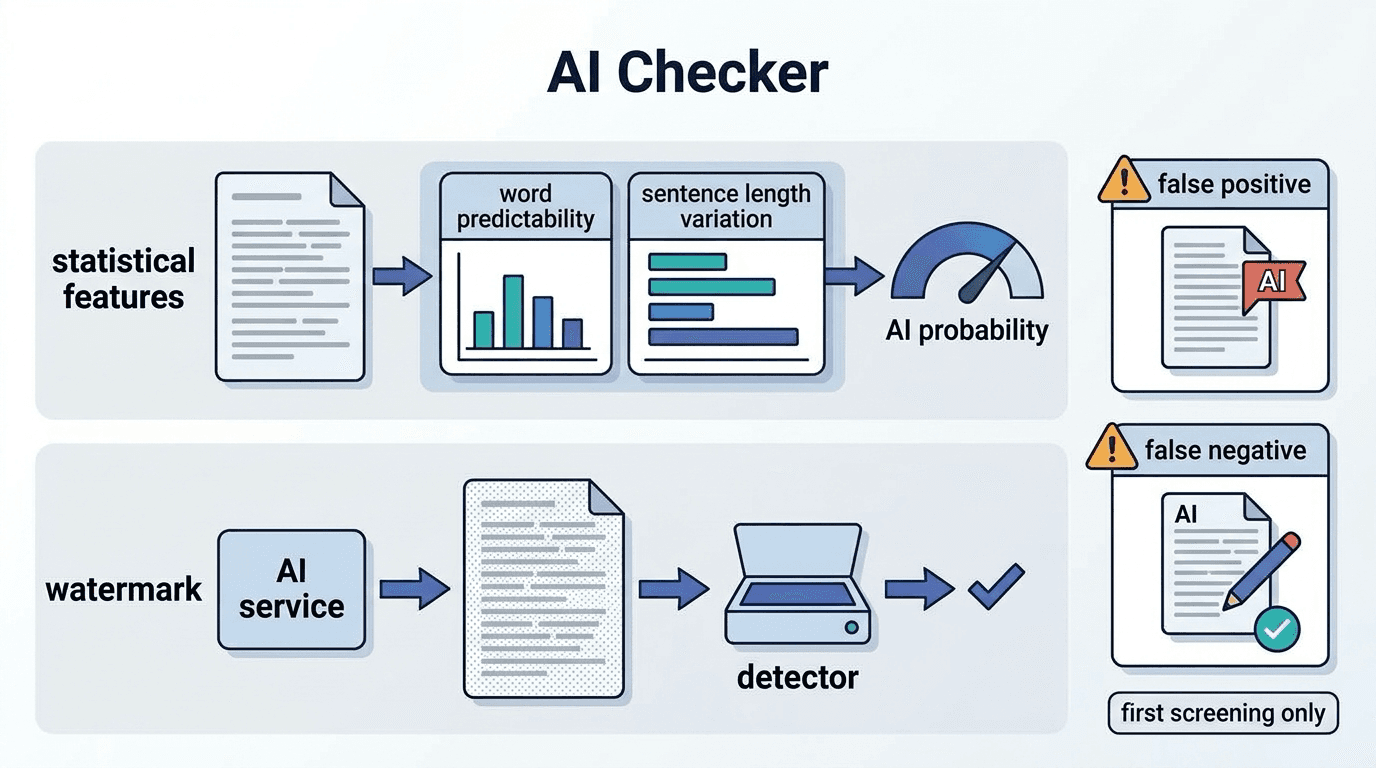
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว

การทดสอบ E2E
การทดสอบ E2E (End-to-End Testing) คือวิธีการทดสอบที่จำลองการกระทำของผู้ใช้เป็นจุดเริ่มต้น แล้วส่งผ่า