N+1問題の解決パターン:データベースクエリ最適化の実装チェックリスト

リード文
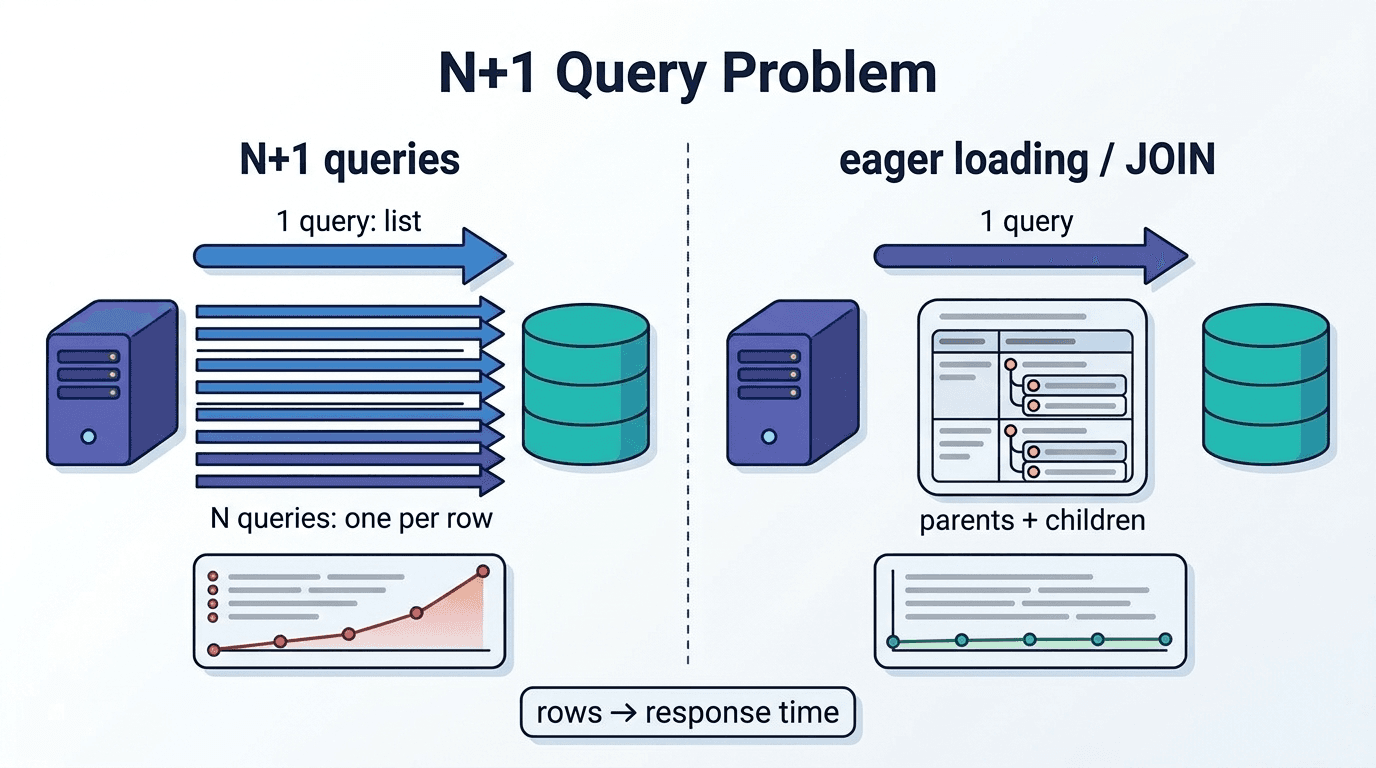
N+1問題は、親レコードを1件取得した後に関連データを個別に問い合わせることで、クエリ数が「N+1」件まで増える性能課題であり、検出→原因分析→パターン選択の3段階を踏むことで解決できます。本記事は、ORMを使うバックエンド開発者、データベース設計者、パフォーマンス最適化担当者を対象に、クエリログやAPMを使った検出手順から、JOIN・バッチ処理・キャッシングという3つの解決パターンの選び方、実装後の検証手順までを、実装チェックリスト形式で示します。読み終えると、自社システムの関連データの構造(単値か集合か)とアクセス頻度を基準に最適な手法を選び分け、クエリ実行数を1/10以下に抑える実装に着手できるようになります。比較表とチェックリストを使えば、パターン選択の判断基準をチーム内で共有する資料としても活用できます。
N+1問題は、解決パターンを選ぶ前に、実際に発行されているクエリ件数を数値で確認しないと改善効果を測定できません。親レコード数に比例してクエリ数が増えているかどうかが、N+1発生の判断基準になります。クエリログでの手動確認、APM・プロファイラーによる自動検出、コード上での発生箇所の特定という3つの視点から、原因箇所を段階的に突き止めます。
クエリログで実行数を確認する手順
実行数の確認は、ORMが発行するSQLをログへ出力し、1つの画面表示やAPIレスポンスで何件のSELECTが実行されたかを数えることから始めます。Django であれば connection.queries で実行済みSQLの件数を取得できます。
1from django.db import connection, reset_queries
2
3reset_queries()
4authors = Author.objects.all()
5for author in authors:
6    author.books.all()  # 関連取得
7print(len(connection.queries))
親レコード数が10件なのにログの件数が11件(1+10)であれば、N+1が発生している状態です。件数がレコード数に比例して増減するかを確認すれば、JOINなど1クエリ化できていない箇所を特定できます。手順としては、まず対象の画面・APIを1回呼び出してクエリ件数を記録し、次にテストデータの親レコード数を2倍に増やして同じ処理を再実行します。クエリ件数がほぼ同じ比率で増えていれば、ループ内の関連アクセスが原因である可能性が高く、該当コードの行番号までログから絞り込めます。
APM・プロファイラーで自動検出する
手動でのログ確認は開発中の一画面を検証する分には十分ですが、本番環境で発生箇所を網羅的に見つけるには手間がかかります。Django Debug Toolbar は、リクエストごとに発行されたSQLの件数と内容をブラウザ上で一覧表示するため、開発中の画面単位でN+1の有無を即座に確認できます。Ruby on Rails では、Bullet gemを開発・テスト環境に組み込むと、N+1が疑われるクエリパターンを検出した際にログ通知や例外を発生させられるため、コードレビューの前段階で機械的に検知できます。本番環境で発生頻度や実行時間まで含めて把握したい場合は、APMツールで同一トレース内のSQL実行数の急増や同一クエリの繰り返しを可視化する方法が有効です。トレース画面では、1リクエストあたりのSQL件数がエンドポイントごとに集計されるため、リリース後に件数が急増したエンドポイントを優先的に調査できます。
コード上で発生箇所を特定するポイント
発生箇所の特定は、ループ内でリレーション属性にアクセスしている行を探すことに集約されます。for author in authors: のようなループ本体で author.books.all() や author.profile.name のように関連オブジェクトへ到達している記述があれば、その行がループ回数分のクエリを生んでいる箇所です。テンプレートやシリアライザの内部で暗黙的に関連を辿っているケースも見落としやすく、ビュー層のコードだけでなく、テンプレートファイルやAPIのシリアライズ処理まで確認範囲を広げる必要があります。
特定を確実にする方法として、疑わしい関連属性に SQLAlchemy の raiseload() を設定し、遅延ロードが発生した瞬間に例外を出す手法があります。例外のスタックトレースにはアクセス元の行番号がそのまま記録されるため、ログの件数から逆算するより早く該当箇所を絞り込めます。
N+1問題の解決パターン比較表

関連が単値(外部キー・1対1)ならJOINで1クエリに統合し、関連が集合(多対多・1対多で件数が多い)ならバッチ処理を選び、さらに更新頻度が低い参照データにはキャッシングを重ねるのが基本方針です。データ量・アクセス頻度・更新頻度の3軸で、以下のように使い分けます。
| パターン | クエリ数 | 適した関連の形 | 注意点 |
|---|---|---|---|
| JOIN(select_related/joinedload/eager_load) | 1回 | 外部キー・1対1、子の件数が少ない1対多 | 結果行数が親×子まで膨張し重複列でメモリ消費が増える |
| バッチ処理(prefetch_related/selectinload/IN句) | 2回前後 | 多対多・1対多で子の件数が多い集合 | 親集合が大きいとIN句の引数件数が肥大化する |
| プロキシ経由のバッチ取得(@BatchSize等) | 複数回だが件数を削減 | 遅延読み込みのプロキシ解決 | バッチサイズを行サイズに応じて調整する必要がある |
| キャッシング(Redis等) | 0〜1回 | 更新頻度が低い参照データ | 無効化タイミングを別途設計しないと古い値を返し続ける |
判断に迷う場合は、まず関連の形(単値か集合か)でJOINかバッチ処理かを決め、そのうえで更新頻度が低いと確認できたデータにだけキャッシングを追加する順序で検討します。更新頻度が高いデータへ先にキャッシングを適用すると、無効化漏れによる不整合のリスクが先行して増えるため、JOINまたはバッチ処理での解決を優先します。
各パターンの選択基準
選択基準は、関連データの件数比率とアクセス頻度の2軸で決めます。親1件に対して子が数件程度の1対多ならJOINで十分ですが、子が数十件以上に膨らむ関連にJOINを使うと、結果セットの行数が親×子の数まで膨張し、転送量とメモリ消費が悪化します。この場合はバッチ処理で親集合をまとめて取得し、アプリケーション側で結合する方式に切り替えます。判断の順序としては、まず外部キーが必須で関連が単値かどうかを確認し、単値であればJOIN、集合であればバッチ処理を仮決めします。次に、その関連データが更新頻度の低い参照系(マスタデータや設定値など)かどうかを確認し、該当する場合のみバッチ処理やJOINの結果自体をキャッシングで省略できるかを検討します。逆に更新頻度が高いデータにキャッシングを適用すると、無効化漏れによる不整合が発生します。
パターン1:JOINを使った関連データの一括取得

外部キー・1対1のように親1件に対して子が必ず1件対応する関連は、JOINで1回のクエリに統合すると、ループ内で発生していた個別クエリを消せます。子の件数が複数になる1対多では結果行数が膨張するため、INNER JOINとLEFT JOINのどちらを選ぶかで、欠落レコードの扱いや行数への影響が変わります。
INNER JOINで1クエリに統合する実装
INNER JOINによる統合は、Django の select_related、SQLAlchemy の joinedload、Rails の eager_load がいずれも内部でJOIN文を生成し、親子データを1回のSELECTで取得する実装です。外部キーが必須(NOT NULL)で、関連レコードが必ず存在する場合に適しています。
1# Django: select_relatedでJOINに統合
2books = Book.objects.select_related("author").all()
3for book in books:
4    print(book.author.name)  # 追加クエリなし
select_related("author") を指定すると、Book と Author の JOIN が1回のSQLにまとめられ、ループ内で book.author にアクセスしても追加クエリは発生しません。SQLAlchemy では joinedload(Book.author)、Rails では Book.eager_load(:author) と書けば同じ結果になり、いずれも生成されるSQLは1本のSELECT文にJOIN句を含む形です。
LEFT JOINでNULL値を含める場合の注意点
関連レコードが存在しない親も結果に含めたい場合は、LEFT JOINを使います。外部キーがNULL許容で、関連が0件のケースを排除してはならない業務要件(未読メールがない利用者一覧など)では、INNER JOINだと該当レコードが欠落します。Django の select_related はNULL許容の外部キーに対して自動的にLEFT OUTER JOINを生成するため、実装上の追加指定は不要です。
1# Django: NULL許容のprofileも1クエリで取得
2authors = Author.objects.select_related("profile").all()アプリケーション側では、関連オブジェクトがNoneになる分岐を必ず用意します。author.profile.name のようにNULLチェックなしでアクセスすると、関連が存在しないレコードで例外が発生するため、author.profile and author.profile.name のような形で防御します。
パターン2:バッチ処理で複数IDをまとめて取得

子の件数が多い1対多や多対多の関連では、JOINによる行の膨張を避け、親のID集合をまとめてIN句で問い合わせ、アプリケーション側でメモリ上に結合する方式が適しています。クエリ数は1回には減らないものの、2回前後に抑えられます。実装の要点はIN句の書き方とバッチサイズの決定であり、どちらもデータ量に応じた調整が必要です。
IN句を使ったバッチクエリの実装例
IN句によるバッチ取得は、親レコードのID一覧を先に集め、その集合を1回のSELECTで問い合わせて、アプリケーション側でメモリ上のハッシュに紐づける実装です。Django の prefetch_related や SQLAlchemy の selectinload は内部でこの方式を自動生成します。
1# 素朴なIN句バッチクエリの実装
2author_ids = [a.id for a in authors]
3books = Book.objects.filter(author_id__in=author_ids)
4
5books_by_author = {}
6for book in books:
7    books_by_author.setdefault(book.author_id, []).append(book)
8
9for author in authors:
10 author.books_cache = books_by_author.get(author.id, [])このコードでは、ループの前にBookを1回だけ取得し、author_id をキーにした辞書へ振り分けてから各Authorに割り当てています。JOINと異なり結果行数が親×子まで膨張しないため、1対多の子件数が多い関連でもメモリ消費を抑えられます。
辞書へのグルーピングを手作業で書く代わりに、itertools.groupby を使う実装もありますが、事前に author_id でのソートが必須になる点に注意が必要です。
バッチサイズの決定方法
バッチサイズは、IN句に渡すID件数の上限をデータベースのパラメータ上限とアプリケーションのメモリ使用量の両面から決めます。PostgreSQLやMySQLではIN句の件数自体に明確な上限はありませんが、数千件を超えると実行計画が悪化し、クエリ実行時間が伸びる場合があります。JPA/Hibernateの@BatchSizeでは、10〜100件程度の範囲で調整し、プロキシ解決時に一括取得する件数を制御します。
判断の順序は次のとおりです。まず対象テーブルの1行あたりのサイズ(カラム数・文字列長)を確認し、次に想定される親レコード数の最大値を確認します。行サイズが大きい(画像URLや長文カラムを含むなど)場合は、1回のIN句で数百件程度に留め、行サイズが小さい単純なマスタデータであれば1000件単位でも問題になりにくいです。
パターン3:キャッシング戦略でクエリ実行を削減

JOINやバッチ処理でクエリ数を削減した後、さらに実行自体を省略できるのは更新頻度が低い参照データに限られます。読み取り比率とデータの変更頻度を基準に、キャッシングを追加すべき箇所を判断します。対象を誤ると古い値を返し続けるリスクがあるため、保存先の選定と無効化タイミングの設計を分けて検討します。
メモリキャッシュ(Redis等)の活用
Redisなどのインメモリキャッシュは、バッチ処理で取得済みの結果をキーごとに保存し、次回以降のアクセスでデータベースへの再問い合わせを省略する仕組みです。キーは親IDと関連名を組み合わせて設計し(例: author:123:books)、値はシリアライズしたリストとして保存します。ここで見落としやすいのは、ループ内で個別に cache.get() を呼ぶ実装が、キャッシュ層自体にN+1と同じ構造の呼び出し回数を生む点です。
キャッシュ無効化のタイミング設定
キャッシュ無効化のタイミングは、書き込み操作の直後にキーを削除する方式が最も確実です。Author や Book のレコードが更新・削除された瞬間に author:123:books のような関連キーを明示的に削除すれば、古い値を返し続けるリスクを避けられます。
1def save(self, *args, **kwargs):
2    super().save(*args, **kwargs)
3    cache.delete(f"author:{self.author_id}:books")
無効化漏れが起きやすいのは、一括更新やSQLの直接実行のようにシグナルやORMのsaveを経由しない処理です。この経路が存在するテーブルでは、削除フックだけに依存せず、キーの有効期限(timeout)を短めに設定して二重で防ぎます。目安として、更新頻度が1日数回程度の参照データなら数分から数十分単位のtimeoutを設定し、削除フックが働かなかった場合でも一定時間内に古い値が失効するようにしておきます。timeoutを長く取りすぎると、無効化漏れの影響が長時間残るため、書き込み頻度に応じて短縮します。
N+1問題の解決実装チェックリスト

実装チェックの抜け漏れを防ぐには、検出・分類・適用・検証という順序で一覧にまとめておくと判断が早くなります。
| チェック項目 | 確認方法 | 完了条件 |
|---|---|---|
| N+1の再現 | クエリログ・APMでSQL件数を計測 | 親レコード数と発行クエリ数の比例関係を確認済み |
| 関連の形の分類 | 外部キー・1対1か、1対多・多対多かを判定 | 単値か集合かをコード上で特定済み |
| パターン適用 | JOIN・バッチ処理のいずれかを実装 | 適用後にクエリ件数が減少したことをログで確認 |
| 結果件数の検証 | JOIN適用後の行数膨張を確認 | 親×子の重複行がメモリ消費に影響しない範囲か確認済み |
| キャッシュ対象の判定 | 更新頻度・読み取り比率を確認 | 参照系データのみキャッシング対象に限定 |
| 無効化設計 | save/deleteフックまたはtimeoutを設定 | 書き込み時のキー削除処理が実装済み |
| 自動検出の組み込み | Bullet gemやDebug Toolbarを開発環境に導入 | CIまたは開発フローで継続的に検知できる状態 |
自動検出の組み込みまで完了すると、新規コードでのN+1混入を実装段階で防ぐ体制になります。パターン選択に迷う項目が残る場合は、関連の件数比率とアクセス頻度の2軸に立ち戻り、単値か集合かの判定からやり直すと判断がぶれません。
よくある質問:N+1問題の解決で失敗しないために

解決パターンは単独適用で終わらず、関連の階層ごとに組み合わせる場面があります。また改善を確認する際は、計測条件をそろえずに検証すると、本番環境での負荷変化を正しく捉えられません。判断が分かれやすい2点を、以下で具体的に整理します。
複数の解決パターンを組み合わせるべき場面は?
複数のパターンを組み合わせるべき場面は、1画面の中に関連の形が異なる階層が複数存在するときです。想定例として、著者一覧から書籍、書籍ごとの注文履歴まで表示する画面を考えます。著者→書籍は子の件数が多い1対多の集合なのでバッチ処理を選び、書籍→カテゴリは1対1相当なのでJOINで1クエリに統合します。さらに書籍のカテゴリ名は更新頻度が低いためバッチ処理の結果をキャッシングし、注文履歴は更新頻度が高いためキャッシングを見送ります。判断は画面単位ではなく関連ごとに行い、外部キーが単値かどうか、子の件数がどの程度か、更新頻度が低いかをそれぞれ個別に確認します。1つのパターンで全階層を統一すると、集合が大きい階層ではJOINによる行膨張が起き、単値の階層ではバッチ処理のIN句が不要なオーバーヘッドになります。関連ごとにパターンを分けて適用し、後からチェックリストの「パターン適用」の項目で階層別に結果を確認すると、適用漏れを防げます。
解決後のパフォーマンス検証はどう実施する?
解決後の検証は、修正前に計測した条件を変えずに同じ手順で再計測し、数値の変化を記録する作業です。
- 修正前と同一のテストデータ件数・同一のエンドポイントでクエリログの発行件数を再計測する
- 親レコード数を2倍・5倍と変化させ、クエリ数が比例増加しないこと(1〜2回程度で一定に保たれること)を確認する
- JOINを適用した箇所は、結果セットの行数が想定範囲内か(親×子の膨張が許容量を超えていないか)を確認する
- キャッシングを追加した箇所は、キャッシュヒット時とミス時の両方でレスポンス時間を計測し、ミス時でも許容範囲内か確認する
- 本番相当のデータ量でAPMを使い、同一トレース内のSQL実行数と合計実行時間が改善しているかを確認する
- バッチ処理を適用した箇所は、IN句の引数件数がバッチサイズの上限を超えていないかログで確認する
想定例として、修正前に親100件で101回だったクエリが、修正後に親500件でも2〜3回で一定であれば、比例増加が解消されたと判断できます。
参考文献
- SQLAlchemy ORM関連オブジェクトチュートリアル閲覧日 2026年9月28日
- Django 開発版 クエリ最適化ドキュメント閲覧日 2026年9月29日
- Django クエリ最適化ドキュメント閲覧日 2026年9月29日
- Django QuerySet API リファレンス閲覧日 2026年9月29日
- SQLAlchemy リレーションシップクエリガイド閲覧日 2026年9月29日
- SQLAlchemy ORM リレーションオブジェクトチュートリアル閲覧日 2026年9月29日
- Rails Active Record クエリガイド閲覧日 2026年9月29日
著者・監修者

Yusuke Ishihara
13歳でMSXに触れプログラミングを開始。武蔵大学卒業後、航空会社の基幹システム開発や日本初のWindowsサーバホスティング・VPS基盤構築など、大規模システム開発に従事。 2008年にサイトエンジン株式会社を共同創業。2010年にユニモン株式会社、2025年にエニソン株式会社を設立し、業務システム・自然言語処理・プラットフォーム開発をリード。 現在は生成AI・大規模言語モデル(LLM)を活用したプロダクト開発およびAI・DX推進を手がける。