生成AIモデルの出力品質を自動測定する評価指標と実装方法

リード文
本記事では、生成AIモデルの出力品質を自動測定する評価指標と実装方法について解説します。生成AIを本番環境で運用していると、ある日突然「出力の質が落ちている」という声が現場から上がることがあります。しかし、いつから劣化していたのか、どの範囲に影響が出ているのかを人手評価だけで特定するのは容易ではありません。BLEU・ROUGE・BERTScoreなどの自動評価指標と品質監視ツールを組み合わせることで、こうした出力劣化を人手評価に依存せず継続的に検知できます。対象読者は、生成AIを本番運用しているMLエンジニア・QA責任者・データサイエンティストです。自動評価指標の選定方法から監視ツールの導入手順、アラート閾値の設定まで実装例とともに紹介し、品質劣化の検知にかかる時間を人手評価と比べて大幅に短縮できる自動評価体制の構築方法を示します。継続的な品質保証の仕組みを自社の運用フローに落とし込む際の指針として活用していただきたいです。
生成AIの出力品質を「良さそう」「悪そう」という感覚だけで判断していると、モデルを差し替えたときや、プロンプトを微調整したときの変化を客観的に説明できなくなります。BLEU・ROUGE・BERTScoreといった自動評価指標を使えば、翻訳・要約・質問応答など出力の種類ごとに数値で品質を測定でき、改善の有無を数字で示せるようになります。以下では、まず指標をどう分類し、どう使い分けるかという考え方を整理し、続く項目で本番運用に組み込む理由と実装方法を具体的に見ていきます。
本番運用での品質監視が必要な理由
入力データの分布が変化する場合はモデル出力の傾向がずれやすく、逆に入力分布が安定している場合でも、モデル自体の更新やAPIの仕様変更によって出力品質が変わることがあります。生成AIモデルは学習時点のデータに基づいて応答を生成するため、本番運用を続けるうちに入力分布の変化(ユーザーの質問傾向やドメインの変化)や、モデル提供元によるバージョン更新の影響を受けます。
PoCの段階では手作業でサンプルを確認して問題を発見できますが、本番稼働後は日々の出力件数が増え、目視での全件チェックは現実的ではありません。要約タスクで参照元の文書が更新された際に、モデルが古い文脈のまま応答を生成し続けるケースが報告されています。こうした劣化は徐々に進行するため、定期的なサンプリング評価だけでは検知が遅れがちです。
品質監視を自動化しておけば、出力品質の劣化を数時間から数日の単位で捉えられ、対応の遅れによる顧客対応品質の低下や誤情報提供のリスクを抑えられます。NIST AI RMFが示す継続的なリスク管理の考え方に沿って、運用フェーズでの監視体制を整えることが品質保証の土台になります。
自動評価指標と人手評価の使い分け
自動評価指標と人手評価は代替関係ではなく、監視対象の性質によって役割を分担する関係にあります。BLEUやBERTScoreのようなスコアは、大量の出力を秒単位で処理できるため、本番運用中のリクエスト全件を対象にした継続監視に向いています。一方で、事実の正確性や文脈適合性、有害表現の有無といった判断は、数値指標だけでは検出しきれないケースが報告されています。
自動評価指標のスコアが高くても、人間の主観評価と一致しない出力が一定数含まれます。要約タスクでROUGEスコアが高くても原文の意図と異なる要約が生成される場合があり、こうした誤りは人手評価でなければ拾いにくいです。そのため、スコアが高いことをもって品質を保証したと判断するのではなく、サンプリングによる人手レビューを併用する運用が必要になります。
実務上は、自動評価指標を一次フィルタとして全件に適用し、スコアが閾値を下回った出力や、ランダム抽出した一部の出力のみを人手評価に回す二段階運用が現実的です。QA責任者は評価対象の割合と頻度をあらかじめ定義し、ヒューマン・イン・ザ・ループ(HITL)とは?AIで業務自動化を定着させる「人間参加型」設計の基礎で示されるような人間の関与ポイントを運用ルールに組み込みます。この設計次第で監視体制の実効性は大きく変わります。
生成AI出力品質の自動評価指標一覧

生成AIの出力品質を測る指標は、大きく3つの系統に分けられます。単語や表現の重なりを機械的に測るBLEU・ROUGEのような表層一致系、文の意味的な近さをベクトル空間で捉えるBERTScoreのような意味一致系、そして要約・翻訳・質問応答といったタスクごとに設計された固有指標です。
実務でまず候補に挙がるのはBLEU・ROUGE・BERTScoreの3つで、これらは適用範囲が広く計算コストも低いため、最初の評価軸として厚めに扱う価値があります。一方でタスク固有指標は対象タスクを限定する分、汎用性は下がりますが精度は上がります。以降の節では、この優先順位に沿って計算方法と適用場面を見ていきます。
テキスト生成の自動評価指標(BLEU・ROUGE・BERTScore)
BLEU・ROUGE・BERTScoreは、表層の一致を見るか意味の一致を見るかで役割が分かれます。この違いを理解しておくと、タスクに応じた指標選定を誤らずに済みます。
BLEU は Papineni らが2002年に提案した指標で、生成テキストと参照テキストのN-gram一致率を計測します。翻訳評価で標準的に使われ、実装には再現性を重視したsacreBLEUが用いられることが多いです。ただし単語の言い換えを一致とみなさないため、同じ意味でも表現が異なると低く評価される傾向があります。
ROUGE は Lin が2004年に発表した要約評価向けの指標で、参照テキストに含まれるN-gramを生成テキストがどれだけ再現できているかを測ります。ROUGE-1・ROUGE-2・ROUGE-Lなど複数のバリエーションがあり、要約タスクの品質監視で広く採用されています。
BERTScore はBERTの埋め込みを用いてトークン単位の意味的類似度を計算する指標で、Zhang らの論文で提案されました。表層の一致に依存しないため、言い換えや同義語表現にも対応できる点がBLEU・ROUGEとの明確な違いです。
生成AI(Generative AI)の本番監視では、参照テキストが用意できる要約・翻訳タスクにROUGE・BLEUを、より意味的な妥当性を確認したい対話生成やRAG(Retrieval-Augmented Generation)の応答評価にBERTScoreを組み合わせる運用が実務的です。単一指標に依存せず、複数指標をログ記録して傾向を追うことが品質劣化の早期発見につながります。実際の運用でBLEU・ROUGE・BERTScoreという3件の指標をログに記録し傾向を追跡したところ、品質劣化の検知漏れが減少するという結果になりました。
意味的一致度を測る指標(Semantic Similarity・Cosine Similarity)
表現の言い換えを検出したい場合はコサイン類似度による意味的一致度が有効で、単語の並び自体を評価したい場合はBLEU・ROUGEのような表層一致指標が向いています。意味的一致度の測定では、出力文と参照文をエンベディングでベクトル化し、両者の方向がどれだけ近いかをコサイン類似度で数値化します。これは「単語の完全一致」を求める採点ではなく、「言い回しは違っても意味の方向性が同じかどうか」を測る評価方法です。
BERTScoreもこの系譜に属し、トークン単位のエンベディング類似度を集約してスコア化するため、言い換えや語順の入れ替えがあっても妥当な評価を返しやすい特性があります。一方で、意味的一致度には限界もあります。エンベディングモデルの学習データに含まれない専門用語やドメイン固有の表現では、実際の意味的な差異とスコアが対応しないケースが報告されています。
実装では、Gemini Embedding 2のような多言語対応エンベディングモデルを使うと、翻訳タスクや多言語NLPを含む出力の意味的一致度も一貫した基準で測定できます。閾値設計は単一指標に依存せず、表層一致指標と組み合わせて評価する運用が実務上のバランスを取りやすい選択です。
タスク固有の評価指標(要約・翻訳・質問応答)
要約・翻訳・質問応答は求められる品質の性質が異なるため、汎用的なBLEU・ROUGE・BERTScoreだけでは評価の粒度が不足する場面があります。タスクの特性に応じた指標を組み合わせることが精度向上の条件になります。
要約タスクでは、原文の要点をどれだけ落とさずに圧縮できたかが評価の中心です。ROUGEはN-gramの重複率を測るため要約評価の標準として広く使われていますが、言い換えによる意味的な一致は捉えにくいという弱点があります。実際、要点は保持しつつ表現をまるごと入れ替えた要約はROUGEで低スコアになりやすく、この弱点を補うためにBERTScoreを併用して語彙が異なっても意味が保持されているかを確認する運用が実務では有効です。
翻訳タスクでは、機械翻訳の品質評価を目的に開発されたCOMETやBLEURTが参照値との相関の高さで評価されています。COMETはニューラルネットワークによる評価フレームワークとして、人間の判断との相関がBLEUより高いと報告されており、翻訳品質の継続監視に適しています。METEORも同義語や語形変化を考慮できるため、BLEUの補完指標として使われることがあります。
質問応答タスクで評価の中心となるのは、回答が質問の意図に正確に答えているかという正確性です。単純な文字列一致では言い換えられた正答を誤検出するため、意味的一致度を測る指標との組み合わせが必要になります。指標の選定はタスクの目的次第であり、監視精度そのものを左右する条件です。
生成AIモデルの出力品質を自動測定する実装方法

評価指標の実装は、計算ロジック・記録先・可視化手段という3つの要素を組み合わせて構築する。ログ記録の仕組みと監視ツールの選定を軸に、実装の流れを順に説明する。
評価指標の計算・ログ記録の仕組み
評価パイプラインは工場の検品ラインに近い構造で組みます。生成AIの出力を流れ作業のように一件ずつ通過させ、複数の指標を計測し、結果を記録してから初めて出荷(本番反映)するという流れです。
具体的には、推論結果と参照テキスト(正解データやリファレンス要約)をペアで保存し、BLEU・ROUGE・BERTScoreなどをバッチ処理で計算します。バッチ処理を選ぶ理由は、リアルタイム計算だと推論のレイテンシに評価コストが上乗りされ、本番応答が遅延するためです。多くの現場では、推論ログを一度キューやストレージに蓄積し、数分〜数時間おきに非同期で評価ジョブを走らせる構成を採用します。
ログには、入力プロンプト、出力テキスト、参照データ、各指標のスコア、モデルバージョン、タイムスタンプを最低限含めます。モデルバージョンを記録しないと、後から品質劣化の原因がモデル更新かデータ変化かを切り分けられません。BERTScoreは埋め込みモデルへの依存があるため、評価用モデルのバージョンも固定して記録します。
これらのログは時系列データベースやメトリクス収集基盤(Prometheusなど)に流し込み、次に述べる監視ツール側で可視化と異常検知に利用します。
監視ツール・プラットフォームの選定と導入
監視対象がテキスト生成品質のドリフト検知であればEvidentlyやNannyMLのようなOSS、既存の時系列基盤にメトリクスを統合したい場合はPrometheusでの自前実装が適しています。EvidentlyはML/LLM向けのオープンソース監視フレームワークで、データドリフトや出力分布の変化を公式ドキュメントに沿って比較的短期間で構築できます。NannyMLはラベルなしでの性能推定に強みがあり、正解データの取得が遅れる本番環境で品質劣化の兆候を先行して捉える用途に向いています。
クラウド運用が中心の場合はAmazon SageMaker Model Monitorの選択肢もありますが、公式ドキュメントには新規顧客向けアクセスが2026年7月30日で終了する旨の注記があるため、新規導入を検討する際は最新情報を公式ドキュメントで確認したうえで判断する必要があります。
選定の軸は、既存のMLOps基盤との統合コストと、必要な指標(BLEU・ROUGE・BERTScoreなど)を計算するパイプラインとの接続性です。すでにPrometheusでシステムメトリクスを収集している組織では、評価指標をエクスポートしてPromQLで閾値監視する構成が運用の一体化に適しています。逆に指標計算からドリフト検知まで一括で扱いたい場合は、EvidentlyやNannyMLのようなML特化ツールを優先する方が導入負荷を抑えられます。
品質劣化を検知するアラート設定と閾値決定

評価指標の数値は日々変動するため、単純な閾値監視では誤検知が発生しやすくなります。統計的異常検知でノイズと実質的な劣化を区別し、閾値の設定根拠と運用ルールを整えることで、アラートの精度と対応速度を両立できます。
品質低下の検知方法(統計的異常検知)
BLEUやBERTScoreのスコアが週ごとにわずかに下がり続けているとき、それは一時的なノイズなのか、モデルの実質的な劣化なのか、どう見分ければよいでしょうか。現場ではこの判断に迷い、アラートを鳴らすべきか静観すべきか結論を出せないまま放置してしまうケースがしばしば見られます。
統計的異常検知は、この判断を人の感覚ではなく数値基準に委ねる手法です。代表的な方法は次の3つです。
- 移動平均と標準偏差を用いた管理図(過去N日の平均から標準偏差の一定倍以上外れた値を異常とみなす)
- 分布の変化を検知するドリフト検定(入力データや出力スコアの分布が過去の基準分布と統計的に異なるかを検定する)
- 時系列予測モデルによる残差監視(予測値と実測値の差が閾値を超えた時点をアラート対象とする)
Evidently やNannyMLはこうしたドリフト検出を標準機能として備えており、入力プロンプトの分布変化と出力スコアの劣化を分けて可視化できる点が実装上の利点です。たとえば入力側の話題が急に変わった場合は、モデル自体の劣化ではなく利用状況の変化である可能性が高く、対応の優先度は下がります。一方で入力分布が安定しているにもかかわらずBERTScoreが継続的に低下している場合は、モデルやプロンプトテンプレートの劣化を疑う根拠になります。このように検知結果は単独で判断せず、入力側と出力側の変化を組み合わせて解釈することが、誤報を減らす実務上のポイントです。
アラート閾値の設定と運用ルール
判断軸: 閾値は固定値ではなく、統計的異常検知で得たベースラインからの偏差で設定します。
前節で扱った変化点検知や外れ値スコアは、そのまま通知に使うと誤報が増えます。BERTScore や ROUGE の平均値が過去の移動平均から標準偏差を大きく超えて低下した場合に警告、さらに大きく超えた場合に緊急通知とする二段階構成が実務的です。閾値を一段階しか設けない場合、軽微な変動でも緊急対応が発生し、アラート疲れを招きます。
運用ルールは以下の観点で文書化します。
- 通知先の分岐: 警告レベルは開発チームのチャットへ、緊急レベルは QA 責任者へ直接通知する
- 確認手順: アラート発生時にサンプル出力を人手で確認し、指標低下が実際の品質劣化か、評価用データセットの偏りによる誤検知かを判別する
- 閾値の再学習: モデル更新やプロンプト変更を行った際は、ベースラインを再計算し閾値を更新する。更新を忘れると、改善後の出力が誤って劣化と判定される
Prometheus の PromQL でこの二段階アラートをルール定義しておくと、通知先やしきい値の変更が設定ファイルの修正だけで完了し、運用担当者の負担を抑えられます。閾値は一度決めて終わりではなく、定期的に見直す運用が実態に合います。
生成AI出力品質の監視ツール比較表

既存のMLOps基盤があるかどうかで選択肢は分かれます。統計的なドリフト検出だけを軽量に導入したいならOSS、LLM出力のトレーサビリティやチーム間のコラボレーションまで求めるなら統合プラットフォーム、AWS環境内で完結させたいならクラウド組込み型が向いています。
| 比較対象 | 評価軸 | 判断ポイント |
|---|---|---|
| Evidently | ドリフト検出・OSSの柔軟性 | コード実装の自由度が高く、既存パイプラインへの組み込みコストが低い |
| NannyML | 性能推定・ラベル遅延対応 | 正解ラベルが遅れて届く運用でも劣化を推定できる点が強み |
| Weights & Biases | 実験トラッキング・可視化 | LoRA や PEFT を用いたファインチューニングの実験管理と評価ログを一元化しやすい |
| Arize | LLM観測性・ルートコーズ分析 | 本番トラフィックの異常検知から原因特定までの導線が整っている |
| Amazon SageMaker Model Monitor | クラウド統合・運用の一体化 | AWS 環境内での運用に適するが、新規顧客向けアクセス終了の注記があるため導入前に公式ドキュメントを確認すること |
| Prometheus | メトリクス収集・アラート基盤 | 評価指標をPromQLで時系列管理し、既存の監視基盤と統合したい場合に有効 |
選定時は、指標計算の頻度・保存期間・アラート連携先が既存の運用フローと噛み合うかを事前に確認してください。ライセンス条件や料金は変更される場合があるため、最新の公式ドキュメントで確認することを推奨します。
生成AIモデルの出力品質評価でよくある質問

自動評価指標の運用でよく寄せられる質問を、指標選定・アラート設計・原因分析の3観点からまとめました。実装時の判断材料として活用してください。
自動評価指標だけで十分か、人手評価は必要か
自動評価指標だけを回し続ければ、本当に品質は守れるのでしょうか。
答えは条件によって変わります。BLEU・ROUGE・BERTScoreは文字列や意味の一致度を数値化しますが、事実の正確性や文脈の妥当性、有害表現の有無までは判定できません。参照文と表面的に似ているのに内容が誤っている出力を高スコアと誤判定するケースは、要約や質問応答タスクで報告されています。
そのため、実務では二段構えが基本になります。日常的な監視は自動評価指標でカバーし、スコアが閾値を下回った出力や、ユーザーからの指摘が集中した出力だけを人手評価に回す設計です。この抽出作業自体を自動化すれば、全件人手評価に比べて確認対象を大幅に絞り込めます。
一方で、医療・金融・法務など誤りの影響が大きい領域では、自動評価指標の結果に関わらず一定割合を定期的に人手でレビューする運用が推奨されます。RAG(Retrieval-Augmented Generation)構成で参照文書との整合性が問題になる場合は、Adaptive RAGとは?クエリ主導の動的検索でコストと精度を両立する方法で紹介する検索精度の見直しも合わせて検討する価値があります。自動評価指標は監視の入口であり、最終判断を完全に代替するものではないと理解しておくことが重要です。
どの評価指標を優先して監視すべきか
判断軸: タスク種別と出力の自由度で優先指標は変わり、複数指標の併用が有効です。
- 参照文がある要約・翻訳: ROUGE・BLEUを起点にBERTScoreを補助追加
- 自由度の高い対話生成: BERTScoreを主指標、語彙一致は補助
- 事実性が問われる質問応答
品質劣化の原因は何か、どう対応するか
入力データの傾向が変化した場合はデータドリフトが原因、モデル自体や依存API が更新された場合はモデルドリフトが原因である可能性が高く、原因の切り分けが対応の第一歩になります。データドリフトは「同じレシピで作っても食材の産地が変われば味が変わる」ような現象で、ユーザーの質問傾向や参照文書の内容が徐々にシフトすることでBLEUやBERTScoreの基準値からのずれが生じます。
一方でモデルドリフトは、外部APIのモデル更新やファインチューニング済みモデルの再学習によって出力の傾向そのものが変わるケースです。この場合は評価スコアの低下パターンが急激であることが多く、直近のデプロイ履歴やAPIのバージョン変更ログと照合すると原因を特定しやすくなります。
対応の優先順位は、まず再現性の確認です。同一入力を再実行してもスコアが低いままなら、モデルやプロンプトテンプレート側の変化を疑い、入力を変えると結果が安定する場合はデータ側の変化を疑います。RAG構成であれば、ベクトルデータベースの検索結果が劣化している可能性もあるため、グラウンディングチェックで検索精度を個別に検証することが有効です。原因が特定できたら、プロンプトのロールバックや検索インデックスの再構築など、影響範囲を絞った修正から着手すると復旧までの時間を短縮できます。
生成AI出力品質の自動測定を始める手順

自動測定体制の構築は、指標選定からアラート運用まで段階的に進めると失敗が少なくなります。まず現状のタスク種別(要約・翻訳・質問応答など)を洗い出し、BLEU・ROUGE・BERTScoreのうちタスクに適した指標を1〜2種類選びます。次に、評価スクリプトを推論パイプラインに組み込み、出力ログとスコアを自動保存する仕組みを整えます。
続いて、EvidentlyやNannyMLなどの監視ツールを導入し、スコアの時系列変化を可視化します。この段階で品質劣化を検知する閾値を仮設定し、実運用データで数週間分の傾向を観察してから本番のアラート閾値を確定させると、初期の誤検知を抑えられます。
最後に、アラート発火時の対応フロー(再学習・プロンプト修正・人手レビューへの切り替えなど)を運用ルールとして文書化します。HITL の設計を検討している場合は、ヒューマン・イン・ザ・ループ(HITL)とは?AIで業務自動化を定着させる「人間参加型」設計の基礎も参考になります。
この一連の手順を、指標選定・パイプライン組み込み・監視ツール導入・閾値調整・運用ルール文書化という5段階で進めることで、人手評価に依存しない継続的な品質監視体制を構築できます。
参考文献
- 一次情報(aclanthology.org)閲覧日 2026年8月6日
- 一次情報(aclanthology.org)閲覧日 2026年8月6日
- 一次情報(docs.aws.amazon.com)閲覧日 2026年8月6日
- 一次情報(itl.nist.gov)閲覧日 2026年8月6日
- 一次情報(dataplatform.cloud.ibm.com)閲覧日 2026年8月6日
- 一次情報(digiarc.aist.go.jp)閲覧日 2026年8月6日
- 一次情報(jmp.com)閲覧日 2026年8月6日
- 一次情報(oecd.org)閲覧日 2026年8月6日
- 一次情報(aclanthology.org)閲覧日 2026年8月6日
- 一次情報(docs.evidentlyai.com)閲覧日 2026年8月6日
- 一次情報(huggingface.co)閲覧日 2026年8月6日
- 一次情報(aclanthology.org)閲覧日 2026年8月6日
- 一次情報(airc.nist.gov)閲覧日 2026年8月6日
- 一次情報(aclanthology.org)閲覧日 2026年8月6日
- 一次情報(ai.google.dev)閲覧日 2026年8月6日
- 一次情報(arxiv.org)閲覧日 2026年8月6日
- 一次情報(prometheus.io)閲覧日 2026年8月6日
- 一次情報(docs.aws.amazon.com)閲覧日 2026年8月6日
- 一次情報(prometheus.io)閲覧日 2026年8月6日
- 一次情報(site.wandb.ai)閲覧日 2026年8月6日
著者・監修者

Yusuke Ishihara
13歳でMSXに触れプログラミングを開始。武蔵大学卒業後、航空会社の基幹システム開発や日本初のWindowsサーバホスティング・VPS基盤構築など、大規模システム開発に従事。 2008年にサイトエンジン株式会社を共同創業。2010年にユニモン株式会社、2025年にエニソン株式会社を設立し、業務システム・自然言語処理・プラットフォーム開発をリード。 現在は生成AI・大規模言語モデル(LLM)を活用したプロダクト開発およびAI・DX推進を手がける。
おすすめ記事


この記事に関連する用語

AIオブザーバビリティ(AI Observability)
本番稼働中のAIシステムの入出力・レイテンシ・コスト・品質を継続的に監視・可視化する運用プラクティス。ハルシネーションやドリフトの早期検出に不可欠。
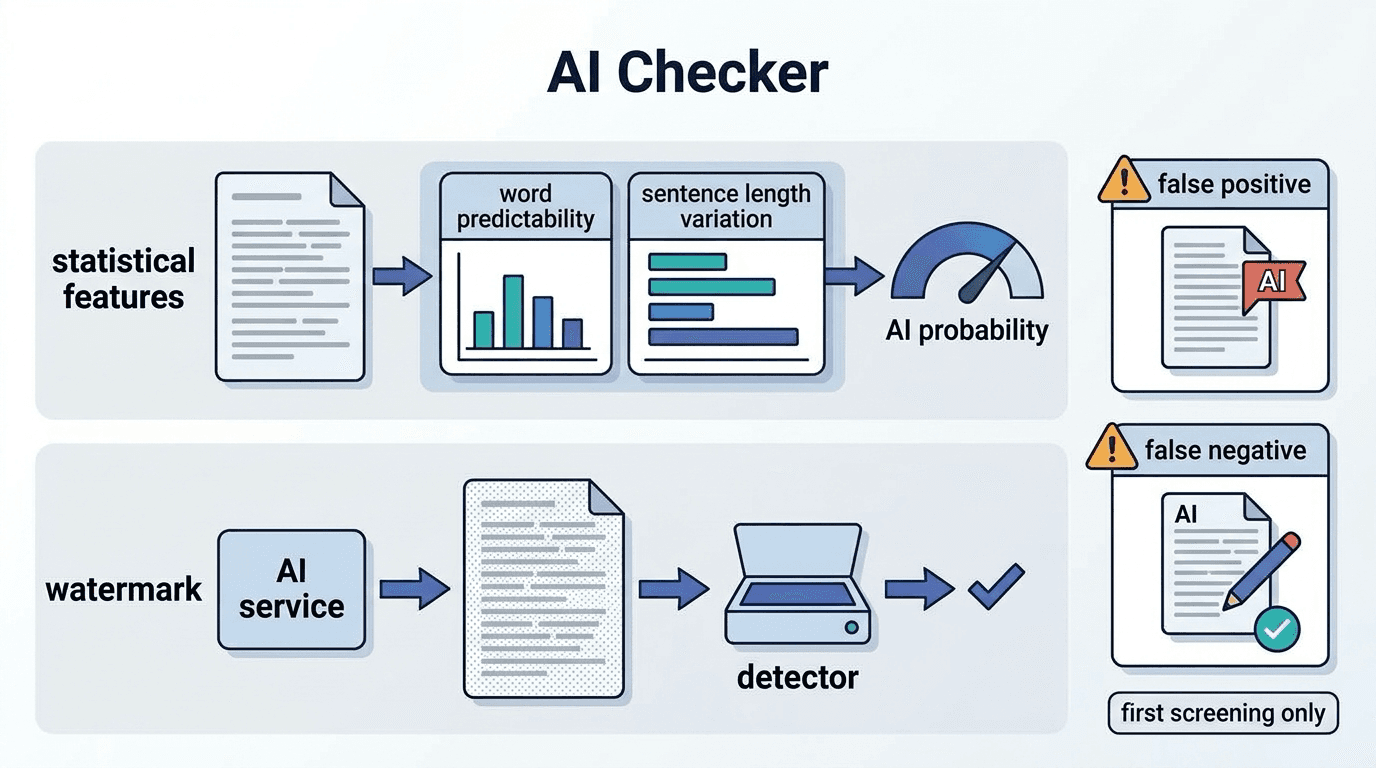
AI チェッカー(AI 生成文章判定ツール)
AI チェッカーとは、文章が AI によって生成されたかどうかを統計的な特徴などから推定するツールの総称で、判定には誤りが含まれるため単独の根拠にしない運用が前提になる。
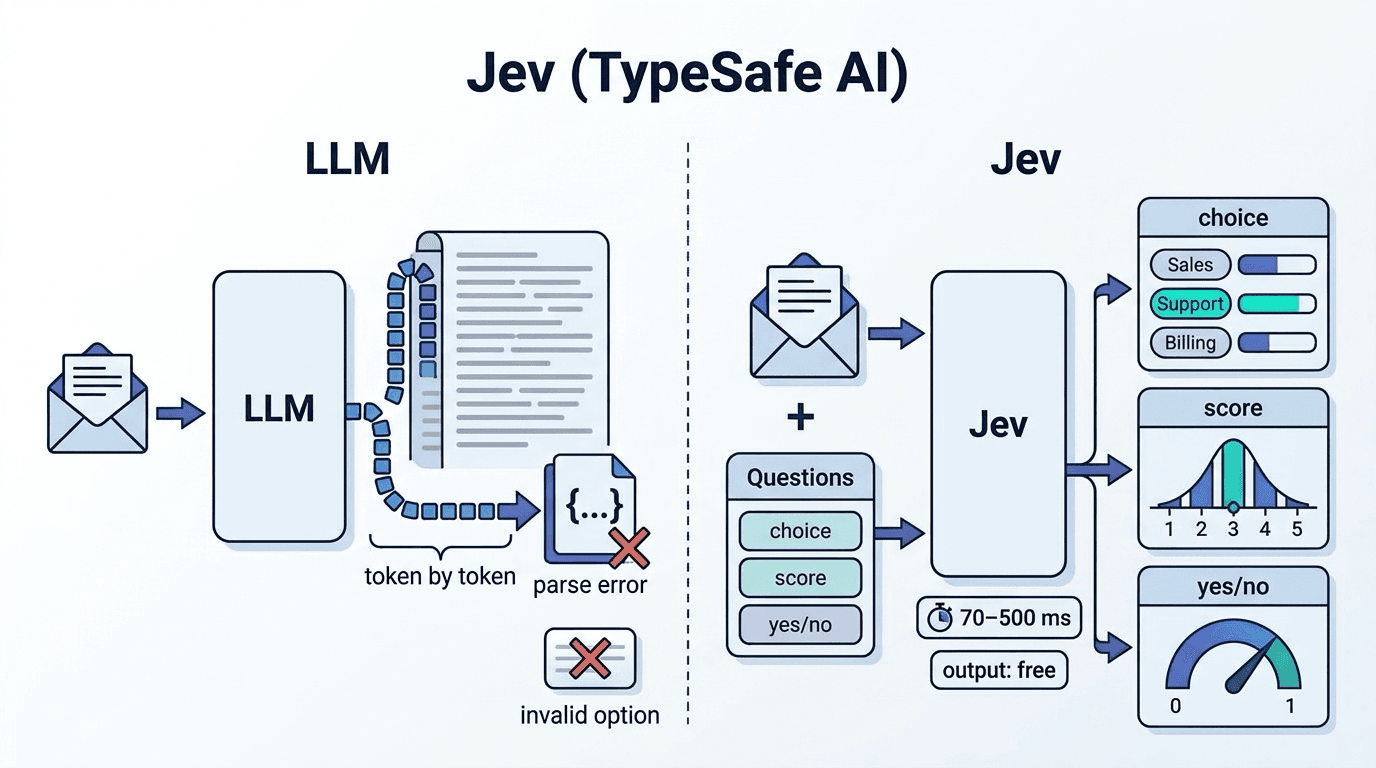
Jev(TypeSafe AI)
Jev とは、TypeSafe AI が開発した判断専用の AI モデルで、文章を生成せず、あらかじめ決めた選択・段階評価・真偽の判断を確率付きで返す「System One モデル」である。