LoRA
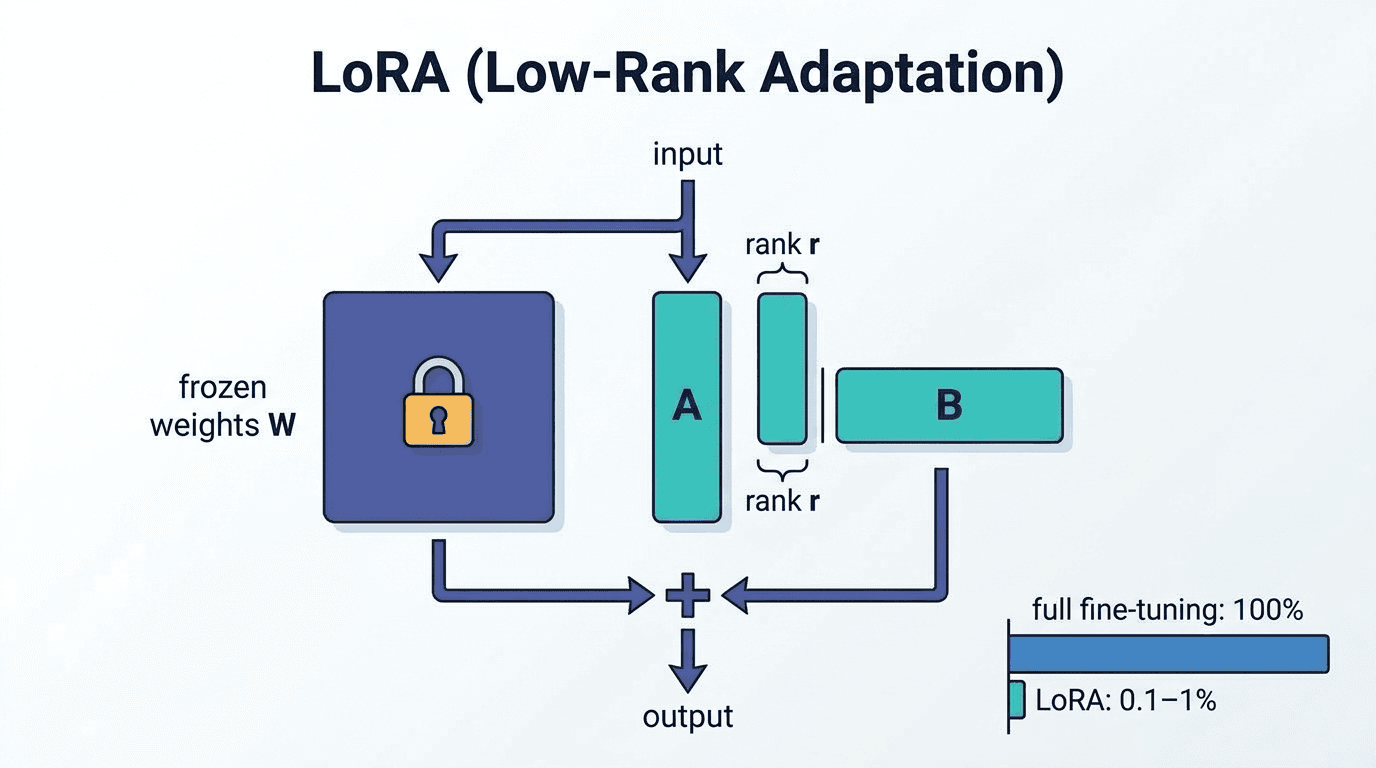
LoRA (Low-Rank Adaptation) คือวิธีการที่แทรกเมทริกซ์ผลต่างแบบ low-rank เข้าไปในเมทริกซ์น้ำหนักของโมเดลภาษาขนาดใหญ่ และทำการเรียนรู้เฉพาะส่วนผลต่างนั้น ซึ่งช่วยให้สามารถทำ fine-tuning ได้โดยเพิ่มพารามิเตอร์เพียงประมาณ 0.1–1% ของโมเดลทั้งหมด
LoRA มีโครงสร้างที่เพิ่มผลคูณของเมทริกซ์ rank ต่ำ A×B เข้าไปยังเมทริกซ์น้ำหนัก W ในแต่ละชั้นของ Transformer โดยที่น้ำหนักเดิม W จะถูกตรึงไว้ และเรียนรู้เฉพาะ A กับ B ที่เพิ่มเข้ามาเท่านั้น ทำให้จำนวน parameter ที่ต้องเรียนรู้อยู่ที่ประมาณ 0.1〜1% ของโมเดลทั้งหมด โดยทั่วไปจะกำหนดค่า rank r ไว้ที่ประมาณ 4〜64 ซึ่งยิ่ง r มีค่าน้อย จำนวน parameter ก็จะลดลง แต่จะเกิด trade-off กับความสามารถในการแสดงออก
ในด้านการนำไปใช้งาน ไลบรารี PEFT ของ Hugging Face และ Unsloth ได้รับความนิยมอย่างแพร่หลาย และสามารถผสานเข้ากับ pipeline การเรียนรู้ที่มีอยู่เดิมได้ด้วยการเพิ่มโค้ดเพียงไม่กี่บรรทัด LoRA adapter ที่ผ่านการเรียนรู้แล้วสามารถบันทึกเป็นไฟล์แยกต่างหากจากโมเดลหลัก (ขนาดประมาณหลักสิบ MB) และสามารถสลับ adapter ตามแต่ละ task ได้ ทำให้ใช้ base model เดียวกันสำหรับหลายวัตถุประสงค์ได้ หากมี GPU memory เพียงพอ ยังสามารถ merge adapter เข้ากับ base model เพื่อรักษาความเร็วในการ inference ได้อีกด้วย
ในสภาพแวดล้อมของผู้เขียน ค่า r=16 ให้ความสมดุลระหว่างความแม่นยำและประสิทธิภาพได้ดีสำหรับ task ส่วนใหญ่ จึงมักใช้เป็นค่าตั้งต้น
อย่างไรก็ตาม ความสามารถที่โมเดลไม่มีอยู่เดิม เช่น การเพิ่มภาษาที่ยังไม่รองรับ นั้นเป็นเรื่องยากที่จะได้มาด้วย LoRA เพียงอย่างเดียว ในกรณีดังกล่าวจำเป็นต้องใช้ร่วมกับ continual pre-training
บทความที่กล่าวถึงคำศัพท์นี้
- วิธีเลือกใช้ Fine-tuning และ RAG: คู่มือเปรียบเทียบตามต้นทุน ความแม่นยำ และการใช้งานจริงเลือกใช้ Fine-tuning หรือ RAG ดี? เปรียบเทียบ 4 ปัจจัยหลัก (ต้นทุน, ความแม่นยำ, การอัปเดต, ความปลอดภัย) พร้อมเกณฑ์การเลือกที่เหมาะสมกับธุรกิจคุณ
- คู่มือเริ่มต้นการทำ Fine-tuning: พื้นฐานและเกณฑ์การตัดสินใจสำหรับองค์กร B2B ก่อนสร้าง LLM ของตนเองอธิบายกลไก Fine-tuning ตั้งแต่พื้นฐาน ความสัมพันธ์กับ PEFT/LoRA การเลือกใช้ร่วมกับ RAG การคำนวณต้นทุน และเช็คลิสต์สำหรับธุรกิจ B2B ในการพัฒนาโมเดลเอง
- SLM Distillation คืออะไร? วิธีสร้างโมเดลขนาดเล็กเฉพาะทางจาก LLM ขนาดใหญ่เรียนรู้วิธีสร้าง SLM Distillation เพื่อพัฒนาโมเดลขนาดเล็กเฉพาะทางด้วยต้นทุนต่ำ โดยใช้ LLM ขนาดใหญ่เป็นครู พร้อมอธิบายกลไกและขั้นตอนการใช้งานจริง
- PEFT (Parameter-Efficient Fine-Tuning) คืออะไร? เทคนิคลดต้นทุนการปรับแต่ง AI Model ได้ถึง 90%อธิบาย PEFT (Parameter-Efficient Fine-Tuning) และวิธีหลัก (LoRA, QLoRA, Adapter) สำหรับผู้บริหาร พร้อมกรณีศึกษา GPU และแนวทางตัดสินใจลงทุน


คำศัพท์ที่เกี่ยวข้อง
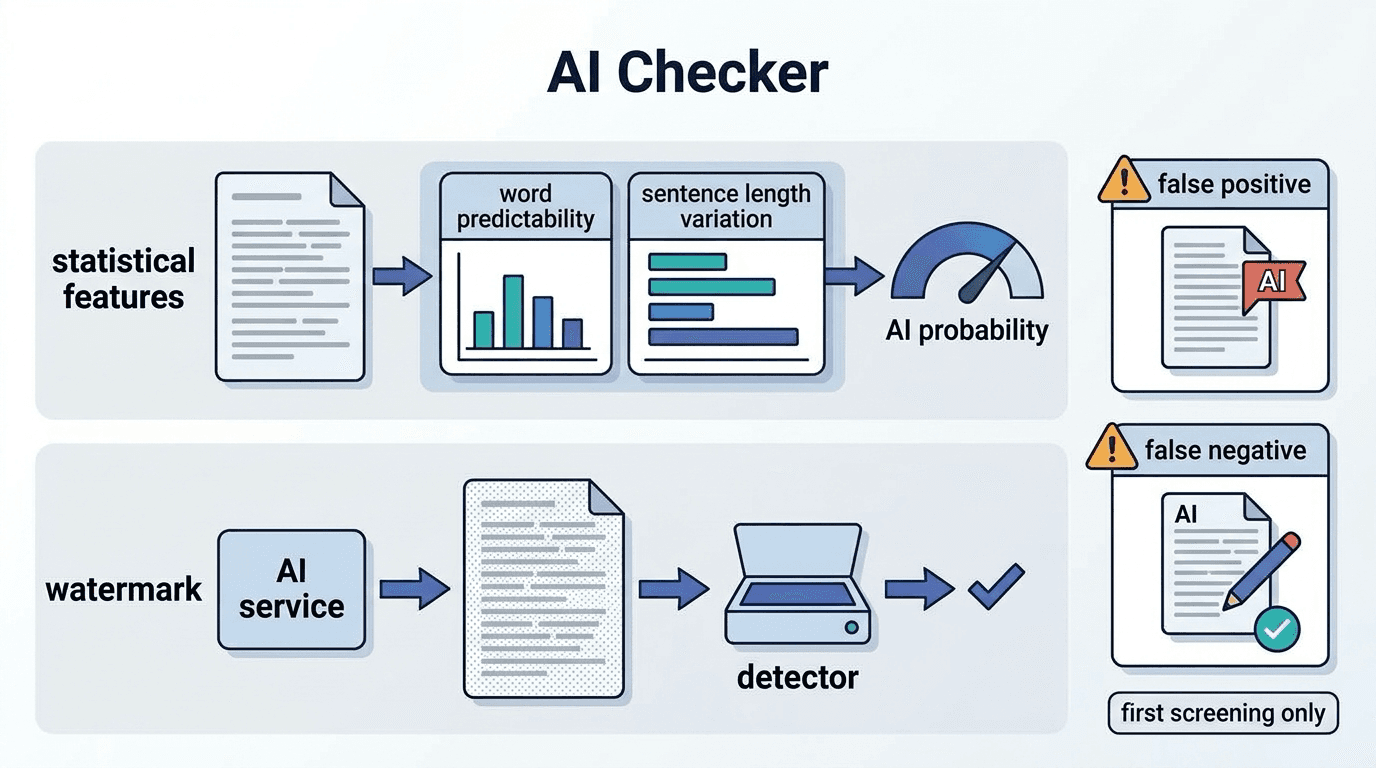
AI Checker (เครื่องมือตรวจข้อความที่สร้างด้วย AI)
AI Checker คือเครื่องมือที่ประเมินว่าข้อความถูกเขียนโดย AI หรือไม่ จากลักษณะทางสถิติของข้อความ ผลตรว
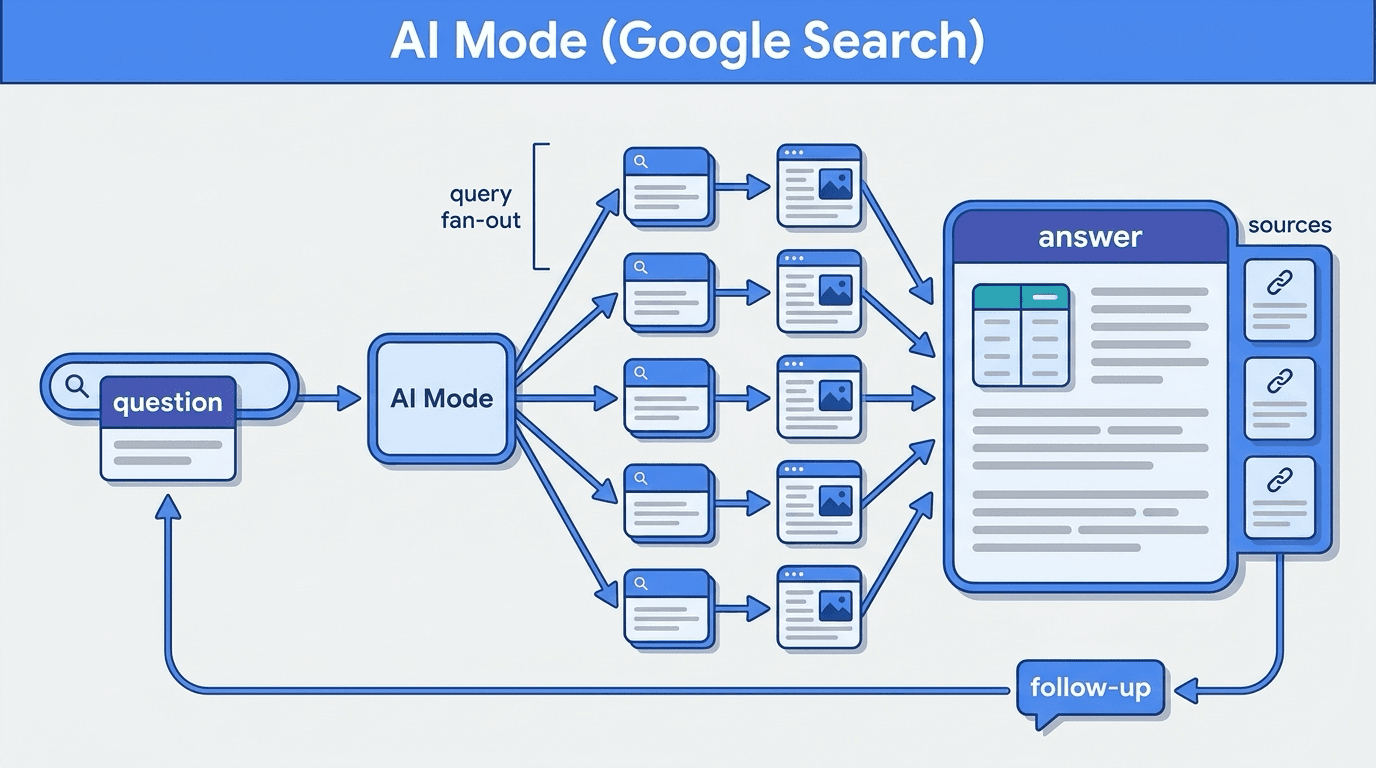
AI Mode (โหมด AI ของ Google)
AI Mode คือโหมดการค้นหาของ Google ที่ใช้ Generative AI ตอบคำถามแบบสนทนา สรุปคำตอบพร้อมลิงก์แหล่งที่ม
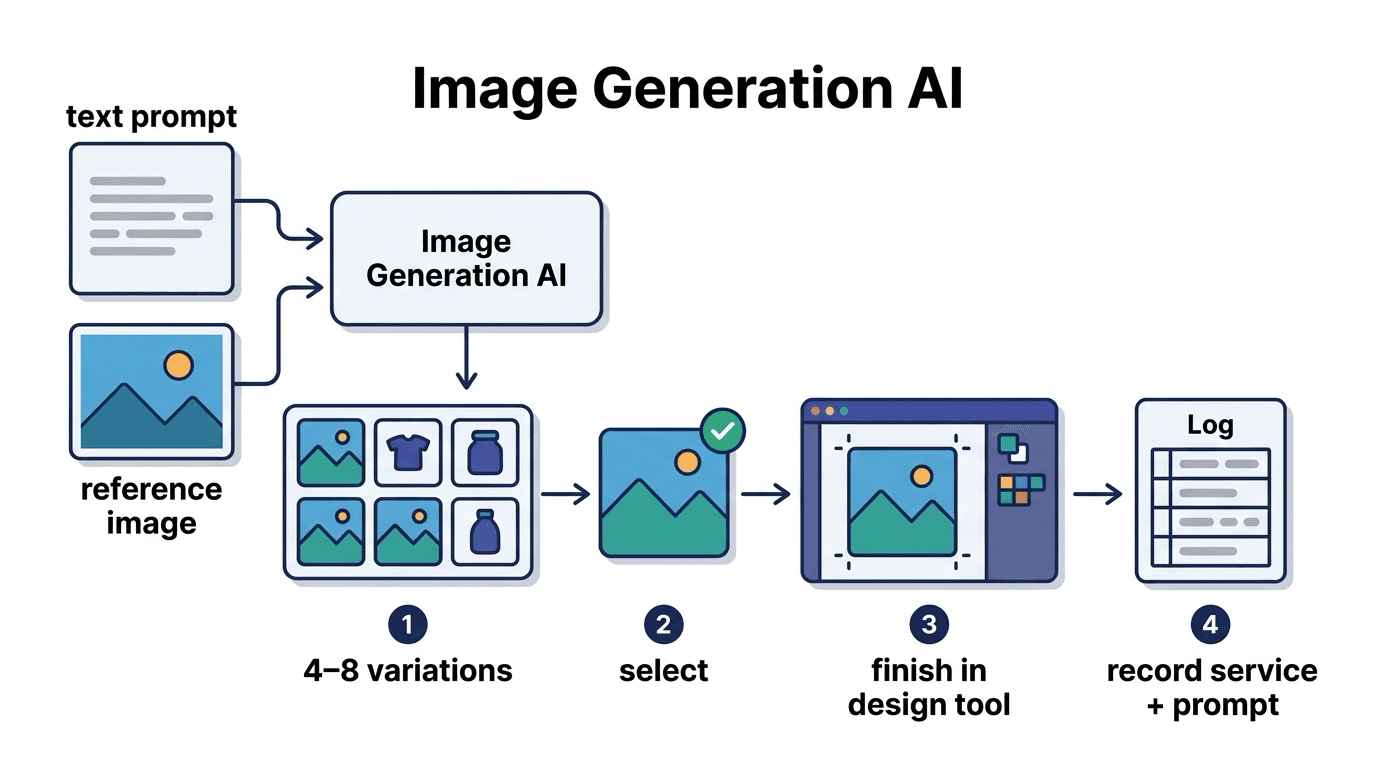
AI สร้างภาพ (Image Generation AI)
AI สร้างภาพ คือ Generative AI ที่สร้างภาพใหม่จากคำสั่งข้อความหรือภาพอ้างอิง ใช้ผลิตสื่อโฆษณา เอกสาร
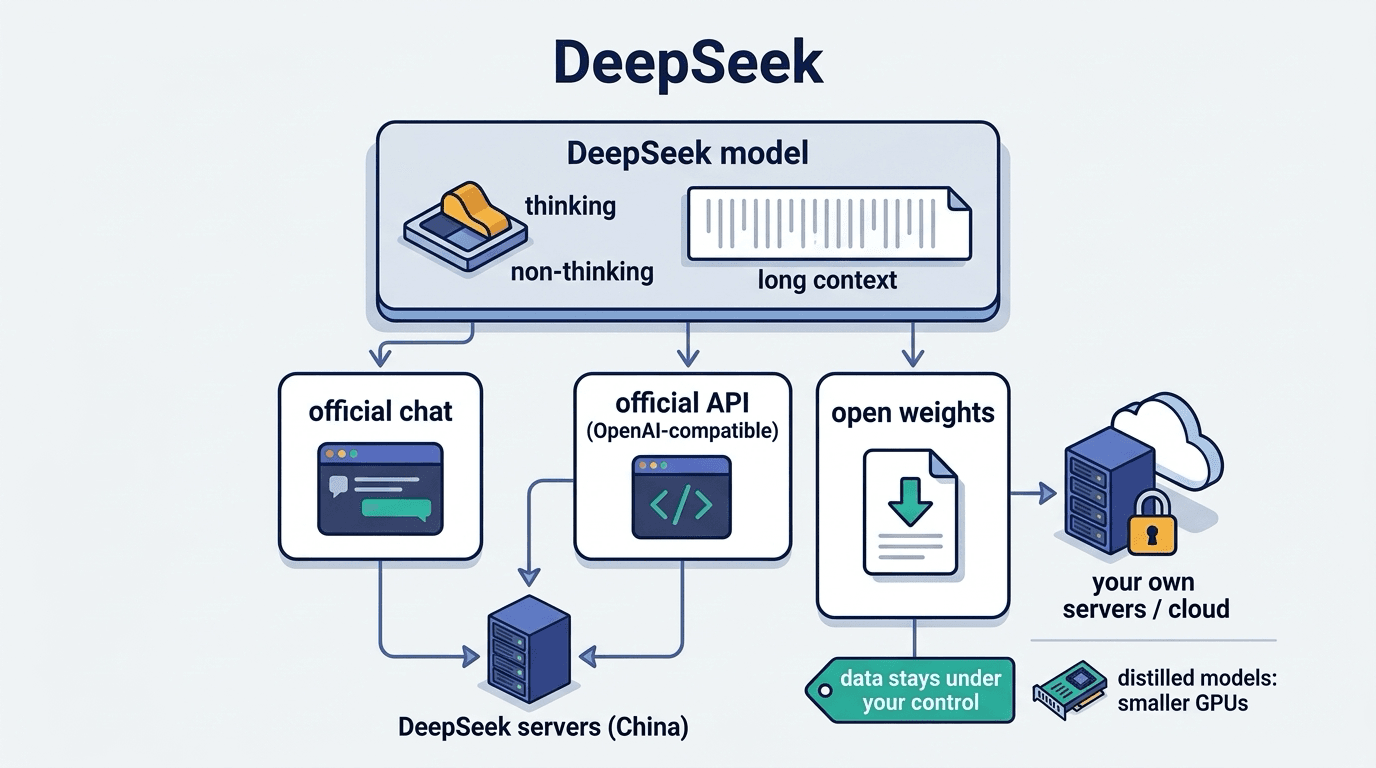
DeepSeek
DeepSeek คือโมเดลภาษาขนาดใหญ่และบริการแชทที่พัฒนาโดยบริษัท DeepSeek ของจีน จุดเด่นคือเปิดเผยน้ำหนักโ