ฟีเจอร์สโตร์ (Feature Store)
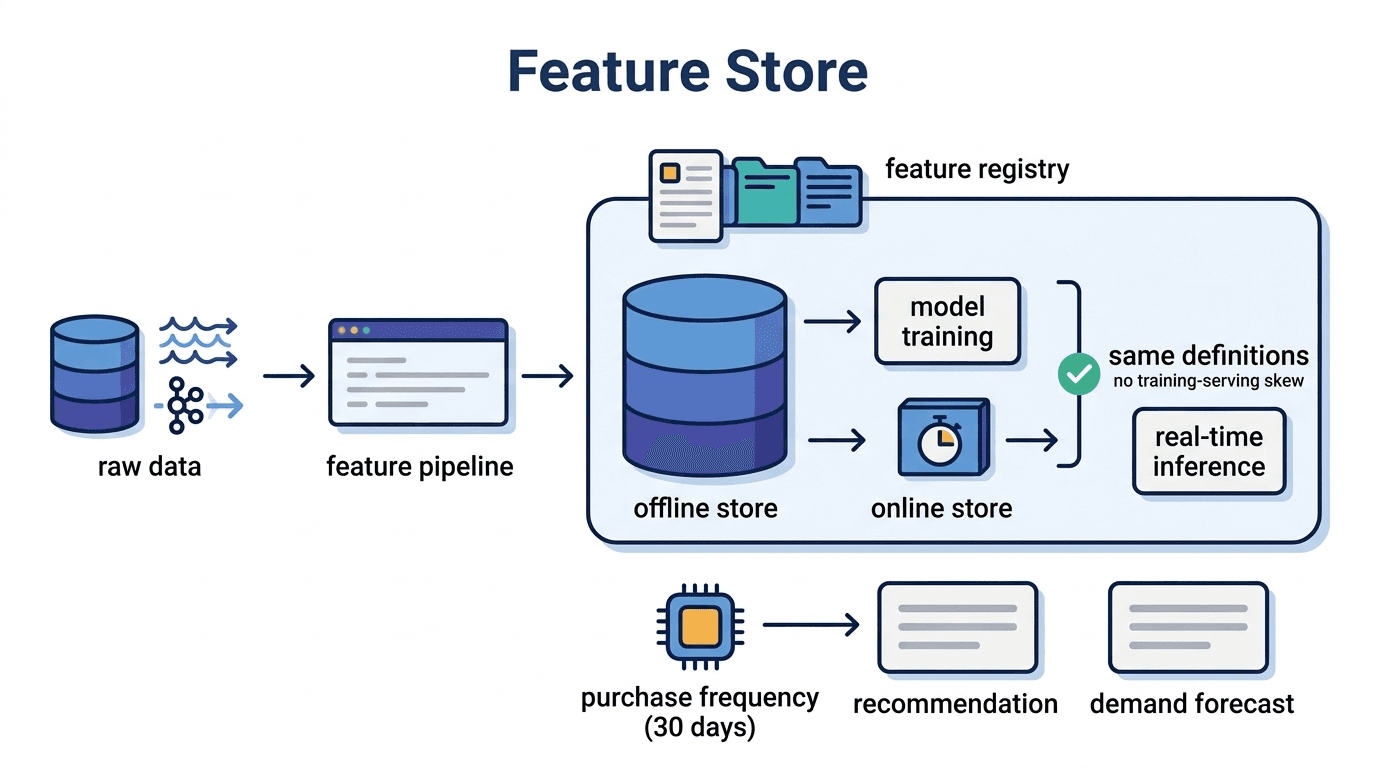
Feature Store คือโครงสร้างพื้นฐานข้อมูลที่ใช้สำหรับจัดการและนำ Feature ที่ใช้ในการเทรนและอนุมาน (Inference) ของโมเดล Machine Learning มาใช้ซ้ำได้จากศูนย์กลาง ช่วยลดการทำงานที่ซ้ำซ้อนในการพัฒนาโมเดล และรับประกันความสอดคล้องของ Feature ระหว่างสภาพแวดล้อมการพัฒนาและสภาพแวดล้อมการใช้งานจริง (Production)
Feature Store (ฟีเจอร์สโตร์) คือโครงสร้างพื้นฐานข้อมูลสำหรับจัดการ Feature (คุณลักษณะ) ที่ใช้ในการเทรนและการอนุมานของโมเดล Machine Learning ไว้ที่ศูนย์กลาง และนำกลับมาใช้ซ้ำได้ ทำหน้าที่ลดงานซ้ำซ้อนในการพัฒนาโมเดล และรับประกันว่า Feature ในสภาพแวดล้อมการเทรนกับสภาพแวดล้อมการใช้งานจริงสอดคล้องกัน
ทำไมต้องมี Feature Store
เมื่อโปรเจกต์ Machine Learning ในองค์กรเพิ่มขึ้น มักเกิดความสิ้นเปลืองที่ทีมหนึ่งต้องสร้าง Feature ซ้ำกับที่อีกทีมสร้างไว้แล้ว เช่น Feature "ความถี่ในการซื้อของผู้ใช้ในช่วง 30 วันล่าสุด" อาจถูกใช้ทั้งในโมเดลแนะนำสินค้าและAI พยากรณ์ความต้องการ Feature Store เก็บ Feature เหล่านี้เป็นสินทรัพย์ร่วม และเปิดให้ใช้ซ้ำข้ามทีมได้
อีกปัญหาสำคัญคือข้อมูลไม่สอดคล้องกันระหว่างการเทรนกับการอนุมาน หรือที่เรียกว่า "Training-Serving Skew" กรณีที่ตรรกะการคำนวณ Feature ตอนเทรนกับตอนอนุมานจริงต่างกันเล็กน้อย จนความแม่นยำของโมเดลไม่เป็นไปตามที่ทดสอบไว้ เกิดขึ้นได้บ่อย Feature Store แก้ปัญหานี้ในระดับโครงสร้าง
กลไกทางเทคนิค
โดยทั่วไป Feature Store ประกอบด้วยองค์ประกอบต่อไปนี้
- Offline Store: พื้นที่จัดเก็บสำหรับการประมวลผลแบบ Batch ที่เก็บข้อมูลจำนวนมากสำหรับการเทรน (มักใช้ Data Warehouse หรือ Object Storage)
- Online Store: ชั้นแคชที่มีความหน่วงต่ำ สำหรับดึง Feature แบบเรียลไทม์ตอนอนุมาน (ตัวอย่างทั่วไปคือ Redis หรือ DynamoDB)
- Feature Pipeline: กระบวนการคำนวณและอัปเดต Feature จากข้อมูลดิบ
- Feature Registry: แคตตาล็อกที่จัดการนิยาม เมทาดาทา และเวอร์ชันของ Feature
โครงสร้างสองชั้นแบบ Offline และ Online ทำให้รองรับความต้องการที่ขัดกันได้พร้อมกัน คือประมวลผลข้อมูลเทรนจำนวนมากได้อย่างมีประสิทธิภาพ และส่ง Feature กลับได้ภายในไม่กี่มิลลิวินาทีตอนอนุมานจริง
บทบาทใน MLOps
Feature Store เป็นองค์ประกอบหลักของไปป์ไลน์ MLOps ในบริบทของ MLOps ที่ดูแลการจัดการเวอร์ชันและการ Deploy โมเดล Feature ก็ถือเป็นผลงานที่ต้องจัดการเวอร์ชันเช่นเดียวกับโค้ด การติดตามที่มา (Lineage) ว่าโมเดลใดใช้ Feature ใดอยู่เมื่อมีการเปลี่ยน Feature ก็เป็นความสามารถที่สำคัญ
นอกจากนี้ เมื่อสถาปัตยกรรมที่อ้างอิงข้อมูลภายนอกตอนอนุมานอย่าง RAG และ AI Agent แพร่หลายขึ้น การออกแบบ Feature Store ที่คำนึงถึงความสดใหม่ของ Feature และการเชื่อมต่อกับฐานข้อมูลเวกเตอร์ก็ได้รับความสนใจมากขึ้น
ประเด็นที่ควรรู้ก่อนนำมาใช้
Feature Store ให้ผลชัดเจนในกรณีที่มีโมเดล ML หลายตัวอ้างอิงข้อมูลในโดเมนเดียวกัน หรือในหน้างานที่ต้องการ Feature แบบเรียลไทม์อย่างโรงงานอัจฉริยะ (Smart Factory) ในทางกลับกัน หากสร้าง Feature Store ขนาดใหญ่ตั้งแต่ยังมีโมเดลไม่กี่ตัว ต้นทุนการดูแลอาจสูงกว่าประโยชน์ที่ได้ แนวทางที่ทำได้จริงคือเริ่มจากการจัดการ Feature แบบง่ายในขั้น PoC แล้วค่อยพิจารณานำมาใช้เต็มรูปแบบเมื่อจำนวนโมเดลและทีมผู้ใช้เพิ่มขึ้น
ด้านความปลอดภัย การควบคุมสิทธิ์การเข้าถึงเป็นเรื่องท้าทายเมื่อ Feature มีข้อมูลส่วนบุคคล จากมุมมองของ AI Governance ควรกำหนดให้ชัดเจนว่าใครอ้างอิงหรืออัปเดต Feature ใดได้ และนำแนวคิด Shift Left มาใช้เพื่อรักษาคุณภาพข้อมูลตั้งแต่ช่วงต้นของไปป์ไลน์ ซึ่งจะนำไปสู่การดูแลระบบที่มั่นคงในระยะยาว
บทความที่กล่าวถึงคำศัพท์นี้
- --- กลยุทธ์การบริหารแบบ AI-Native คืออะไร? วิธีการออกแบบโมเดลธุรกิจใหม่ตั้งแต่รากฐาน ---จาก "การเพิ่ม AI" สู่ "การออกแบบใหม่ด้วย AI" เรียนรู้ขั้นตอนการเปลี่ยนผ่านสู่ AI-native, การเชื่อมต่อ ERP/FMS และกรณีศึกษาจากบริษัทญี่ปุ่นในไทย
- การออกแบบหน่วยความจำระยะยาวสำหรับ AI Agent — คู่มือการใช้งาน Persistent Memory, Memory Store และการค้นหาข้อมูลเจาะลึกการออกแบบ Long-term Memory สำหรับ AI Agent เพื่อรักษาบริบทข้ามงานและเซสชัน ครอบคลุมการเลือก Memory Store, การจัดการข้อมูล และการป้องกัน Memory Poisoning
- การจัดการบันทึกการอนุมาน LLM แบบรวมศูนย์: การสร้างความโปร่งใสในสภาพแวดล้อมการใช้งานจริงด้วย Converged Databaseเจาะลึกการใช้ Converged Database จัดการ LLM Inference Log จากหลายแหล่ง เพื่อเพิ่มประสิทธิภาพการตรวจจับความผิดปกติ พร้อมวิธีรวมศูนย์ข้อมูล Input/Output, Latency, Token และ Error


คำศัพท์ที่เกี่ยวข้อง
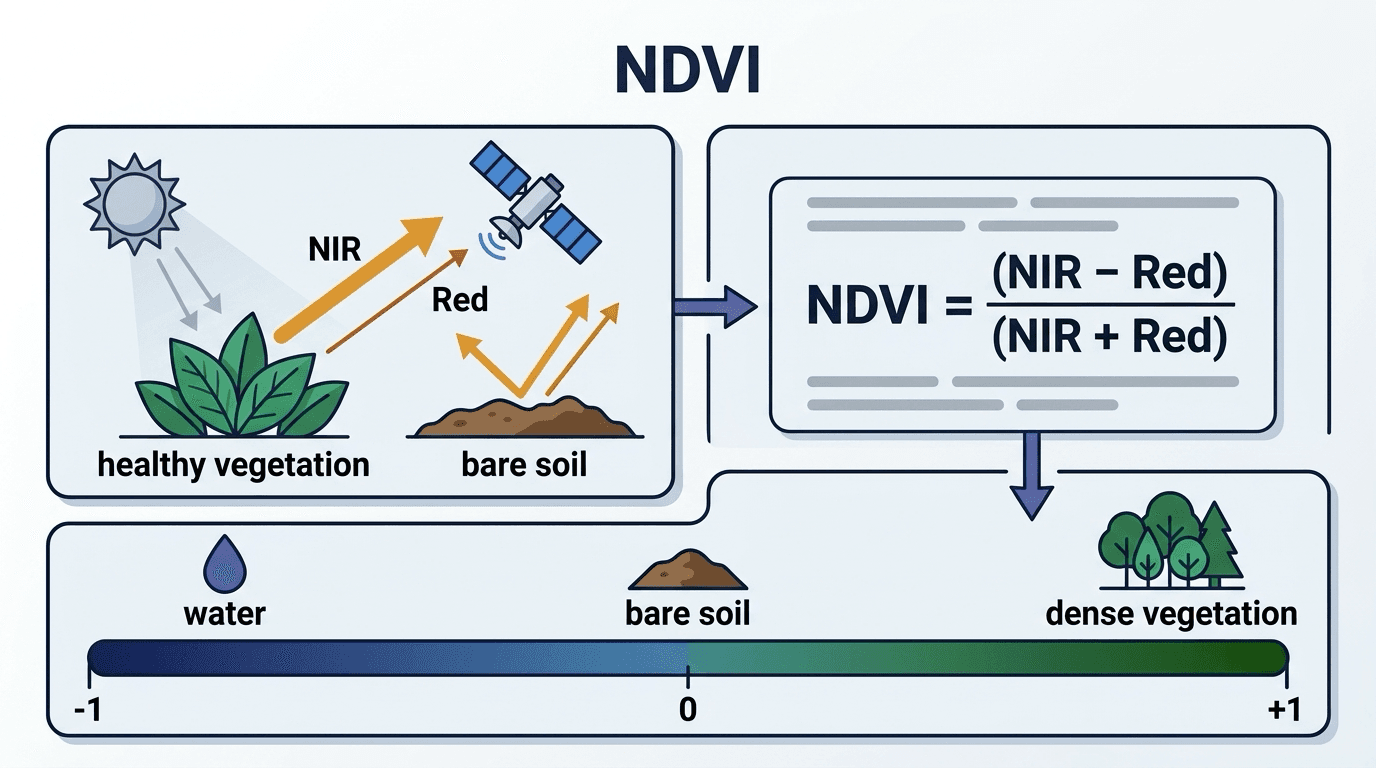
NDVI
NDVI (Normalized Difference Vegetation Index · ดัชนีพืชพรรณแบบนอร์มอลไลซ์) คือดัชนีที่ได้จากการนอร์ม
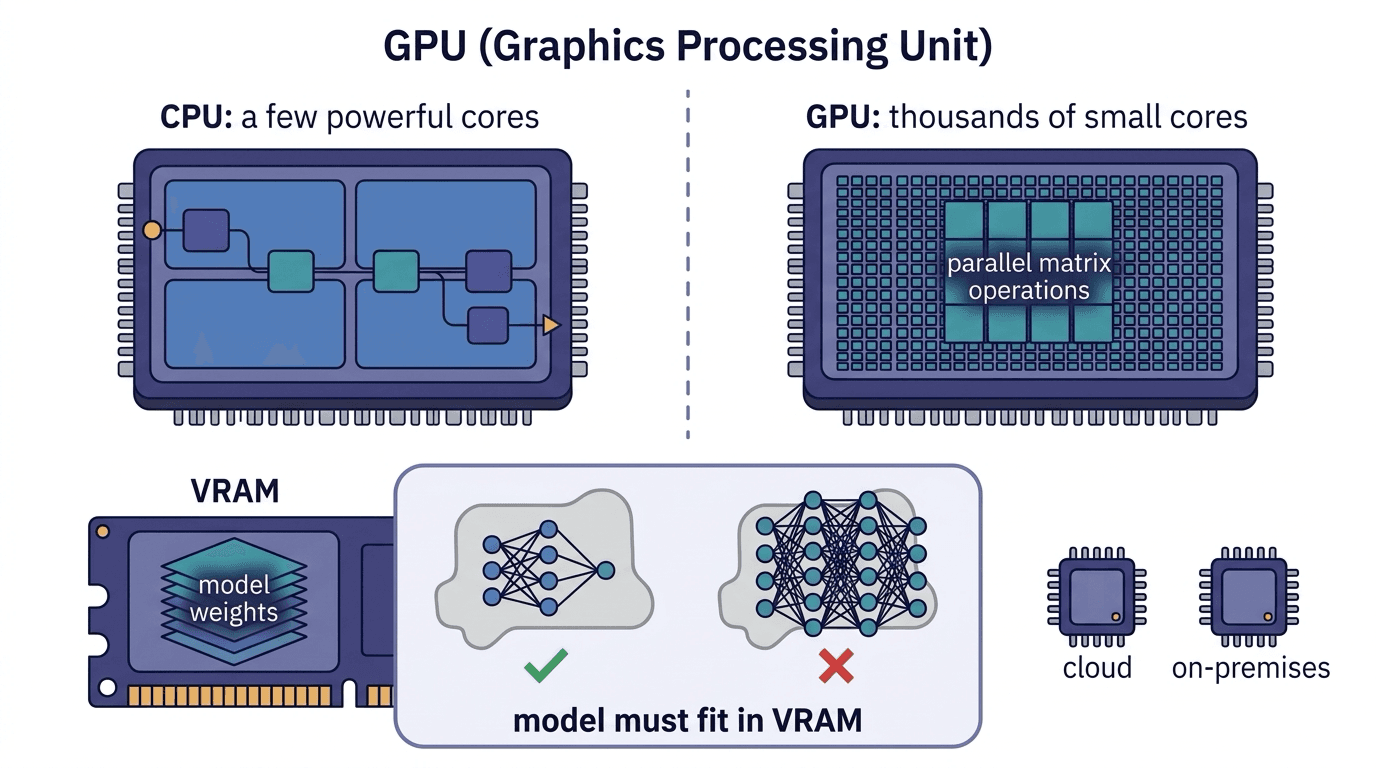
GPU(หน่วยประมวลผลกราฟิก)
GPU (Graphics Processing Unit) คือชิปเซมิคอนดักเตอร์ที่ประมวลผลการคำนวณแบบขนานจำนวนมากได้อย่างรวดเร็
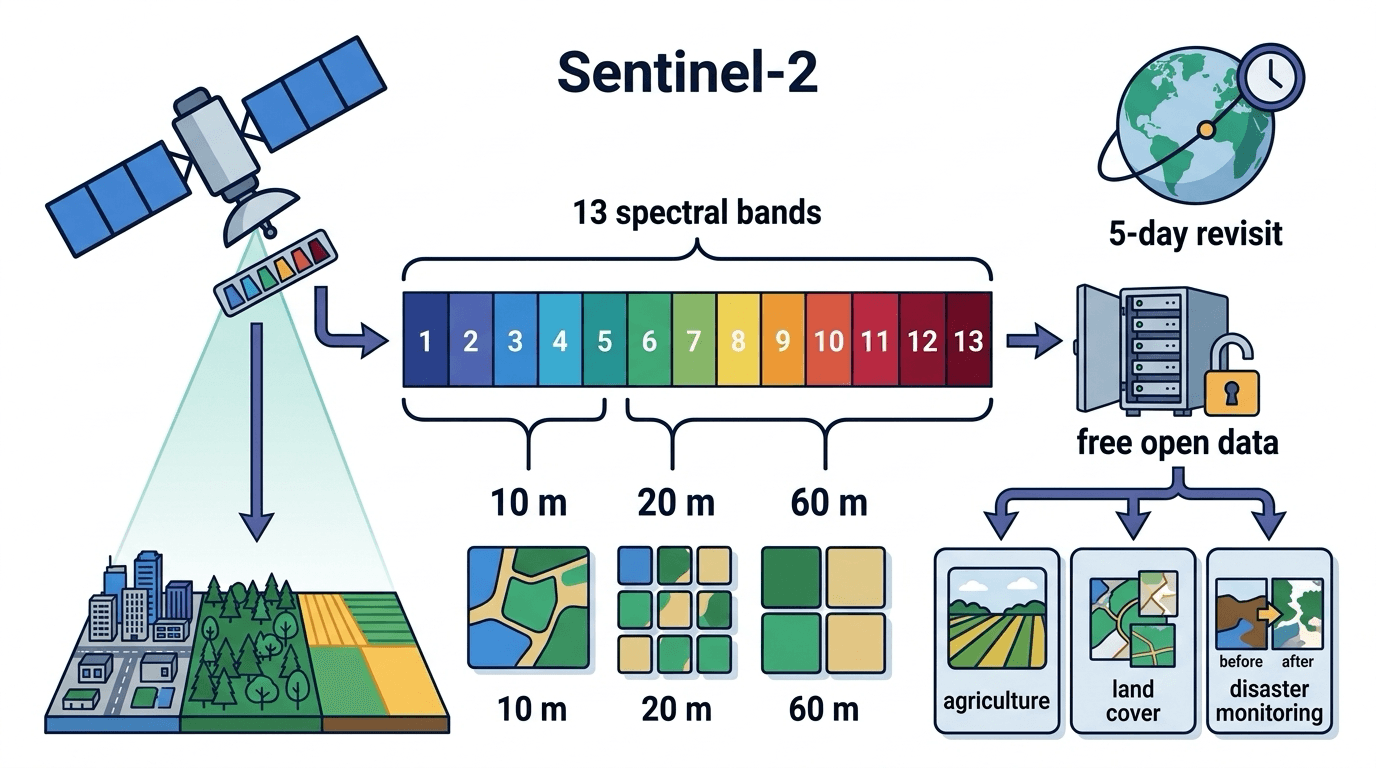
Sentinel-2
Sentinel-2 คือดาวเทียมสำรวจโลกในโครงการ Copernicus ที่นำโดย ESA (องค์การอวกาศยุโรป) ทำการบันทึกภาพ m

ประทัด
Firecracker คือ Virtual Machine Monitor (VMM) โอเพนซอร์สที่พัฒนาโดย AWS ซึ่งสามารถเริ่มต้น microVM ท